آیا میتوانیم Lock را تا پایان عملیات نگه داریم؟ تداخل بین عملیات نوشتن چقدر رایج است؟ و از دست رفتن یک عملیات نوشتن چه هزینهای دارد؟
مقدمه
Optimistic Locking در مقابل Pessimistic Locking، انتخابی درباره زمان بررسی تداخل در عملیات نوشتن است، نه انتخابی درباره اینکه آیا باید Lock بگیریم یا نه. در Pessimistic Locking، از همان ابتدا با استفاده از یک Database Lock، ردیف موردنظر را قفل میکنیم تا هیچ عملیات دیگری نتواند تا زمان COMMIT به آن دسترسی تغییردهنده داشته باشد. در مقابل، Optimistic Locking اجازه میدهد عملیات پیش برود، اما هنگام ثبت تغییرات، شماره نسخه را بررسی میکند، اگر ترنزکشن دیگری پیش از آن ردیف را تغییر داده باشد، عملیات شکست میخورد. از Optimistic شروع کنید و فقط زمانی سراغ Pessimistic بروید که تداخلها مکرر باشند و اجرای مجدد کار ازدسترفته هزینه زیادی داشته باشد.
این یک جمله، بیش از بسیاری از بحثهای Code Review اختلافنظرها را حل میکند. مشکل اینجاست که تقریبا تمام راهنماهای این موضوع از نقطه اشتباهی شروع میشوند. بحث را با این جمله آغاز میکنند که «Optimistic سریعتر است و Pessimistic امنتر»، یکی را انتخاب میکنند و هرگز توضیح نمیدهند که سوال اصلی چیست.
بیایید مسئلهای را بررسی کنیم که هر دو روش برای حل آن وجود دارند. دو ریکوئست بهصورت همزمان یک ردیف را میخوانند، مثلا موجودی یک حساب، تعداد اقلام انبار یا یک سند. هر ریکوئست بر اساس دادهای که خوانده، مقدار جدیدی محاسبه میکند و آن را در دیتابیس مینویسد. عملیات نوشتن دوم، بدون هیچ هشداری، نتیجه عملیات اول را بازنویسی میکند و تغییرات ریکوئست اول از بین میرود.
این مشکل Lost Update نام دارد و یکی از رایجترین باگهای Concurrency در نرمافزارهای تجاری است.
سوال اصلی این نیست که «از کدام Lock استفاده کنم؟»، سوال این است که با فاصله زمانی بین خواندن یک ردیف و نوشتن مجدد آن چه کنیم. هر دو روش پاسخی برای همین فاصله هستند. این مقاله یک آزمون مشخص به نام Claim Test معرفی میکند تا بتوانید بین آنها انتخاب کنید و یک سوال مقدماتی را هم مطرح میکند که باید پیش از انتخاب هرکدام از این روشها بپرسید.
تفاوت Optimistic Locking و Pessimistic Locking چیست؟
Optimistic Locking و Pessimistic Locking دو روش برای جلوگیری از Lost Update هستند و تفاوت آنها فقط در زمان تشخیص تداخل است.
در Pessimistic Locking، پیش از خواندن یک ردیف، یک Database Lock روی آن میگیریم و تا پایان ترنزکشن این Lock را نگه میداریم. هر ترنزکشن دیگری که بخواهد همان ردیف را قفل، بهروزرسانی یا حذف کند، باید منتظر بماند. شما ردیف را قفل میکنید، عملیات خود را انجام میدهید و هنگام COMMIT، Lock آزاد میشود.
در PostgreSQL و MySQL، این کار با SELECT ... FOR UPDATE انجام میشود.
در Optimistic Locking هیچ Lockای گرفته نمیشود. ردیف را به همراه شماره نسخه آن میخوانیم و هنگام نوشتن، فقط در صورتی ردیف را بهروزرسانی میکنیم که شماره نسخه همچنان با مقداری که قبلا خوانده بودیم یکسان باشد. اگر ترنزکشن دیگری در این فاصله ردیف را تغییر داده باشد، شماره نسخه دیگر مطابقت ندارد، دستور Update صفر ردیف را تغییر میدهد و کد باید عملیات را دوباره اجرا کند یا با خطا خاتمه دهد.
بررسی این شرط بهصورت یک WHERE version = :expected ساده در دستور UPDATE انجام میشود.
این نامها بیانگر فرضی هستند که درباره احتمال تداخل داریم. Pessimistic Locking فرض میکند احتمال تداخل زیاد است، بنابراین برای اطمینان، هزینه گرفتن Lock را در هر دسترسی میپردازد. Optimistic Locking فرض میکند تداخل نادر است، بنابراین در ابتدا هزینهای نمیپردازد و فقط زمانی هزینه میکند که واقعا تداخلی رخ دهد.
هیچکدام در حالت کلی «امنتر» نیستند، هر دو از Lost Update جلوگیری میکنند. تفاوت آنها در محل پرداخت هزینه است: Pessimistic Locking هزینه انتظار را میپردازد و Optimistic Locking هزینه اجرای مجدد را.
دلیل سردرگمی در انتخاب این روشها این است که پاسخ درست به اعدادی بستگی دارد که معمولا هنوز اندازهگیری نکردهایم: دو عملیات نوشتن واقعا چند وقت یکبار به یک ردیف مشترک دسترسی پیدا میکنند و اگر یکی از آنها بازنده شود، چه مقدار کار باید دور ریخته شود؟
ادامه مقاله درباره این است که چگونه این اعداد را وارد فرایند تصمیمگیری کنیم.
Conflict Window چیست و چرا همهچیز به آن بستگی دارد؟
Conflict Window بازه زمانی بین خواندن یک ردیف و نوشتن مجدد آن است، بازهای که در طول آن ترنزکشن دیگری میتواند ردیف را تغییر دهد. تمام موارد Lost Update در همین بازه اتفاق میافتند. هر دو روش Locking صرفا دو راه متفاوت برای مدیریت این بازه هستند.
بیایید این بازه را بهصورت مستقیم تصور کنیم.
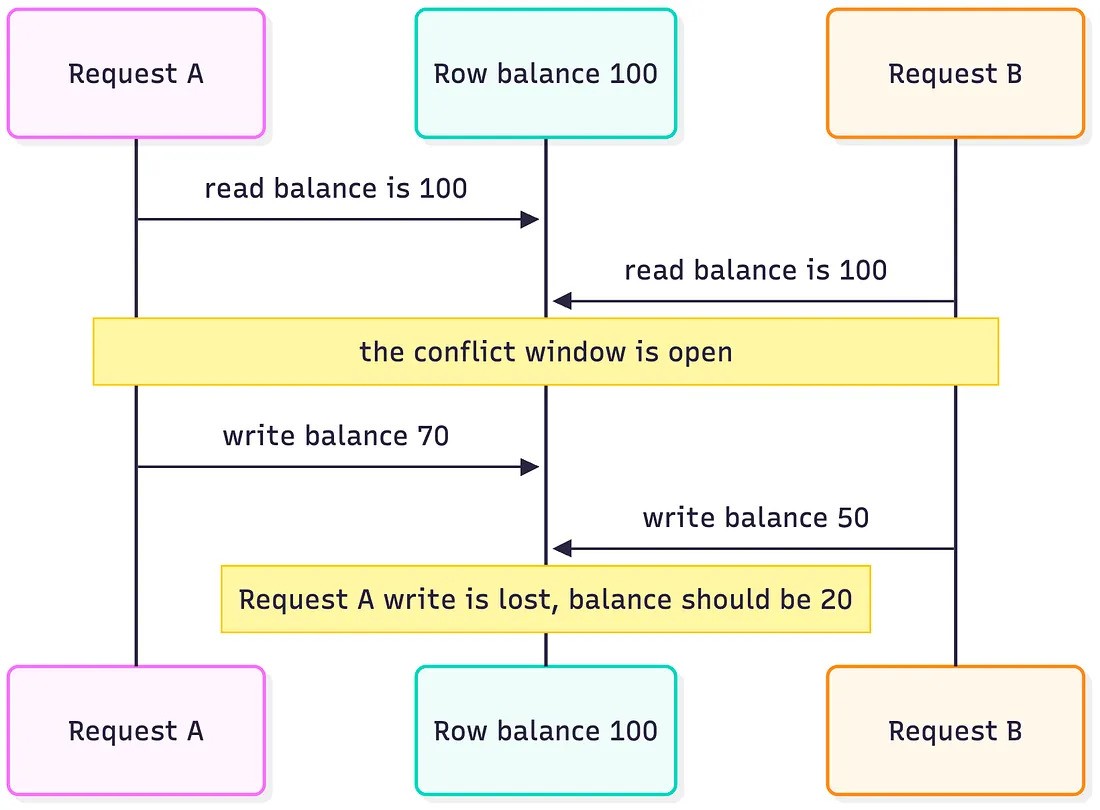
Pessimistic Locking این بازه را میبندد: ریکوئست B نمیتواند ردیف را بخواند تا زمانی که ریکوئست A عملیات COMMIT را انجام دهد. بنابراین B مقدار ۷۰ را میخواند و مقدار ۲۰ را مینویسد.
Optimistic Locking بازه را باز میگذارد، اما هنگام خروج از آن کنترل اعمال میکند: عملیات نوشتن B شماره نسخهای را که خوانده بود همراه دارد. دیتابیس متوجه میشود که شماره نسخه تغییر کرده است و عملیات نوشتن B را رد میکند تا B بتواند دوباره داده را بخواند و تلاش مجدد انجام دهد.
دو واقعیت درباره این بازه، کل تصمیمگیری را تعیین میکنند.
اول اینکه طول این بازه را معماری سیستم شما تعیین میکند، نه دیتابیس. اگر بازه داخل یک ترنزکشن کوتاه باشد، فقط چند میلیثانیه طول میکشد. اما اگر بازه از زمانی که کاربر فرمی را باز میکند تا زمانی که دو دقیقه بعد آن را ذخیره میکند ادامه داشته باشد، طول آن دو دقیقه است و نمیتوانید یک Database Lock را دو دقیقه نگه دارید، بدون اینکه Throughput سیستم را بهشدت کاهش دهید.
دوم اینکه میزان ترافیک عبوری از این بازه، همان Contention است. اگر دو عملیات نوشتن تقریبا هیچوقت با یکدیگر همپوشانی نداشته باشند، باز ماندن این بازه بهندرت مشکل ایجاد میکند.
این مفهوم را به خاطر بسپارید. طول بازه مشخص میکند که آیا اساسا میتوان از Database Lock استفاده کرد یا نه، میزان تداخل مشخص میکند که آیا استفاده از آن ارزش دارد یا خیر.
Claim Test که در ادامه میآید، همین دو سوال را بهعلاوه یک سوال درباره هزینه، به ترتیب درست مطرح میکند.
سوال صفر: اصلا به Lock نیاز دارید؟
پیش از انتخاب Optimistic یا Pessimistic Locking، از خودتان بپرسید آیا میتوانید Conflict Window را بهطور کامل حذف کنید یا نه. در بسیاری از موارد این کار امکانپذیر است و در نتیجه به هیچکدام از این دو روش نیاز ندارید.
Lost Update فقط به این دلیل رخ میدهد که مقداری را از دیتابیس وارد اپلیکیشن میکنید، آن را در اپلیکیشن تغییر میدهید و دوباره به دیتابیس برمیگردانید. اگر بتوان مقدار جدید را با یک Statement واحد داخل دیتابیس محاسبه کرد، دیگر بازهای برای محافظت وجود ندارد:
-- بدون الگوی Read-Modify-Write در Application
-- بدون Conflict Window و بدون نیاز به Lock
UPDATE accounts
SET balance = balance - 30
WHERE id = 42
  AND balance >= 30;
دیتابیس ردیف را در قالب یک Statement اتمیک میخواند و بهروزرسانی میکند. شرط balance >= 30 نیز تضمین میکند که موجودی حساب منفی نشود. اگر هیچ ردیفی تغییر نکند، برداشت رد شده است.
این روش از هر دو استراتژی Locking سریعتر است و نمیتواند باعث Lost Update شود، چون اپلیکیشن هیچ نسخه قدیمیای از داده را نگه نمیدارد که بعدا آن را بازنویسی کند.
همین ایده فراتر از عملیات حسابی نیز کاربرد دارد. اگر قانونی که میخواهید حفظ کنید با یک Constraint در دیتابیس قابل بیان باشد، مثلا یک UNIQUE INDEX برای تضمین «هر صندلی فقط یک رزرو داشته باشد» یا یک EXCLUDE CONSTRAINT برای جلوگیری از «رزروهای همپوشان»، استفاده از Constraint بهتر از تکیه بر Isolation Level یا Lock است. Constraint فارغ از اینکه کدام مسیر کد ردیف را تغییر میدهد، اعمال میشود.
این اولین قاعده در انتخاب Database Isolation Level است: اگر میتوانید قانون موردنظر را به یک Constraint تبدیل کنید، آن را بهصورت Constraint پیادهسازی کنید.
Locking برای مواردی است که یک Statement واحد بهتنهایی کافی نیست، مثلا زمانی که مقدار جدید به منطق اپلیکیشن، یک فراخوانی خارجی، تصمیمگیری انسان یا هماهنگی چند ردیف وابسته است.
در چنین شرایطی است که انتخاب بین Optimistic و Pessimistic Locking اهمیت پیدا میکند و Claim Test کاربرد دارد.
Claim Test: مهندسان ارشد چگونه بین این دو روش انتخاب میکنند؟
Claim Test شامل سه سوال است که باید به ترتیب مطرح شوند. پاسخ این سوالها مشخص میکند که آیا باید ردیف را از ابتدا قفل کنیم (Pessimistic) یا در پایان عملیات، وجود تداخل را بررسی کنیم (Optimistic).
نام این آزمون از تفاوت اصلی دو روش گرفته شده است: Pessimistic Locking ردیف را از ابتدا در اختیار میگیرد، در حالی که Optimistic Locking در پایان وجود تداخل را بررسی میکند.
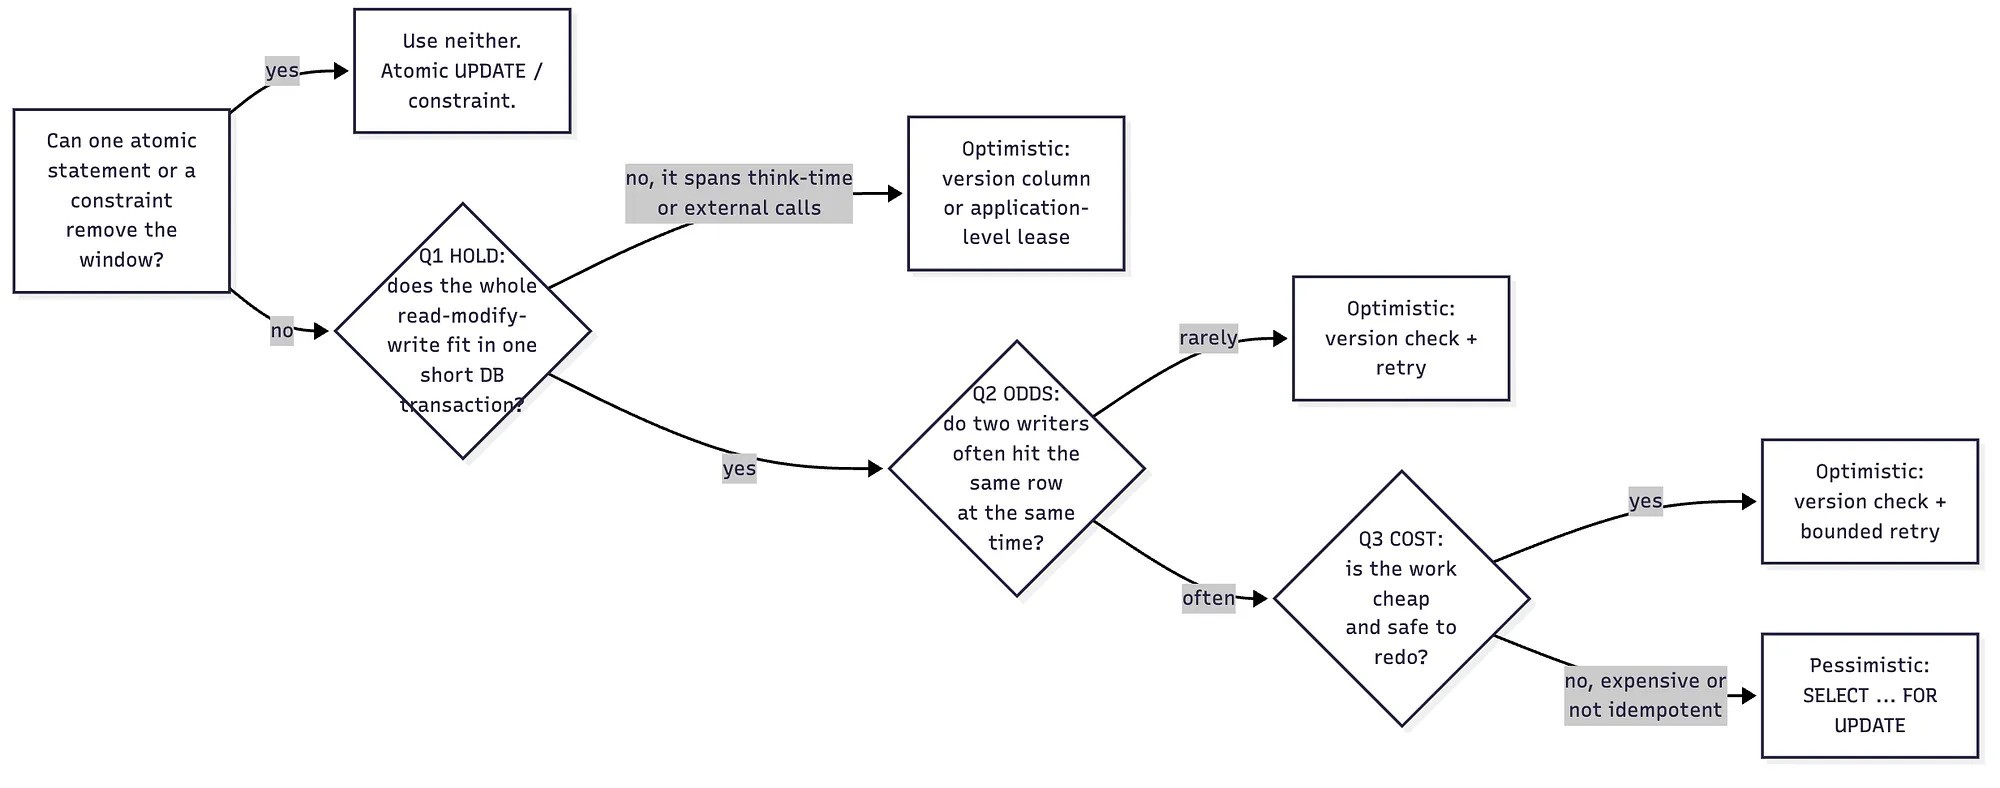
روش پیشفرض، Optimistic است. فقط زمانی به Pessimistic میرسید که پاسخ هر سه سوال به نفع آن باشد: امکان نگهداشتن Lock وجود داشته باشد، تداخلها مکرر باشند و از دست دادن کار انجامشده هزینه زیادی داشته باشد.
این ترکیب واقعا در سیستمها وجود دارد و دقیقا همان جایی است که Pessimistic Locking هزینه خود را توجیه میکند، اما این شرایط محدودتر از چیزی است که عادت «برای اطمینان از SELECT FOR UPDATE استفاده کن» القا میکند.
به ترتیب سوالها توجه کنید. سوال اول درباره سرعت یا امنیت نیست، درباره این است که آیا نگهداشتن Database Lock از نظر معماری اصلا امکانپذیر است یا خیر. بسیاری از راهنماها این سوال را نادیده میگیرند، در حالی که همین سوال اغلب بهتنهایی تصمیم را مشخص میکند.
سه بخش بعدی هرکدام یکی از این سوالها را بررسی میکنند.
سوال اول: آیا میتوانید Lock را در تمام طول Conflict Window نگه دارید؟
اولین سوال در انتخاب بین Optimistic و Pessimistic Locking این نیست که «کدام سریعتر است؟». سوال این است که آیا Conflict Window بهطور کامل در یک ترنزکشن دیتابیس واحد جا میگیرد یا نه.
اگر چنین نباشد، Database Lock گزینه قابل استفادهای نیست، صرفنظر از میزان Contention.
یک Lock که با SELECT ... FOR UPDATE گرفته میشود، فقط تا زمانی اعتبار دارد که ترنزکشن باز است. بهمحض اجرای COMMIT آزاد میشود. بنابراین Pessimistic Database Locking فقط زمانی کار میکند که خواندن، تغییر و نوشتن داده همگی داخل یک ترنزکشن کوتاه انجام شوند، در حد چند میلیثانیه.
بهمحض اینکه یک انسان یا یک سیستم راه دور وارد این فرایند شود، Conflict Window دیگر در یک ترنزکشن کوتاه جا نمیگیرد.
برای مثال، ویرایش یک صفحه ویکی را در نظر بگیرید: صفحه را ساعت ۱۰ باز میکنید، دو دقیقه آن را میخوانید و ساعت ۱۰:۰۲ ذخیره میکنید. Conflict Window دو دقیقه طول میکشد و دو HTTP Request جداگانه را با فاصلهای که کاربر بین آنها مشغول کار است، در بر میگیرد.
نمیتوانید Row Lock را برای این دو دقیقه نگه دارید، چون تمام ویرایشگران دیگر را مسدود میکنید و یک Database Connection را در تمام این مدت اشغال نگه میدارید.
Martin Fowler تفاوت این شرایط را با مفاهیم Pessimistic Offline Lock و Optimistic Offline Lock توضیح داده است. وقتی یک Business Transaction چند System Transaction را در بر میگیرد، روش Optimistic ممکن است تمام کار را انجام دهد و در آخرین لحظه متوجه شود که کل عملیات شکست خواهد خورد. در مقابل، روش Pessimistic به Lockای نیاز دارد که خودتان و در سطح اپلیکیشن مدیریت کنید، نه Lockای که Database Lock Manager مدیریت میکند.
پس قاعده روشن است:
- اگر Conflict Window داخل یک ترنزکشن کوتاه قرار میگیرد، هر دو روش قابل استفادهاند و باید به سوال دوم بروید.
- اگر این بازه شامل زمان تصمیمگیری کاربر، رفتوبرگشت یک Message یا زنجیرهای از فراخوانیهای Service باشد، Database Lock نمیتواند تمام آن را پوشش دهد. در این حالت باید از Optimistic Locking با یک Version Column استفاده کنید، یا اگر واقعا لازم است ردیف را در چند ریکوئست رزرو کنید، یک Lease در سطح اپلیکیشن با زمان انقضا پیادهسازی کنید. این راهکار عملا نوعی Offline Lock است که خودتان باید مدیریت و پاکسازی کنید.
این تصمیم به صحت عملکرد و معماری مربوط است، نه پرفورمنس، به همین دلیل در اولویت اول قرار دارد.
سوال دوم: عملیات نوشتن واقعا چند وقت یکبار با هم تداخل دارند؟
وقتی امکان نگهداشتن Lock وجود دارد، سوال دوم درباره Contention است: دو عملیات نوشتن در طول Conflict Window چند وقت یکبار به یک ردیف مشترک دسترسی پیدا میکنند؟
این عدد مشخص میکند که کدام روش، در مجموع، کار کمتری انجام میدهد.
نکتهای که بسیاری از مقالههای «Optimistic سریعتر است» اشتباه توضیح میدهند، این است که Optimistic Locking تعداد تداخلها را کاهش نمیدهد، فقط هزینه آنها را به مرحله Retry منتقل میکند.
وقتی تداخلی رخ میدهد، ترنزکشن بازنده کار خود را انجام داده است، هنگام COMMIT متوجه میشود نسخه داده قدیمی شده و مجبور است تمام آن کار را کنار بگذارد و از ابتدا شروع کند.
وقتی تداخلها نادر هستند، این معامله بسیار مطلوب است: مسیر معمول اجرای برنامه هیچ هزینهای برای Lock نمیپردازد، هیچ چیزی منتظر نمیماند و خطر Deadlock نیز وجود ندارد.
اما وقتی تداخلها رایج میشوند، تعداد Retryها افزایش پیدا میکند. در شرایط Contention شدید روی یک ردیف پرترافیک یا Hot Row، Optimistic Locking ممکن است در مجموع CPU بیشتری مصرف کند، چون تعداد زیادی از ترنزکشنها مرتبا همان کار را انجام میدهند و شکست میخورند.
این وضعیت میتواند به Livelock منجر شود، حالتی که همه مشغول کار هستند، اما تعداد کمی از عملیات واقعا COMMIT میشوند.
Pessimistic Locking رفتار معکوسی دارد. در هر دسترسی، هزینه ثابتی برای گرفتن Lock و احتمالا انتظار پرداخت میشود، حتی اگر در صورت نگرفتن Lock هیچ تداخلی رخ نمیداد. در مقابل، هر ترنزکشن کار خود را فقط یک بار انجام میدهد. چون هیچ ترنزکشنی تا زمانی که ردیف را در اختیار نگرفته باشد، کار اصلی را شروع نمیکند، اجرای مجدد و اتلاف کار وجود ندارد.
بنابراین نقطهای وجود دارد که هزینه دو روش از یکدیگر عبور میکند.
بهصورت شهودی، اگر احتمال تداخل هر عملیات نوشتن پایین باشد، مثلا تعداد زیادی ردیف مختلف داشته باشید که هرکدام گاهی تغییر میکنند، Optimistic Locking بهوضوح بهتر است، چون بهندرت هزینه Retry را میپردازید.
اما با افزایش احتمال تداخل روی یک ردیف مشخص، هزینه Retryها بیشتر میشود و در نقطهای، هزینه ثابت گرفتن Lock از هزینه اجرای مجدد کمتر خواهد شد.
نقطه دقیق تغییر به مدت زمان اجرای عملیات و هزینه Retry بستگی دارد، موضوعی که سوال سوم بررسی میکند.
قاعده عملی این است: برای سیستمی که تعداد زیادی ردیف مختلف دارد و هرکدام گهگاه تغییر میکنند، Optimistic را روش پیشفرض در نظر بگیرید. زمانی به Pessimistic مشکوک شوید که یک Hot Row واقعی شناسایی کردهاید و تعداد زیادی عملیات نوشتن همزمان برای آن رقابت میکنند.
سوال سوم: از دست رفتن یک عملیات نوشتن چه هزینهای دارد؟
سومین سوال در انتخاب بین Optimistic و Pessimistic Locking این است که اگر ترنزکشن رقابت را ببازد، چه چیزی از دست میدهید؟
در شرایط Contention بالا، همین هزینه تعیینکننده است.
اگر کار انجامشده بین خواندن و نوشتن ساده باشد و بتوان آن را بدون خطر دوباره اجرا کرد، مثلا افزایش یک عدد، تغییر یک Flag یا محاسبه مجدد یک مقدار کوچک بر اساس ردیفی که دوباره خواندهاید، Optimistic Locking همراه با Retry محدود حتی در صورت تداخل مکرر نیز مناسب است.
Retry سریع است و Side Effect خطرناکی ندارد، بنابراین گاهی اجرای مجدد آن، از قرار دادن تمام عملیات نوشتن پشت یک Lock بهصرفهتر است.
اما شرایط زمانی کاملا تغییر میکند که کار پیش از نوشتن پرهزینه باشد یا تکرار آن ایمن نباشد.
فرض کنید بین خواندن ردیف و نوشتن آن، یک فراخوانی به Payment Provider انجام میدهید، ایمیل ارسال میکنید، یک شماره سریال تخصیص میدهید یا محاسبهای ۳۰ ثانیهای اجرا میکنید.
در این حالت، شکست Optimistic Locking یعنی یک اقدام واقعی انجام دادهاید و بعد متوجه شدهاید که نمیتوانید ترنزکشن را COMMIT کنید. اجرای مجدد عملیات ممکن است باعث شود مبلغ دوباره از کارت مشتری کسر شود.
این دقیقا جایی است که Pessimistic Locking هزینه خود را توجیه میکند: با گرفتن Lock روی ردیف از طریق SELECT ... FOR UPDATE، پیش از انجام کار پرهزینه، تضمین میکنید که آن کار فقط یک بار اجرا شود، چون هیچ ترنزکشن دیگری تا پایان کار نمیتواند پیش برود.
یک نکته ظریف نیز وجود دارد که به بحث Retry مربوط میشود: اجرای مجدد یک عملیات در Optimistic Locking فقط زمانی ایمن است که عملیات داخل Retry، Idempotent باشد یا هر تلاش یک Idempotency Key داشته باشد تا سیستم مقصد Side Effect تکراری را تشخیص دهد و حذف کند.
همین قاعده در فراخوانی APIها نیز برقرار است. اگر نتوانید اجرای مجدد عملیات را Idempotent کنید، باید آن را در دسته «پرهزینه برای اجرای مجدد» قرار دهید و Lock را در نظر بگیرید.
با کنار هم قرار دادن سه سوال، تصمیمگیری ساختاریافته میشود:
- Hold: آیا میتوان Lock را در تمام طول عملیات نگه داشت؟
- Odds: احتمال تداخل چقدر است؟
- Cost: اگر عملیات را ببازیم، هزینه آن چقدر خواهد بود؟
Optimistic روش پیشفرض است. زمانی سراغ Pessimistic بروید که امکان نگهداشتن Lock وجود دارد، احتمال تداخل بالاست و هزینه شکست عملیات قابلچشمپوشی نیست.
Optimistic Locking در کد چه شکلی است؟
Optimistic Locking یک Version Column به ردیف اضافه میکند و هر Update را به مقدار آن نسخه مشروط میسازد. دیتابیس، نه اپلیکیشن، تضمین میکند که در طول اجرای عملیات، شخص دیگری داده را تغییر نداده باشد.
SQL خام آن شبیه الگوی Compare-and-Set است:
-- خواندن
SELECT id, balance, version
FROM accounts
WHERE id = 42;

-- ... محاسبه مقدار جدید در Application ...

-- نوشتن فقط در صورتی که نسخه تغییر نکرده باشد
UPDATE accounts
SET balance = :new_balance,
    version = version + 1
WHERE id = 42
  AND version = :version_i_read;
اگر دستور UPDATE اعلام کند که یک ردیف تغییر کرده است، عملیات شما موفق بوده و میتوانید COMMIT کنید.
اگر صفر ردیف تغییر کرده باشد، ترنزکشن دیگری زودتر COMMIT کرده است، نسخهای که شما در اختیار دارید قدیمی است و باید داده را دوباره بخوانید و Retry کنید.
الگوی Retry به این صورت است:
- ردیف و شماره نسخه آن را بخوانید.
- مقدار جدید را محاسبه کنید.
- دستور
UPDATE ... WHERE version = :read_versionرا اجرا کنید. - اگر یک ردیف تغییر کرد، کار تمام است. اگر صفر ردیف تغییر کرد، به مرحله اول برگردید.
- پس از تعداد محدودی تلاش، عملیات را متوقف کنید و تداخل را به فراخواننده گزارش دهید. معمولاً ۳ تا ۵ تلاش مناسب است.
ORMهای بالغ این کار را برای شما انجام میدهند.
در Jakarta Persistence 3.2 و Hibernate ORM 7، اضافه کردن فیلد @Version به Entity باعث فعال شدن Optimistic Locking خودکار میشود و در صورت تداخل، هنگام Flush استثنای OptimisticLockException ایجاد میشود.
@Entity
class Account {
    @Id
    Long id;

    BigDecimal balance;

    @Version
    long version; // مدیریت خودکار توسط JPA
}
در Rails نیز همین ایده با ستونی به نام lock_version پیادهسازی شده است. کافی است این ستون را به جدول اضافه کنید تا ActiveRecord هنگام ذخیره متعارض، استثنای ActiveRecord::StaleObjectError را ایجاد کند.
در Django فیلد Version داخلی و آمادهای برای این کار وجود ندارد، اما میتوانید همین بررسی را با QuerySet.update() شرطی پیادهسازی کنید، بهطوری که کوئری بر اساس ورژن فیلتر شود و تعداد ردیفهای تغییرکرده بررسی شود.
مکانیزم اصلی در تمام این ابزارها یکسان است: Version Column، نوشتن شرطی و Retry.
Pessimistic Locking در کد چه شکلی است؟
Pessimistic Locking با استفاده از SELECT ... FOR UPDATE، در زمان خواندن و داخل یک ترنزکشن، یک Row Lock صریح میگیرد و آن را تا زمان COMMIT نگه میدارد. سایر عملیات نوشتن روی همان ردیف باید منتظر بمانند.
BEGIN;

SELECT id, balance
FROM accounts
WHERE id = 42
FOR UPDATE; -- قفل کردن ردیف

-- ... اجرای کاری که پرهزینه است و باید فقط یک بار انجام شود ...

UPDATE accounts
SET balance = :new_balance
WHERE id = 42;

COMMIT; -- آزاد شدن Lock
در PostgreSQL، عبارت FOR UPDATE باعث میشود ردیفهای بازیابیشده توسط SELECT بهگونهای قفل شوند که سایر ترنزکشنهایی که میخواهند آن ردیفها را UPDATE، DELETE یا مجددا با SELECT FOR UPDATE قفل کنند، تا پایان ترنزکشن فعلی مسدود شوند.
PostgreSQL حالتهای ضعیفتری نیز ارائه میدهد:
FOR NO KEY UPDATEFOR SHAREFOR KEY SHARE
برای مثال، اگر هدف این باشد که فقط Updateهای واقعی مسدود شوند، لازم نیست درج یک ردیف فرزند با Foreign Key نیز مسدود شود.
MySQL InnoDB نیز FOR UPDATE و حالت ضعیفتر FOR SHARE را ارائه میکند.
دو Modifier در PostgreSQL و MySQL برای استفاده عملی از Pessimistic Locking زیر بار کاری بالا مفید هستند:
NOWAIT
اگر ردیف از قبل قفل شده باشد، بهجای انتظار، بلافاصله خطا میدهد. زمانی مناسب است که نباید اجازه دهید ریکوئست منتظر بماند.
SKIP LOCKED
ردیفهایی را که از قبل قفل شدهاند نادیده میگیرد و بقیه را برمیگرداند. این قابلیت، Row Lock را به ابزاری برای توزیع کار تبدیل میکند.
چند Worker میتوانند هرکدام دستور SELECT ... FOR UPDATE SKIP LOCKED LIMIT 1 را اجرا کنند و هرکدام یک Job متفاوت و قفلنشده را بردارند. به این ترتیب میتوان یک Job Queue ایجاد کرد که برای توزیع کار به Message Broker نیاز ندارد.
در ORMها نیز ابزارهای مشابه وجود دارند:
- در Django، از
select_for_update(skip_locked=..., nowait=..., of=..., no_key=...)داخلtransaction.atomic()استفاده میشود. - در Jakarta Persistence، میتوان روی Query یا متد Find از
@Lock(LockModeType.PESSIMISTIC_WRITE)استفاده کرد. - در Rails، این قابلیت با
with_lock { ... }یاrecord.lock!در دسترس است.
مقایسه Optimistic Locking و Pessimistic Locking
خلاصه Claim Test را میتوان به این شکل در نظر گرفت:
| معیار | Optimistic Locking | Pessimistic Locking |
|---|---|---|
| نحوه مدیریت تداخل | تداخل هنگام Commit و از طریق بررسی ورژن شناسایی میشود. | تداخل از ابتدا و با استفاده از Row Lock جلوگیری میشود. |
| مدت نگهداشتن Lock در طول عملیات | هیچ Lockای نگه داشته نمیشود. | یک Exclusive Row Lock تا زمان Commit نگه داشته میشود. |
| پشتیبانی از چند درخواست یا زمان فکرکردن کاربر | بله، با استفاده از ستون ورژن یا Lease | خیر، Lock با پایان ترنزکشن آزاد میشود. |
| هزینه در مسیر اجرای عادی (Happy Path) | تقریبا صفر | در هر بار اجرا، هزینه دریافت Lock وجود دارد. |
| هزینه در شرایط رقابت شدید (High Contention) | افزایش Retryها و خطر Livelock | انتظار قابل پیشبینی، عملیات فقط یک بار اجرا میشود. |
| ایمنی هنگام اجرای عملیات غیر Idempotent | فقط در صورت استفاده از Idempotency Key | بله، عملیات دقیقا یک بار اجرا میشود. |
| سناریوهای شکست که باید برای آنها آماده بود | StaleObject و تمامشدن تلاشهای مجدد (Retry Exhaustion) | Deadlock، Timeout هنگام انتظار برای Lock و اشغال ماندن Connectionها |
| انتخاب پیشفرض | بله | فقط زمانی که مدت نگهداشتن Lock، احتمال تداخل و هزینه آن بالا باشد. |
نکتهای که باید به خاطر بسپارید این است: Optimistic Locking تا زمانی که Contention ایجاد نشده، کمهزینه است، Pessimistic Locking رفتار قابلپیشبینیتری دارد، اما هیچوقت رایگان نیست.
Claim Test مشخص میکند که کدام هزینه را انتخاب میکنید.
Lock توزیعشده بین چند سرویس چه تفاوتی دارد؟
Database Row Lock از ردیفهای داخل یک دیتابیس محافظت میکند. اما اگر منبع موردنظر یک ردیف دیتابیس نباشد، مثلا Jobای که فقط یک Worker باید اجرا کند، فایلی در Object Storage یا یک منبع خارجی، ممکن است از Distributed Lockهایی مانند Redis استفاده کنید.
این مسئله متفاوت است و نمیتوان قواعد مربوط به Row Lock را بدون بررسی به آن تعمیم داد.
تحلیل Martin Kleppmann درباره Distributed Locking، تفاوت مهمی را مشخص میکند. Lock را معمولا به دو دلیل میگیریم:
- Efficiency Lock: مانع انجام دوباره یک کار میشود. اگر گاهی درست عمل نکند، مقداری کار اضافه انجام میشود. برای چنین کاربردی، یک Redis Lock تکگرهای میتواند کافی باشد.
- Correctness Lock: از خراب شدن State مشترک توسط دو Process جلوگیری میکند. اگر دو Node مختلف همزمان تصور کنند Lock را در اختیار دارند، با یک باگ جدی مواجه هستیم.
در حالت دوم، صرف داشتن Lock کافی نیست. ممکن است یک Process بعد از بررسی Lock و پیش از نوشتن، بهدلیل Garbage Collection یا تاخیر شبکه متوقف شود. در این فاصله Lock منقضی میشود و Process دیگری آن را میگیرد، اما وقتی Process اول دوباره اجرا شود، ممکن است همچنان عملیات نوشتن خود را انجام دهد.
راهکار پیشنهادی او Fencing Token است، عددی که سرویس Lock با هر بار گرفتن Lock افزایش میدهد و سیستم مقصد هنگام نوشتن آن را بررسی میکند. هر Write با Token قدیمیتر رد میشود.
الگوریتم ردیس به نام Redlock که برای چند Node طراحی شده، سازوکاری برای تولید Fencing Token ندارد. به همین دلیل، در تحلیل Kleppmann برای این دو نوع کاربرد، راهکار مناسبی محسوب نمیشود: برای یک Efficiency Lock بیش از حد پیچیده است و برای تضمین Correctness نیز بهاندازه کافی ایمن نیست.
نتیجه عملی این است که Redis Lock را بهعنوان تضمین صحت عملکرد سیستم در نظر نگیرید. اگر Correctness به آن وابسته است، به Fencing Token نیاز دارید یا باید کنترل نهایی در اختیار سیستمی باشد که خودش نوشتنها را Serialize میکند، که معمولا همان دیتابیس است.
Trade-offها و خطرات هر روش
هیچکدام از این دو روش رایگان نیستند. هر دو Failure Modeهایی دارند که باید از ابتدا برای آنها طراحی کنید، نه اینکه پس از وقوع در Production به فکرشان بیفتید.
خطرات Pessimistic Locking
مهمترین خطرها، Deadlock و اشغال طولانیمدت منابع هستند.
فرض کنید ترنزکشن A ابتدا ردیف ۱ را قفل میکند و سپس منتظر ردیف ۲ میماند. در همین زمان، ترنزکشن B ابتدا ردیف ۲ را قفل کرده و منتظر ردیف ۱ است. هیچکدام نمیتوانند ادامه دهند.
PostgreSQL این وضعیت را بهصورت خودکار تشخیص میدهد و پس از deadlock_timeout، که مقدار پیشفرض آن یک ثانیه است، یکی از ترنزکشنها را متوقف میکند. MySQL InnoDB نیز Deadlock را تشخیص میدهد و ترنزکشنی را Rollback میکند که تعداد کمتری Row Lock در اختیار دارد.
راهکار اصلی این است که همیشه Lockها را با یک ترتیب ثابت بگیرید.
از طرف دیگر، نگهداشتن Lock یک Database Connection را درگیر میکند و سایر عملیات نوشتن را مسدود میسازد. بنابراین یک عملیات کند داخل ترنزکشن دارای FOR UPDATE، مثلا فراخوانی یک API خارجی، میتواند کل سیستم را پشت یک ردیف متوقف کند.
اگر ردیف قفلشده مورد رقابت چند ترنزکشن باشد، عملیات منتظر تا زمان آزاد شدن Lock یا پایان Timeout منتظر میماند. برای نمونه، مقدار پیشفرض innodb_lock_wait_timeout در MySQL برابر ۵۰ ثانیه است و PostgreSQL نیز تنظیم lock_timeout را ارائه میدهد.
بنابراین:
- ترنزکشنهای دارای Lock را کوتاه نگه دارید.
- Lockها را همیشه با ترتیب یکسان بگیرید.
- هنگام نگهداشتن Row Lock، فراخوانی شبکهای انجام ندهید.
خطرات Optimistic Locking
خطر اصلی در Optimistic Locking، اتلاف کار و ایجاد موجی از Retryهاست.
هر تداخل، بخشی از کار انجامشده را دور میریزد. در شرایط Contention بالا، تعداد Retryها ممکن است به عامل غالب هزینه تبدیل شود.
حلقههای Retry باید محدودیت تعداد تلاش و مقداری تصادفیسازی زمانی یا Jitter داشته باشند، در غیر این صورت، یک Hot Row میتواند تعداد زیادی Retry همزمان و متداخل ایجاد کند که همگی دوباره شکست میخورند.
همچنین Optimistic Locking فقط از ردیفهایی محافظت میکند که بررسی ورژن آنها را پوشش میدهد.
یک باگ از نوع Write Skew ممکن است از بررسی ورژن یک ردیف عبور کند. در این وضعیت، دو ترنزکشن مجموعهای از ردیفها را میخوانند، هر دو تشخیص میدهند که یک قانون همچنان برقرار است و سپس هرکدام ردیف متفاوتی را تغییر میدهند.
برای مثال، دو مهندس On-call همزمان تصمیم میگیرند وضعیت خود را به «خارج از دسترس» تغییر دهند، در حالی که قانون سیستم میگوید حداقل یک نفر باید در دسترس باشد.
چون هر ترنزکشن ردیف متفاوتی را تغییر داده است، بررسی ورژن بهتنهایی نمیتواند این نقض قانون را تشخیص دهد.
این دسته از مشکلات به Isolation Levelها مربوط است، نه صرفا Locking. راهکار میتواند استفاده از Serializable Isolation یا تبدیل قانون مشترک بین چند ردیف به یک ردیف واقعی و قابل قفل شدن باشد.
جمعبندی دقیق این است: Optimistic Locking هزینهای کوچک و معمولا قابلپیشبینی را با احتمال پرداخت هزینهای بزرگ در برخی شرایط مبادله میکند، Pessimistic Locking برعکس عمل میکند.
شما بین یک گزینه امن و یک گزینه خطرناک انتخاب نمیکنید، بلکه انتخاب میکنید کدام نوع Failure Mode را ترجیح میدهید مدیریت کنید.
پرسشهای متداول
برای سیستمهایی با Concurrency بالا، Optimistic بهتر است یا Pessimistic؟
پاسخ به این بستگی دارد که عملیات همزمان روی چه تعداد ردیف متمرکز شدهاند.
اگر Throughput بالا روی ردیفهای مختلف توزیع شده باشد، Optimistic Locking مناسبتر است، چون احتمال تداخل پایین میماند و مسیر معمول اجرای عملیات به Lock نیاز ندارد.
اگر تعداد زیادی عملیات روی یک Hot Row متمرکز باشند، Pessimistic Locking ممکن است مناسبتر باشد، چون Retryهای Optimistic افزایش پیدا میکنند و کار زیادی هدر میرود.
بهجای اینکه فقط تعداد ریکوئست در ثانیه را اندازهگیری کنید، تعداد تداخلها را برای هر ردیف بررسی کنید.
آیا Optimistic Locking از Lost Update جلوگیری میکند؟
بله. بررسی ورژن تضمین میکند که Write فقط زمانی موفق شود که ردیف از زمان خواندن تغییر نکرده باشد. بنابراین یک Write مبتنی بر داده قدیمی، بهجای بازنویسی بیصدای داده جدیدتر، رد میشود.
اما Optimistic Locking از Write Skew جلوگیری نمیکند، یعنی حالتی که دو ترنزکشن بر اساس یک فرض مشترک، ردیفهای متفاوتی را تغییر میدهند. برای این وضعیت به Serializable Isolation یا یک Lock صریح روی ردیف مشترک نیاز دارید.
تفاوت SELECT FOR UPDATE با Optimistic Locking چیست؟
SELECT ... FOR UPDATE از نوع Pessimistic است. این دستور هنگام خواندن، یک Row Lock انحصاری میگیرد و باعث میشود سایر عملیات نوشتن تا زمان COMMIT منتظر بمانند.
Optimistic Locking هیچ Lockای نمیگیرد. شماره نسخه ردیف را میخواند و Write را به یکسان بودن نسخه فعلی با نسخه خواندهشده مشروط میکند.
به بیان ساده، یکی از بروز تداخل جلوگیری میکند و دیگری تداخل را تشخیص میدهد.
آیا میتوان از Optimistic Locking در چند HTTP Request استفاده کرد؟
بله، و در بسیاری از موارد این تنها گزینه عملی است.
Database Lock نمیتواند چند ریکوئست مستقل را پوشش دهد، چون با پایان ترنزکشن آزاد میشود.
شماره نسخه را در اختیار Client قرار دهید، مثلا در فرم، یک ETag یا یک Hidden Field. هنگام ذخیره، Client همان نسخه را ارسال کند و اگر نسخه در این فاصله تغییر کرده بود، عملیات ذخیره رد شود.
اگر واقعا به رزرو یک ردیف در چند ریکوئست نیاز دارید، میتوانید از یک Lease مدیریتشده در سطح اپلیکیشن با زمان انقضا استفاده کنید.
آیا باید بهجای Database Lock از Redis Lock استفاده کنم؟
فقط زمانی که هدف شما جلوگیری از اتلاف منابع است، نه تضمین Correctness.
یک Redis Lock تکگرهای برای جلوگیری از اجرای تکراری یک کار مناسب است، اگر اجرای دوباره صرفا باعث اتلاف منابع شود.
اما اگر صحت عملکرد سیستم به انحصاری بودن Lock وابسته باشد، یک Redis Lock ساده در برابر توقف Processها و اختلاف ساعت، تضمین کافی ایجاد نمیکند. در این حالت به Fencing Token یا سیستمی نیاز دارید که خود عملیات نوشتن را Serialize کند، معمولا دیتابیس.
علاوه بر Locking به چه Isolation Levelای نیاز دارم؟
برای یک عملیات Read-Modify-Write روی یک ردیف، Read Committed همراه با هرکدام از این دو روش کافی است.
اما اگر قانون تجاری شما چند ردیف را در بر بگیرد، مثلا یک مجموع، تعداد مشخصی از ردیفها یا بررسی نبودن یک رکورد، دیگر صرفا با Locking نمیتوانید همه شرایط را پوشش دهید.
در این حالت به Serializable Isolation یا یک Lock صریح روی ردیف والد مشترک نیاز دارید.
نکات کلیدی
- Optimistic Locking و Pessimistic Locking در زمان تشخیص تداخل تفاوت دارند: اولی ورژن را هنگام نوشتن بررسی میکند و دومی از ابتدا Row Lock میگیرد.
- پیش از استفاده از هرکدام، بررسی کنید آیا یک
UPDATEاتمیک یا Database Constraint میتواند Conflict Window را بهطور کامل حذف کند. اگر چنین است، اصلا به Lock نیاز ندارید. - Claim Test شامل سه سوال بهترتیب است: Hold، یعنی امکان نگهداشتن Lock در یک ترنزکشن، Odds، یعنی احتمال تداخل عملیات نوشتن و Cost، یعنی هزینه از دست رفتن کار.
- Database Lock نمیتواند زمان انتظار کاربر یا چند ریکوئست مستقل را پوشش دهد. در این شرایط باید از Optimistic Locking یا یک Lease در سطح اپلیکیشن استفاده کنید.
- Optimistic Locking زمانی کمهزینه است که تداخلها نادر باشند. در Contention شدید روی یک Hot Row، هزینه Retry ممکن است از هزینه Pessimistic Locking بیشتر شود.
- زمانی از
SELECT ... FOR UPDATEاستفاده کنید که امکان نگهداشتن Lock وجود دارد و کار موردنظر پرهزینه است یا تکرار آن ایمن نیست. - Distributed Lock در Redis ابزار بهینهسازی است، نه تضمین Correctness. برای تضمین صحت عملکرد، به Fencing Token یا سیستمی نیاز دارید که نوشتنها را Serialize کند.
- هر بار که میخواهید برای اطمینان از
SELECT ... FOR UPDATEاستفاده کنید، ابتدا Claim Test را اجرا کنید. در بیشتر موارد، Conflict Window داخل یک ترنزکشن کوتاه است، تداخلها نادرند و یک ستون ورژن کافی است، و گاهی حتی به هیچ Lockای نیاز ندارید.
دیدگاهها
ثبت دیدگاه