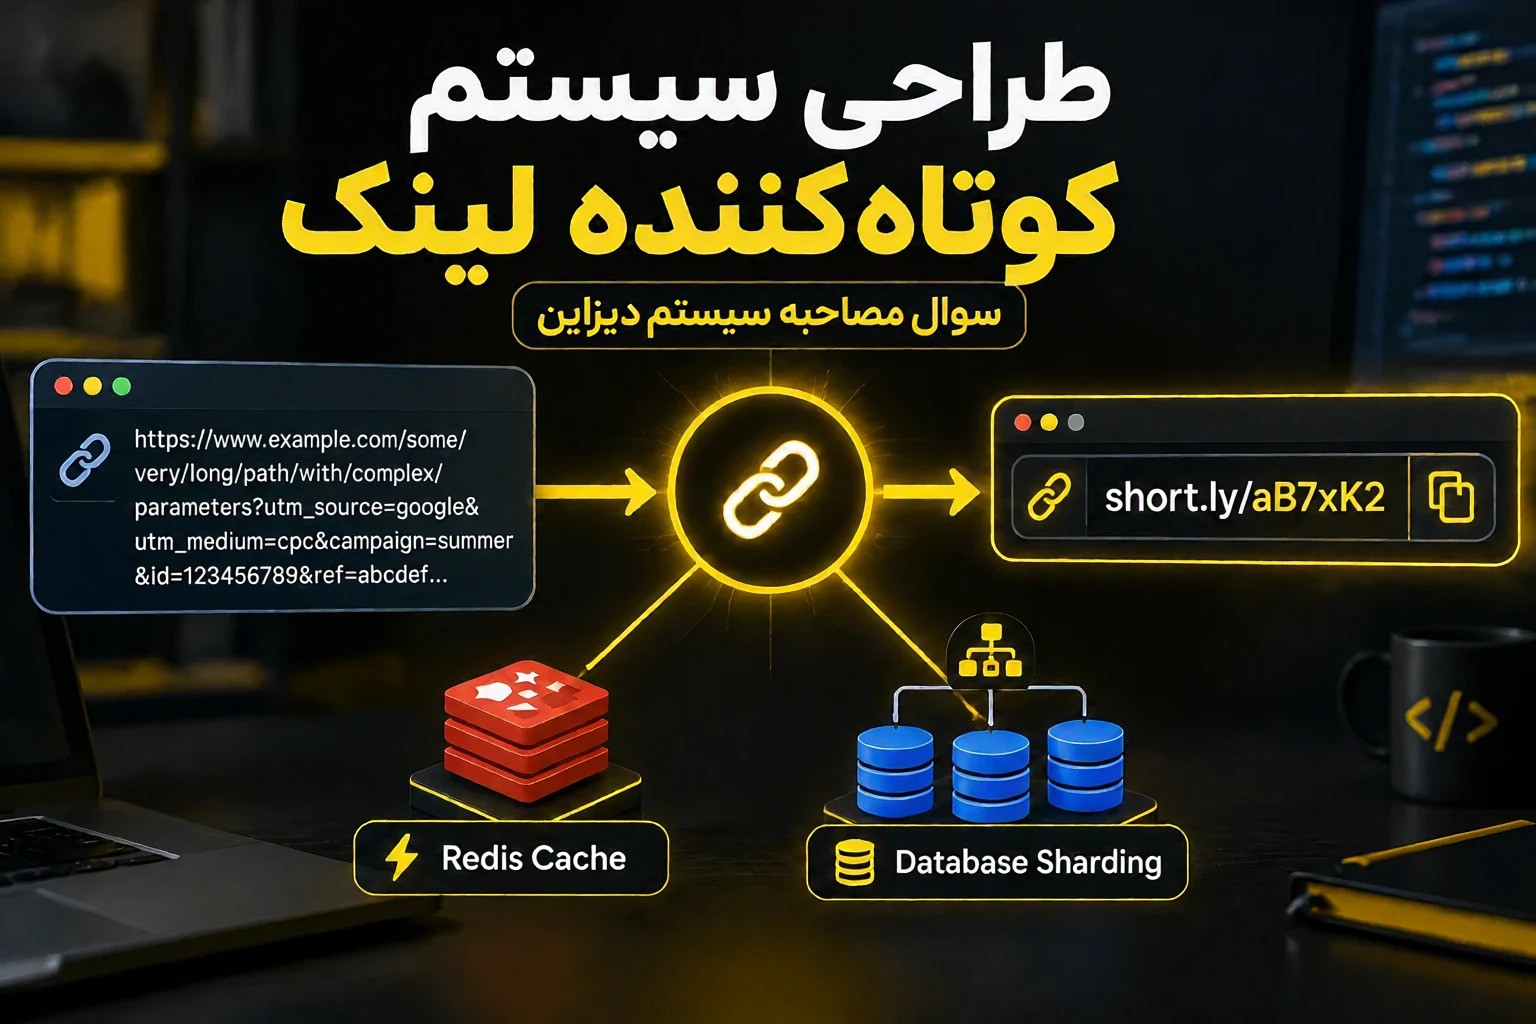
آنچه TinyURL و Bitly میتوانند درباره کش، کدگذاری Base62، پایگاههای داده، مقیاسپذیری و سیستمهای توزیعشده به ما بیاموزند.
تصور کنید چنین آدرسی دارید:
https://www.example.com/products/electronics/mobile/samsung/product/12345?campaign=summerآیا اشتراکگذاری این آدرس سادهتر نمیشد اگر به شکل زیر بود؟
short.ly/aB7xK2این دقیقا کاری است که یک سرویس کوتاهکننده لینک انجام میدهد.
در نگاه اول، ساخت چنین سرویسی تقریبا پیشپاافتاده به نظر میرسد:
یک آدرس طولانی را جایی ذخیره میکنیم، یک کد کوتاه تولید میکنیم و وقتی کاربر روی لینک کلیک کرد، او را به آدرس اصلی هدایت میکنیم.
برای یک برنامه کوچک، واقعا هم میتوان کار را به همین سادگی انجام داد.
اما حالا تصور کنید سرویس کوتاهکننده لینک شما میلیونها کاربر و میلیاردها لینک داشته باشد.
ناگهان یک لینک وایرال میشود و میلیونها نفر طی چند ساعت روی آن کلیک میکنند.
در این شرایط، پرسشهایی درباره کش، مقیاسپذیری پایگاه داده، تولید شناسه در سیستمهای توزیعشده، توزیع بار، تحلیل دادهها، مدیریت خرابیها و دسترسپذیری مطرح میشوند.
به همین دلیل، مسئله «طراحی یک کوتاهکننده لینک» (Design a URL Shortener) یکی از مسائل محبوب در مصاحبههای طراحی سیستم (System Design) است. این مسئله از یک ایده ساده شروع میشود، اما بسیاری از مفاهیم بنیادی سیستمهای بزرگمقیاس را معرفی میکند.
بیایید این سیستم را از صفر طراحی کنیم.
۱. یک کوتاهکننده لینک دقیقا چه کاری انجام میدهد؟
یک کوتاهکننده لینک، آدرس طولانی را به آدرسی کوتاه تبدیل میکند:
آدرس طولانی ← آدرس کوتاه
برای مثال، آدرس زیر:
https://example.com/products/mobile/samsung/12345میتواند به این آدرس تبدیل شود:
short.ly/aB7xK2ما رابطه بین این دو آدرس را ذخیره میکنیم:
aB7xK2 → https://example.com/products/mobile/samsung/12345حالا تصور کنید کاربری آدرس زیر را وارد کند:
short.ly/aB7xK2سیستم ما کد aB7xK2 را استخراج میکند، آن را جستوجو میکند و آدرس اصلی را پیدا میکند.
سپس کاربر به آدرس زیر هدایت میشود:
https://example.com/products/mobile/samsung/12345بنابراین، در هسته اصلی، سیستم ما در واقع یک سامانه بزرگ جستوجوی کلید ـ مقدار (Key-Value Lookup) است.
کلید عبارت است از:
aB7xK2و مقدار آن عبارت است از:
https://example.com/products/mobile/samsung/12345تا اینجا ساده است.
حالا بیایید سیستم را مقیاسپذیر کنیم.
۲. کوتاهکنندههای لینک در دنیای واقعی کجا استفاده میشوند؟
پیش از طراحی سیستم، بهتر است بدانیم چرا اصلا به چنین سرویسی نیاز داریم.
کوتاهکردن لینک فقط به سرویسهای اختصاصی این حوزه محدود نمیشود. مفهوم اصلیِ «لینک کوتاه ← تغییر مسیر ← مقصد» در بسیاری از برنامههای واقعی استفاده میشود.
شبکههای اجتماعی
لینکهای طولانی در پستها و پیامها ظاهر چندان مناسبی ندارند.
یک پلتفرم میتواند از سرویس تغییر مسیر لینک استفاده کند تا:
لینک طولانی محصول ← لینک کوتاه قابل اشتراکگذاریاین پلتفرم همچنین میتواند از فرایند تغییر مسیر برای تشخیص تعداد کلیکهای روی لینک استفاده کند.
کمپینهای بازاریابی
تصور کنید شرکتی یک کمپین تبلیغاتی یکسان را از طریق کانالهای زیر اجرا میکند:
- ایمیل
- پیامک (SMS)
- لینکدین
- اینستاگرام
- گوگل ادز
آدرس مربوط به کمپین ممکن است به شکل زیر باشد:
example.com/product?id=123&utm_source=linkedin&utm_campaign=summer_sale&utm_medium=socialدر عوض، شرکت میتواند آدرس سادهتری در اختیار کاربران قرار دهد:
brand.co/summerسرویس تغییر مسیر میتواند مشخص کند که هر بازدید از کدام کمپین بازاریابی ایجاد شده است.
اعلانهای پیامکی
پیامک نیز یکی از کاربردهای طبیعی کوتاهکننده لینک است، زیرا تعداد کاراکترها اهمیت دارد.
برای مثال، پیامکها ممکن است شامل این موارد باشند:
- لینک پرداخت
- پیگیری سفارش
- تأیید رزرو
- تایید حساب کاربری
- فاکتور
بهجای ارسال آدرسی مانند:
company.com/orders/tracking/customer/123456789/order/983723مشتری میتواند لینک زیر را دریافت کند:
company.co/X7Km2کدهای QR
این یکی از مثالهای موردعلاقه من است.
تصور کنید رستورانی ۱۰ هزار کد QR چاپ میکند که به منوی آن رستوران لینک میشوند.
بهجای اینکه آدرس واقعی منو داخل کد QR قرار بگیرد، کد به این آدرس اشاره میکند:
restaurant.com/menuدر پشت صحنه، این آدرس به فایل منو هدایت میشود:
restaurant.com/menu → menu-v1.pdfشش ماه بعد، رستوران منوی خود را تغییر میدهد.
کافی است نگاشت را بهروزرسانی کنیم:
restaurant.com/menu → menu-v2.pdfدیگر نیازی به تغییر کدهای QR چاپشده نیست.
لینکهای عمیق موبایل (Mobile Deep Links)
تصور کنید شخصی لینک یک محصول را به اشتراک میگذارد.
سرویس تغییر مسیر میتواند بر اساس شرایط تصمیم بگیرد:
آیا اپلیکیشن روی دستگاه نصب شده است؟
اگر بله:
← محصول را در داخل اپلیکیشن موبایل باز کن.
اگر خیر:
← وبسایت یا فروشگاه اپلیکیشن را باز کن.
بنابراین، یک سرویس پیشرفته مدیریت لینک میتواند به یک لایه مسیریابی هوشمند تبدیل شود، نه صرفا ابزاری برای کوتاهکردن آدرسها.
تست A/B
تصور کنید آدرس زیر را داریم:
brand.co/offerسیستم میتواند کاربران را به این شکل هدایت کند:
- ۵۰٪ ← صفحه فرود A
- ۵۰٪ ← صفحه فرود B
سپس شرکت میتواند عملکرد دو صفحه فرود را با یکدیگر مقایسه کند.
این موضوع یکی از درسهای مهم طراحی سیستم است:
یک کوتاهکننده لینک لزوما فقط برای کوتاهکردن آدرسها نیست، بلکه میتواند به پلتفرمی برای تغییر مسیر، ردیابی، مسیریابی، آزمایش و تحلیل دادهها تبدیل شود.
۳. بیایید نیازمندیهای سیستم را مشخص کنیم
پیش از ترسیم نمودارهای معماری، باید مشخص کنیم که دقیقا چه چیزی میسازیم.
نیازمندیهای عملکردی (Functional Requirements)
سیستم ما باید به کاربران اجازه دهد:
- یک آدرس طولانی ارسال کنند.
- یک آدرس کوتاه دریافت کنند.
- آدرس کوتاه را باز کنند.
- به آدرس اصلی هدایت شوند.
همچنین میتوانیم قابلیتهای زیر را بهصورت اختیاری پشتیبانی کنیم:
- نام مستعار سفارشی (Custom Alias)
- تاریخ انقضا
- آمار کلیکها
- تولید کد QR
- کاربران احراز هویتشده
- امکان ویرایش مقصد لینک
در این مقاله، تمرکز اصلی ما بر کوتاهکردن لینک و تغییر مسیر خواهد بود.
نیازمندیهای غیرعملکردی (Non-functional Requirements)
سیستم ما باید ویژگیهای زیر را نیز داشته باشد.
سرعت بالا
تغییر مسیر باید با کمترین تاخیر ممکن انجام شود.
دسترسپذیری بالا (High Availability)
تصور کنید میلیونها وبسایت از لینکهای کوتاه ما استفاده میکنند.
اگر سرویس ما از دسترس خارج شود، این لینکها عملا دیگر کار نخواهند کرد.
مقیاسپذیری (Scalability)
معماری باید بتواند از هزاران آدرس ذخیرهشده به میلیاردها آدرس گسترش پیدا کند.
بهینهسازی برای خواندن (Read Optimized)
یک آدرس کوتاه فقط یک بار ایجاد میشود، اما ممکن است پس از آن هزاران یا حتی میلیونها بار باز شود.
این یعنی ذاتا با سیستمی مواجه هستیم که حجم خواندن دادهها در آن بسیار بیشتر از حجم نوشتن است، بهعبارت دیگر، یک سیستم با بار خواندن بالا (Read-heavy) داریم.
۴. معماری اولیه
بیایید با سادهترین طراحی ممکن شروع کنیم:
Client
   |
   v
URL Shortener Service
   |
   v
Database
پایگاه داده میتواند جدولی شامل این اطلاعات داشته باشد:
| short_code | long_url |
|---|---|
| aB7xK2 | https://example.com/products/123 |
| xP91Lm | https://example.com/offers/456 |
| kM72Qa | https://example.com/blog/789 |
دو عملیات اصلی ما عبارتاند از:
نوشتن (Write)
Long URL
   ↓
Generate short code
   ↓
Store mapping
   ↓
Return short URL
یعنی آدرس طولانی دریافت میشود، کد کوتاه تولید میشود، نگاشت در پایگاه داده ذخیره میشود و آدرس کوتاه به کاربر برگردانده میشود.
خواندن (Read)
Short URL
   ↓
Find short code
   ↓
Database lookup
   ↓
Find original URL
   ↓
Redirect user
در این حالت، کد کوتاه استخراج میشود، در پایگاه داده جستوجو میشود، آدرس اصلی پیدا میشود و کاربر به آن هدایت میشود.
این ساختار، پایه معماری ماست.
۵. طراحی API
به تعداد زیادی API نیاز نداریم. دو endpoint برای پوشش نیازمندیهای اصلی کافی هستند.
ایجاد لینک کوتاه
POST /api/v1/urlsدرخواست:
{
  "longUrl": "https://example.com/products/mobile/12345"
}
پاسخ:
{
  "shortUrl": "https://short.ly/aB7xK2"
}
سپس به endpoint تغییر مسیر نیاز داریم.
تغییر مسیر
GET /aB7xK2سرویس ما کد aB7xK2 را جستوجو میکند و یک پاسخ تغییر مسیر HTTP به آدرس اصلی برمیگرداند.
۶. مسئله جالب: کد aB7xK2 از کجا میآید؟
اینجاست که بحث طراحی سیستم در مصاحبهها جذاب میشود.
ما به کدی نیاز داریم که ویژگیهای زیر را داشته باشد:
- کوتاه باشد.
- یکتا باشد.
- برای استفاده در URL مناسب باشد.
- سریع تولید شود.
یکی از روشهای رایج این است:
شناسه یکتا + کدگذاری Base62
بیایید بدون ورود به ریاضیات پیچیده، این روش را بررسی کنیم.
فرض کنید سیستم ما عدد زیر را تولید میکند:
125891234این عدد یکتا است، اما آدرس زیر چندان جذاب نیست:
short.ly/125891234در عوض، عدد را به Base62 تبدیل میکنیم.
Base62 معمولا از کاراکترهای زیر استفاده میکند:
- ارقام
0-9شامل ۱۰ کاراکتر - حروف بزرگ
A-Zشامل ۲۶ کاراکتر - حروف کوچک
a-zشامل ۲۶ کاراکتر
در مجموع، ۶۲ کاراکتر.
بنابراین:
125891234
    ↓
  Base62
    ↓
  aB7xK2
حالا آدرس ما به شکل زیر درمیآید:
short.ly/aB7xK2بسیار بهتر است.
۷. چرا Base62 قدرتمند است؟
فرض کنید کد کوتاه ما هفت کاراکتر داشته باشد.
برای هر موقعیت، ۶۲ انتخاب ممکن داریم. بنابراین تعداد ترکیبهای ممکن برابر است با:
62⁷ ≈ 3.52 trillionیعنی با فقط هفت کاراکتر، فضای نام بسیار بزرگی در اختیار داریم.
به همین دلیل Base62 اغلب در بحثهای مربوط به طراحی کوتاهکننده لینک مطرح میشود: این روش رشتههای فشردهای تولید میکند که از کاراکترهای الفبایی و عددی مناسب برای URL تشکیل شدهاند.
۸. چرا URL طولانی را مستقیما هش نکنیم؟
یک راهحل بدیهی دیگر این است:
Long URL
   ↓
Hash function
   ↓
abcdef123456789...
   ↓
Take first 7 characters
   ↓
abcdef1
این روش میتواند کار کند، اما کوتاهکردن خروجی هش مشکل مهمی ایجاد میکند.
برخورد هش (Hash Collision)
تصور کنید دو آدرس متفاوت به یک کد کوتاه برسند:
URL A → abc1234
URL B → abc1234
در این حالت، دو URL متفاوت دارای یک کد کوتاه یکسان شدهاند.
بنابراین، به سازوکار تشخیص برخورد و منطق تلاش مجدد (Retry Logic) نیاز داریم.
هشکردن ذاتا روش بدی نیست. نکته مهم در مصاحبه طراحی سیستم این است که بتوانید مصالحهها و محدودیتهای هر روش را تشخیص دهید و توضیح دهید.
یک راه جایگزین:
Generate guaranteed unique ID
        ↓
Base62 encode ID
        ↓
Short code
اگر شناسههای اولیه یکتا باشند، نمایش Base62 آنها نیز یکتا خواهد بود.
اما این روش سوال دیگری ایجاد میکند:
این شناسههای یکتا را از کجا میآوریم؟
۹. تولید شناسه در یک سیستم توزیعشده
در مقیاس کوچک، شاید روش زیر کافی باشد:
AUTO_INCREMENT در پایگاه داده
شناسههای ما میتوانند به شکل زیر باشند:
1
2
3
4
5
...
سپس آنها را به Base62 تبدیل میکنیم.
اما تصور کنید در نهایت ۱۰۰ سرور داشته باشیم:
Server 1
Server 2
Server 3
...
Server 100نمیخواهیم تمام سرورهای برنامه برای همیشه به یک دنباله شناسه متمرکز در پایگاه داده وابسته باشند.
به روشی مقیاسپذیر برای تولید شناسههای یکتا نیاز داریم.
روش اول: تولیدکننده شناسه به سبک Snowflake
یکی از گزینهها استفاده از تولیدکننده شناسه توزیعشده به سبک Snowflake است.
یک شناسه به سبک Snowflake از بخشهایی مانند موارد زیر تشکیل میشود:
مهر زمانی + شناسه ماشین یا Worker + شماره توالی
از نظر مفهومی:
| Timestamp | Worker | Sequence |بخش Worker ماشینهای مختلف را از یکدیگر متمایز میکند، درحالیکه بخش Sequence شناسههای متعددی را که یک Worker در یک بازه زمانی یکسان تولید میکند، از هم جدا میکند.
این ساختار به چندین ماشین اجازه میدهد بهصورت همزمان شناسه تولید کنند، بدون اینکه برای تولید هر شناسه به یک درخواست رفتوبرگشت به پایگاه داده نیاز داشته باشند.
روش دوم: تخصیص بازههای شناسه
یک راهبرد دیگر، اختصاص بازههای شناسه به سرورهاست:
Server A → 1–1,000,000
Server B → 1,000,001–2,000,000
Server C → 2,000,001–3,000,000
هر سرور میتواند شناسههای خود را در محدوده اختصاصیافته، بهصورت محلی تولید کند.
اصل مهم طراحی این است:
تولید شناسه را به یک گلوگاه سراسری و متمرکز تبدیل نکنید.
۱۰. وقتی کسی روی لینک کلیک میکند چه اتفاقی میافتد؟
حالا بیایید رایجترین عملیات سیستم را بررسی کنیم.
کاربری آدرس زیر را وارد میکند:
short.ly/aB7xK2درخواست به سیستم ما میرسد:
User
  ↓
Load Balancer
  ↓
URL Service
  ↓
Database
  ↓
Original URL
  ↓
Redirect
سرویس ما کد زیر را جستوجو میکند:
aB7xK2و آدرس زیر را پیدا میکند:
https://example.com/products/mobile/12345سپس سرور یک پاسخ تغییر مسیر ارسال میکند.
از نظر مفهومی:
HTTP 302 Found
Location: https://example.com/products/mobile/12345
مرورگر نیز به مقصد هدایت میشود.
۱۱. تفاوت ریدایرکت 301 و 302 چیست؟
این جزئیات کوچک، پیامدهای جالبی دارد.
ریدایرکت 301 — انتقال دائمی (Moved Permanently)
پاسخ 301 به کلاینت اعلام میکند که مقصد، دائمی در نظر گرفته شده است.
مرورگرها و واسطههای شبکه ممکن است ریدایرکتهای دائمی را بهشدت کش کنند.
این کار میتواند ترافیکی را که به سرویس کوتاهکننده لینک ما میرسد، کاهش دهد.
از نظر مقیاسپذیری، این یک مزیت است.
اما اگر بخواهیم تمام کلیکها از سیستم ما عبور کنند تا بتوانیم آنها را تحلیل کنیم، یا اگر مقصد لینکها قابل تغییر باشد، ممکن است با محدودیت مواجه شویم.
ریدایرکت 302 — انتقال موقت (Found / Temporary Redirect)
پاسخ 302 نشاندهنده یک تغییر مسیر موقت است.
احتمال کمتری وجود دارد که کلاینتها این نگاشت را برای همیشه ثابت فرض کنند.
در نتیجه، احتمال بیشتری دارد که درخواستها همچنان به سرویس ما برسند.
این رفتار زمانی مفید است که به قابلیتهای زیر نیاز داشته باشیم:
- تحلیل کلیکها
- تغییر مقصد لینکها
- آزمایش و تست
- منطق مسیریابی
هیچکدام از این دو روش در تمام شرایط «بهتر» نیستند.
انتخاب به نیازمندیهای محصول بستگی دارد.
دقیقا همین نوع مصالحهها و تصمیمهای مهندسی است که در مصاحبههای طراحی سیستم اهمیت دارد.
۱۲. اولین مشکل مقیاسپذیری
تصور کنید یک فرد مشهور لینک زیر را منتشر میکند:
short.ly/aB7xK2ناگهان ۱۰ میلیون نفر روی آن کلیک میکنند.
بدون کش، وضعیت به این شکل خواهد بود:
10,000,000 requests
        ↓
10,000,000 database queries
این تعداد درخواست به پایگاه داده غیرضروری است، زیرا تقریبا تمام کوئریها یک سوال یکسان میپرسند:
کد aB7xK2 به کدام آدرس اشاره میکند؟
اینجاست که Redis بسیار مفید میشود.
۱۳. اضافهکردن کش
معماری ما به شکل زیر تغییر میکند:
User
  |
  v
Load Balancer
  |
  v
URL Service
  |
  v
Redis
  |
  +---- HIT ----> Return URL
  |
  +---- MISS ---> Database
                    |
                    v
                Store result
                 in Redis
                    |
                    v
                 Redirect
حالا وقتی یک لینک محبوب درخواست میشود، ابتدا Redis را بررسی میکنیم:
GET aB7xK2اگر Redis اطلاعات زیر را داشته باشد:
کلید:
url:aB7xK2مقدار:
https://example.com/products/mobile/12345میتوانیم بلافاصله آدرس مقصد را برگردانیم.
دیگر نیازی به اجرای کوئری روی پایگاه داده نیست.
این روش معمولا الگوی Cache-Aside نامیده میشود: برنامه ابتدا کش را بررسی میکند، در صورت Cache Miss، داده را از پایگاه داده میخواند و سپس آن را در کش قرار میدهد تا درخواستهای بعدی سریعتر پاسخ داده شوند.
برای بار کاریای مانند تغییر مسیر URL که عمدتا شامل خواندن داده است، این الگو میتواند ترافیک پایگاه داده را بهشدت کاهش دهد.
۱۴. اگر URL در Redis وجود نداشته باشد چه میشود؟
این وضعیت یک Cache Miss است.
فرایند به شکل زیر خواهد بود:
Request
   ↓
Redis
   ↓
MISS
   ↓
Database
   ↓
Find URL
   ↓
Put URL into Redis
   ↓
Redirect
درخواست بعدی به این شکل پردازش میشود:
Request
   ↓
Redis
   ↓
HIT
   ↓
Redirect
در نتیجه، پاسخگویی بسیار سریعتر خواهد بود.
در یک سیستم واقعی، باید موضوعات دیگری را هم بررسی کنیم، از جمله:
- TTL یا مدت اعتبار داده در کش
- حذف دادهها از کش (Cache Eviction)
- دادههای منقضی یا قدیمی (Stale Entries)
- کلیدهای پرترافیک (Hot Keys)
- هجوم همزمان درخواستها هنگام انقضای کش (Cache Stampede)
- دسترسپذیری Redis
اما این موارد، موضوعات تکمیلی مناسبی هستند که پس از درک معماری پایه میتوانیم سراغ آنها برویم.
۱۵. مقیاسپذیرکردن لایه برنامه
در نهایت، یک سرور برنامه نیز به گلوگاه تبدیل میشود.
بنابراین، بهجای معماری زیر:
User
  ↓
Server
از معماری زیر استفاده میکنیم:
             Load Balancer
                    |
         +----------+----------+
         |          |          |
         v          v          v
      Server 1   Server 2   Server 3
         |          |          |
         +----------+----------+
                    |
                  Redis
                    |
Databaseسرویسهای URL ما در حالت ایدهآل باید Stateless باشند.
این یعنی سرور اول نباید اطلاعات حیاتیای داشته باشد که سرور دوم به آن دسترسی ندارد.
در نتیجه، هر درخواست میتواند به هر سرور سالمی ارسال شود.
با افزایش ترافیک، میتوانیم تعداد سرورها را افزایش دهیم:
3 servers → 10 servers → 100 serversبه این روش مقیاسپذیری افقی (Horizontal Scaling) میگویند.
۱۶. در نهایت، پایگاه داده هم باید مقیاسپذیر شود
فرض کنید سرویس ما میلیاردها لینک ذخیره میکند.
در چنین شرایطی، مقیاسدادن عمودی به یک پایگاه داده ممکن است دشوار شود.
میتوانیم دادهها را با استفاده از شاردینگ (Sharding) بین چند پایگاه داده توزیع کنیم.
یکی از روشهای ممکن:
hash(shortCode) % numberOfShardsبرای مثال:
aB7xK2 → DB Shard 1
xM91Qa → DB Shard 2
kL82Pt → DB Shard 3
معماری به این شکل خواهد بود:
URL Service
     |
     v
 Shard Router
     |
  +--+--+
  |  |  |
  v  v  v
 DB1 DB2 DB3
به این ترتیب، دادهها و ترافیک بین چند گره پایگاه داده توزیع میشوند.
البته شاردینگ چالشهای خاص خودش را ایجاد میکند:
- متعادلسازی مجدد دادهها (Rebalancing)
- ایجاد نقاط پرترافیک (Hotspots)
- پیچیدگی عملیاتی
- خرابی شاردها
- عملیات بین چند شارد
طراحی سیستم دقیقا درباره درک و مدیریت همین مصالحههاست.
هر راهکار مقیاسپذیری، پیچیدگی جدیدی به سیستم اضافه میکند.
۱۷. تحلیل دادهها چه میشود؟
تصور کنید کسبوکار ما میخواهد اطلاعات زیر را به دست آورد:
- چند نفر روی این لینک کلیک کردهاند؟
- در کدام کشور بودهاند؟
- از چه دستگاهی استفاده کردهاند؟
- چه زمانی کلیک کردهاند؟
-
کدام کمپین باعث این کلیک شده است؟
یک طراحی سادهانگارانه ممکن است به این شکل باشد:
Click
  ↓
Update analytics database
  ↓
Wait
  ↓
Redirect
این طراحی ایدهآل نیست، زیرا کاربر نباید برای پردازش دادههای تحلیلی منتظر بماند.
بهجای آن، از معماری زیر استفاده میکنیم:
              Click
                |
          +-----+-----+
          |           |
          v           v
       Redirect   Event Queue
                      |
                      v
               Analytics Consumer
                      |
                      v
                 Analytics DB
تغییر مسیر بلافاصله انجام میشود و پردازش دادههای تحلیلی بهصورت ناهمگام (Asynchronous) انجام خواهد شد.
رویداد کلیک میتواند از نظر مفهومی به شکل زیر باشد:
{
  "shortCode": "aB7xK2",
  "timestamp": "2026-09-15T10:30:00",
  "country": "IN",
  "device": "mobile"
}
صف پیام یا پلتفرم پردازش جریان داده به ما اجازه میدهد مسیر تغییر مسیر را از پردازشهای تحلیلی پاییندستی جدا کنیم.
این موضوع به یکی دیگر از اصول مهم طراحی سیستم منجر میشود:
تا حد امکان، عملیات غیرحیاتی را از مسیر اصلی پردازش درخواستهای کاربر جدا کنید.
۱۸. اگر بخشی از سیستم خراب شود چه اتفاقی میافتد؟
مقیاسپذیری بهتنهایی کافی نیست، ما به دسترسپذیری نیز نیاز داریم.
فرض کنید تنها پایگاه داده ما از کار بیفتد.
در این صورت، ممکن است میلیونها لینک کوتاهشده دیگر کار نکنند.
به همین دلیل، معماری محیط عملیاتی میتواند از تکثیر پایگاه داده (Database Replication) استفاده کند:
Primary Database
       |
   Replication
       |
   +---+---+
   |       |
   v       v
Replica 1  Replica 2
به همین ترتیب، نباید به موارد زیر بهعنوان تنها نقطه اتکای سیستم وابسته باشیم:
- یک سرور برنامه
- یک نمونه Redis
- یک Load Balancer
- یک پایگاه داده
راهبرد دقیق افزونگی (Redundancy) به سطح دسترسپذیری موردنیاز، مدل سازگاری دادهها، هزینه و زیرساخت بستگی دارد.
۱۹. کنار هم قرار دادن تمام اجزا
حالا معماری ما چیزی شبیه به این خواهد بود:
USERS
  |
  v
DNS / CDN
  |
  v
Load Balancer
  |
  +-----------------------------+
  |             |               |
  v             v               v
URL Service  URL Service    URL Service
  |             |               |
  +-------------+---------------+
                |
                v
           Redis Cluster
                |
                v
          Database Layer
           /     |     \
         DB1     DB2    DB3

URL Service
     |
     v
 Event Queue
     |
     v
Analytics Workers
     |
     v
 Analytics DB
بیایید نقش هر جزء را بهاختصار مرور کنیم.
Load Balancer: درخواستها را بین سرورهای برنامه توزیع میکند.
URL Service: ایجاد لینکهای کوتاه و تغییر مسیر آنها را مدیریت میکند.
ID Generator: شناسههای یکتا در سطح سیستم تولید میکند.
Base62 Encoder: شناسههای عددی را به رشتههای کوتاه و مناسب URL تبدیل میکند.
Redis: نگاشتهایی را که بهدفعات درخواست میشوند، با سرعت بالا در اختیار برنامه قرار میدهد.
Database: نگاشت پایدار زیر را ذخیره میکند:
shortCode → longURLMessage Queue / Stream: ردیابی کلیکها را از فرایند تغییر مسیر جدا میکند.
Analytics Service: رویدادهای کلیک را بهصورت ناهمگام پردازش میکند.
۲۰. مرور کامل فرایند ایجاد لینک کوتاه
بیایید یک بار دیگر تمام مراحل را مرور کنیم.
کاربر آدرس زیر را ارسال میکند:
https://example.com/products/mobile/12345سیستم ما مراحل زیر را طی میکند:
Long URL
   ↓
URL Service
   ↓
Generate Unique ID
   ↓
Base62 Encode
   ↓
aB7xK2
   ↓
Store in Database
   ↓
Return short.ly/aB7xK2
در پایگاه داده، نگاشت زیر ذخیره میشود:
aB7xK2 → https://example.com/products/mobile/12345تمام شد.
۲۱. مرور کامل فرایند تغییر مسیر
شخصی روی لینک زیر کلیک میکند:
short.ly/aB7xK2سپس فرایند زیر اجرا میشود:
User
  ↓
Load Balancer
  ↓
URL Service
  ↓
Check Redis
  ↓
Is it there?
   /     \
 YES     NO
  |       |
  |    Database
  |       |
  |    Get URL
  |       |
  |    Cache it
   \     /
    \   /
     URL
      |
      v
Redirectهمزمان، رویداد کلیک وارد مسیر تحلیل داده میشود:
Click Event
     ↓
Message Queue
     ↓
Analytics Service
     ↓
Analytics DB
این معماری یک کوتاهکننده لینک مقیاسپذیر را تشکیل میدهد.
۲۲. نکات مهم امنیتی و مقابله با سوءاستفاده
یک کوتاهکننده لینک در محیط عملیاتی با مشکل دیگری نیز روبهرو است که گاهی در طراحیهای مقدماتی نادیده گرفته میشود:
کاربران میتوانند لینکهای مخرب را نیز کوتاه کنند.
مهاجم ممکن است از این پلتفرم برای موارد زیر استفاده کند:
- فیشینگ (Phishing)
- انتشار لینکهای بدافزار
- هرزنامه (Spam)
- تولید خودکار تعداد زیادی URL
- سوءاستفاده از قابلیت تغییر مسیر
بنابراین، یک سرویس واقعی ممکن است به سازوکارهای زیر نیاز داشته باشد:
Rate Limiting
      +
Abuse Detection
      +
URL Validation
      +
Domain Reputation Checks
      +
User / IP Controls
محدودسازی نرخ درخواست (Rate Limiting) میتواند تعداد URLهایی را که یک کاربر یا آدرس IP در یک بازه زمانی مشخص ایجاد میکند، محدود کند.
این موضوع دلیل دیگری است که نشان میدهد مسئله ساده طراحی یک کوتاهکننده لینک در مصاحبهها، میتواند در عمل به پلتفرمی نسبتا پیچیده تبدیل شود.
۲۳. این مسئله چه چیزهایی به شما میآموزد؟
طراحی یک کوتاهکننده لینک ممکن است ساده به نظر برسد، اما تا اینجا با مفاهیم متعددی آشنا شدهایم.
- طراحی API: نحوه تعامل کلاینتها با سیستم
- طراحی پایگاه داده: نحوه ذخیره و بازیابی نگاشتها
- کدگذاری Base62: تبدیل شناسههای بزرگ به رشتههای کوتاه
- تولید شناسه توزیعشده: تولید شناسههای یکتا توسط چندین سرور
- کش: محافظت از پایگاه داده در برابر خواندنهای تکراری با استفاده از Redis
- توزیع بار: تقسیم درخواستها بین سرورها
- مقیاسپذیری افقی: افزایش ظرفیت برنامه با افزودن ماشینها
- شاردینگ پایگاه داده: توزیع مجموعهدادههای بزرگ
- تکثیر دادهها (Replication): بهبود دسترسپذیری
- صف پیام: ارتباط ناهمگام بین سرویسها
- خط لوله تحلیل دادهها (Analytics Pipeline): پردازش رویدادهای کلیک بدون کندکردن تغییر مسیر
- محدودسازی نرخ و امنیت: محافظت از سرویس در برابر سوءاستفاده
به همین دلیل، این مسئله یکی از نقطههای شروع مفید برای یادگیری طراحی سیستم است.
۲۴. در مصاحبه چگونه به این مسئله پاسخ بدهم؟
اگر مصاحبهکننده از شما بپرسد:
TinyURL را طراحی کن.
نباید بلافاصله شروع به ترسیم Redis، Kafka، شاردهای پایگاه داده و ۱۵ میکروسرویس کنید.
از سادهترین طراحی شروع کنید.
یک روند مناسب به این شکل است:
مرحله ۱ — نیازمندیها
«چه قابلیتهایی لازم داریم و سیستم قرار است در چه مقیاسی کار کند؟»
↓
مرحله ۲ — APIها
POST /urls
GET /{shortCode}
↓
مرحله ۳ — مدل داده
shortCode → longURL↓
مرحله ۴ — تولید کد کوتاه
Unique ID → Base62↓
مرحله ۵ — معماری پایه
Client → Service → Database↓
مرحله ۶ — شناسایی گلوگاه
ترافیک تغییر مسیر عمدتا شامل خواندن داده است.
↓
مرحله ۷ — اضافهکردن کش
Service → Redis → Database↓
مرحله ۸ — مقیاسپذیری افقی
Load Balancer → Multiple Services↓
مرحله ۹ — مقیاسپذیری ذخیرهسازی
در صورت نیاز، دادهها را پارتیشنبندی یا شارد کنید.
↓
مرحله ۱۰ — تحلیل دادهها
پردازش کلیکها را به یک خط لوله ناهمگام منتقل کنید.
↓
مرحله ۱۱ — قابلیت اطمینان و امنیت
تکثیر دادهها، Failover، محدودسازی نرخ و تشخیص سوءاستفاده را در نظر بگیرید.
این روند چیزی بسیار مهمتر از حفظکردن یک نمودار معماری را نشان میدهد:
شما میدانید هر جزء چرا وجود دارد.
۲۵. مهمترین درس
مهمترین درس این مسئله، Base62 نیست.
Redis هم نیست.
شاردینگ پایگاه داده نیز نیست.
درس اصلی این است:
طراحی سیستم خوب یعنی از یک راهحل ساده شروع کنیم، نقاطی را که سیستم در آنها دچار مشکل خواهد شد شناسایی کنیم و فقط زمانی پیچیدگی اضافه کنیم که آن پیچیدگی، مسئلهای واقعی را حل کند.
ما کار را با این معماری شروع کردیم:
Application → Databaseسپس ترافیک افزایش پیدا کرد.
بنابراین، این اجزا را اضافه کردیم:
Load Balancer + Multiple Serversتعداد درخواستهای خواندن افزایش یافت.
پس Redis را اضافه کردیم.
حجم دادهها افزایش پیدا کرد.
بنابراین، شاردینگ را بهعنوان یک راهکار احتمالی بررسی کردیم.
تحلیل دادهها اهمیت پیدا کرد.
پس این معماری را اضافه کردیم:
Message Queue → Analytics Pipelineخرابیها دیگر قابلقبول نبودند.
بنابراین، تکثیر دادهها و افزونگی را اضافه کردیم:
Replication + Redundancyاین همان طرز تفکری است که پشت طراحی سیستم قرار دارد.
معماریها را حفظ نکنید، درک کنید که چرا معماری در طول زمان تغییر کرده است.
وقتی این موضوع را درک کنید، طراحی سیستمهای بسیار بزرگتر نیز بهمراتب آسانتر خواهد شد.
منابع پیشنهادی برای یادگیری بیشتر
اگر میخواهید عمیقتر یاد بگیرید، پس از درک طراحی پایه، منابع زیر مفید هستند.
۱. Redis — الگوی Cache-Aside
مستندات رسمی Redis این الگو را بهتفصیل توضیح میدهد: ابتدا Redis را بررسی کنید، در صورت Cache Miss به پایگاه داده اصلی مراجعه کنید و سپس داده را برای درخواستهای بعدی در کش قرار دهید.
موضوعاتی که باید بررسی کنید:
- Cache Hit و Cache Miss
- TTL
- بیاعتبارسازی کش (Cache Invalidation)
- Cache Stampede
- معماریهای مبتنی بر خواندن زیاد
عبارت پیشنهادی برای جستوجو در مستندات Redis:
Redis Cache-Aside۲. روش تولید شناسه Snowflake در Twitter/X
روش تولید شناسه Snowflake را مطالعه کنید تا متوجه شوید سیستمهای توزیعشده چگونه میتوانند بدون وابستگی به یک دنباله شناسه متمرکز در پایگاه داده، شناسههای یکتا تولید کنند.
روی این اجزا تمرکز کنید:
Timestamp
    +
Machine / Worker ID
    +
Sequence Number
این موضوع برای یادگیری مفاهیم زیر مفید است:
- تولید شناسه در سیستمهای توزیعشده
- هماهنگسازی (Coordination)
- مقیاسپذیری
- ترتیب شناسهها
- چالشهای مرتبط با ساعت سیستم
۳. ریدایرکتهای HTTP — مستندات MDN
درباره کدهای وضعیت تغییر مسیر HTTP مطالعه کنید، بهویژه:
301 — Moved Permanently: انتقال دائمی302 — Found: تغییر مسیر موقت
درک خود پروتکل HTTP باعث میشود طراحی کوتاهکننده لینک را بهتر بفهمید.
عبارت پیشنهادی برای جستوجو در مستندات MDN:
Redirections in HTTP۴. کتاب Designing Data-Intensive Applications
Designing Data-Intensive Applications
نویسنده: Martin Kleppmann
این کتاب منبعی عمیقتر برای درک معماری سیستمهای دادهمحور است و موضوعاتی مانند موارد زیر را پوشش میدهد:
- تکثیر دادهها (Replication)
- پارتیشنبندی (Partitioning)
- سیستمهای توزیعشده
- سازگاری دادهها (Consistency)
- موتورهای ذخیرهسازی
- جریانهای داده (Streams)
- پردازش دستهای (Batch Processing)
لازم نیست مطالب این کتاب را برای مصاحبه حفظ کنید. از آن برای درک این موضوع استفاده کنید که چرا سیستمهای توزیعشده به شکل خاصی رفتار میکنند.
خلاصه معماری نهایی
اگر قرار باشد فقط یک نمودار از این مقاله به خاطر بسپارید، این نمودار را به خاطر بسپارید:
              USERS
                |
                v
          Load Balancer
                |
       +--------+--------+
       |        |        |
       v        v        v
    Service  Service  Service
       |        |        |
       +--------+--------+
                |
              Redis
                |
            Cache Miss
                |
                v
             Database
                |
                v
             Long URL
                |
                v
             Redirect
                +
                |
            Click Event
                |
                v
          Message Queue
                |
                v
        Analytics Service
                |
                v
           Analytics DB
و دو جریان اصلی را به خاطر بسپارید:
۱. کوتاهکردن لینک (Shorten)
Long URL
   → Unique ID
   → Base62
   → Store Mapping
   → Short URL
۲. تغییر مسیر (Redirect)
Short Code
   → Redis
   → Database if needed
   → Long URL
   → Redirect
اگر این دو جریان را بهخوبی درک کرده باشید، پایههای مسئله طراحی سیستم کوتاهکننده لینک را یاد گرفتهاید.
هدف ساده است:
طراحی سیستم را با درک نحوه کار سیستمها یاد بگیرید، نه با حفظکردن نمودارهای معماری.
دیدگاهها
ثبت دیدگاه