اگر برای مصاحبه طراحی سیستم آماده میشوید و به دنبال مسائل رایج طراحی سیستم و منابع آموزشی هستید، جای درستی آمدهاید.
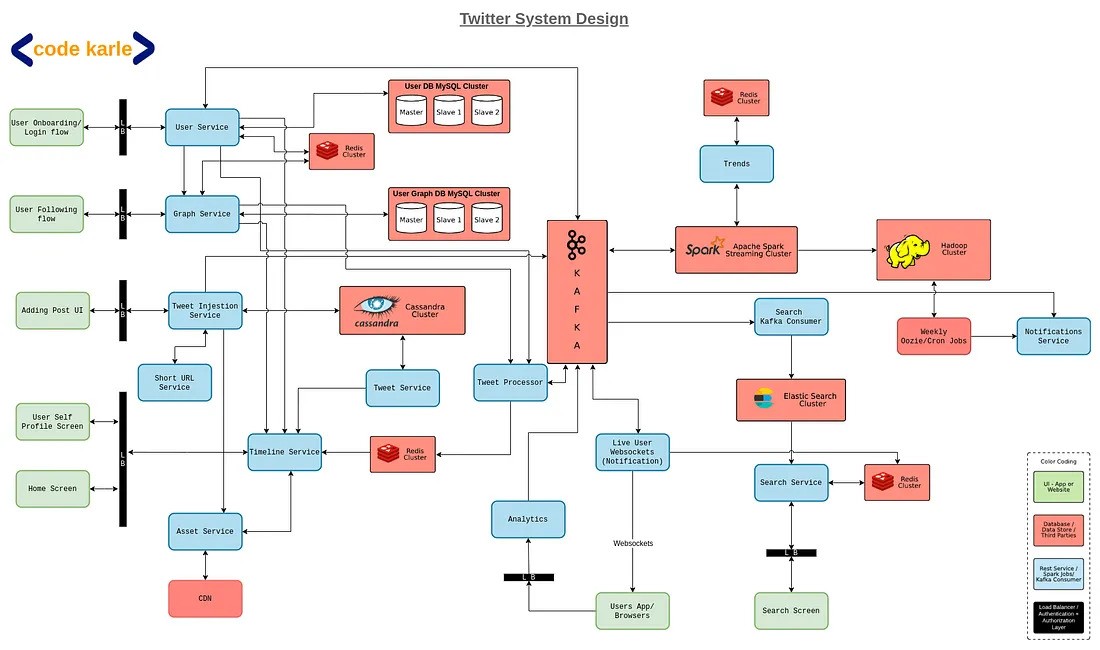
امروز میخواهم یکی از مسائل محبوب طراحی سیستم را بررسی کنم: طراحی توییتر یا X.com.
طراحی سیستمی پیچیده مانند توییتر میتواند چالشبرانگیز باشد، بهویژه در مصاحبه طراحی سیستم.
بزرگترین چالش، پیچیدگی سیستم نیست، بلکه محدودیت زمانی است. شما باید در مدت ۴۰ دقیقه مصاحبهکننده را متقاعد کنید که دانش و مهارت لازم را دارید. این کار تنها زمانی امکانپذیر است که بهخوبی آماده شده باشید و هنگام پاسخدادن به چنین سوالاتی، از یک رویکرد ساختاریافته پیروی کنید.
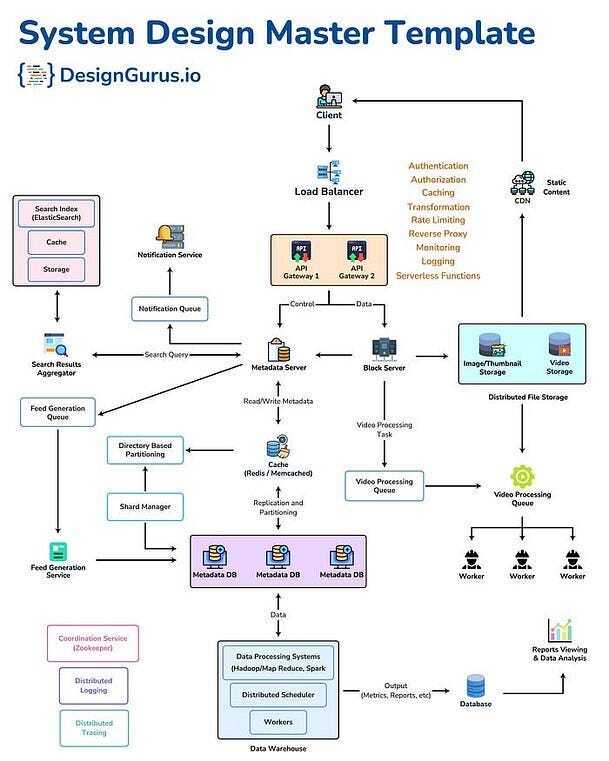
در این آموزش طراحی سیستم، یک راهنمای ساده و یک الگوی طراحی سیستم نیز ارائه میکنم تا بتوانید افکارتان را سازماندهی کنید و طراحی خود را بهشکلی شفاف ارائه دهید.
اگر برای مصاحبههای طراحی سیستم آماده میشوید و میخواهید در مدتزمان محدودی این مهارت را یاد بگیرید، میتوانید وبسایتهایی مانند ByteByteGo، Design Guru، Exponent، Educative، Bugfree.ai و Udemy را بررسی کنید. این وبسایتها دورههای آموزشی خوبی در زمینه طراحی سیستم ارائه میدهند.
همچنین هنگام پاسخدادن به سوالات طراحی سیستم، میتوانید از یک الگوی مشخص، مانند الگوی ارائهشده در DesignGurus.io، استفاده کنید تا پاسخ خود را در زمان محدود بهتر بیان کنید.
در واقع، پیروی از چنین الگویی یکی از بهترین کارهایی است که میتوانید برای شروع آمادگی خود برای هر مصاحبه طراحی سیستم انجام دهید.
حالا به سراغ مسئله و راهحل آن برویم.
چگونه یک اپلیکیشن پیامرسان مانند توییتر یا X.com طراحی کنیم؟
طراحی سیستمی مانند توییتر یکی از سناریوهای رایج در مصاحبههای طراحی سیستم است. اگر میخواهید این مسئله را از ابتدا تمرین کنید، میتوانید از Codemia.io استفاده کنید، پلتفرمی شبیه LeetCode که برای تمرین مصاحبههای طراحی سیستم طراحی شده است.
این پلتفرم بیش از ۱۲۰ مسئله طراحی سیستم دارد و تعداد آنها همچنان در حال افزایش است. همچنین راهحلهای تشریحی ارائه میکند که مهندسان ارشد شرکتهای معتبر آنها را تهیه کردهاند. برخی از سوالات رایگان هستند و طراحی توییتر نیز یکی از آنهاست.
بازگردیم به خود مسئله. طراحی توییتر فرصت بسیار خوبی برای نشاندادن درک شما از سیستمهای توزیعشده در مقیاس بزرگ است، زیرا جنبههای مختلفی مانند مدیریت تعداد بسیار زیاد کاربران، تضمین دسترسپذیری بالا و حفظ پایداری در شرایط بار سنگین را در بر میگیرد.
این راهنمای طراحی، فرایند طراحی توییتر را مرحلهبهمرحله بررسی میکند و موضوعات زیر را پوشش میدهد: نیازمندیهای سیستم، تخمین ظرفیت، طراحی API، طراحی پایگاه داده، طراحی سطح بالا، جریان درخواستها، طراحی تفصیلی اجزا، مصالحههای فنی و سناریوهای احتمالی خرابی.
در پایان این راهنما، درک مناسبی از نحوه رویکرد به چنین مسئلهای و ارائه راهحل آن در مصاحبه خواهید داشت.
۱. نیازمندیهای سیستم توییتر
اولین قدم، مشخصکردن درست نیازمندیهاست. این کار با تعیین نیازمندیهای عملکردی آغاز میشود.
اگر قصد دارید یک اپلیکیشن واقعی، مانند خرید از آمازون یا ارسال پیام در فیسبوک و توییتر را بازطراحی کنید، بهتر است اپلیکیشنی را انتخاب کنید که با آن آشنایی بیشتری دارید.
نیازمندیهای عملکردی (Functional Requirements)
برای طراحی سیستمی قدرتمند و کاربرپسند شبیه توییتر، باید قابلیتهای اصلی آن را مشخص کنیم.
کاربران باید بتوانند توییت بنویسند و منتشر کنند، این قابلیت، عملکرد اصلی پلتفرم است.
این فرایند شامل ایجاد یک توییت جدید، افزودن فایلهای رسانهای اختیاری و بهاشتراکگذاری آن با دنبالکنندگان است. علاوه بر این، کاربران باید بتوانند حسابهای دیگران را دنبال کنند تا بهروزرسانیهای آنها را در فید خود ببینند.
این قابلیت به مدیریت فهرست حسابهای دنبالشده و اطمینان از نمایش توییتهای آنها در تایملاین کاربر نیاز دارد.
قابلیت مهم دیگر، امکان پسندیدن توییتهاست. کاربران با این کار علاقه خود را نشان میدهند و ممکن است بخواهند توییتهای موردنظرشان را برای مراجعه در آینده ذخیره کنند.
نیازمندیهای عملکردی اصلی عبارتاند از:
- نوشتن و انتشار توییت: کاربران باید بتوانند توییت ایجاد و منتشر کنند.
- دنبالکردن کاربران: کاربران باید بتوانند حسابهای دیگران را دنبال کنند و بهروزرسانیهای آنها را ببینند.
- پسندیدن توییتها: کاربران باید بتوانند توییتها را لایک کنند و علاقه خود را نشان دهند.
نیازمندیهای غیرعملکردی (Non-Functional Requirements)
برای پلتفرمی در مقیاس توییتر، نیازمندیهای غیرعملکردی اهمیت زیادی دارند.
مقیاسپذیری (Scalability) اهمیت ویژهای دارد، زیرا سیستم باید بتواند تعداد بسیار زیادی از کاربران، توییتها و تعاملات را بدون افت عملکرد مدیریت کند.
دسترسپذیری بالا (High Availability) تضمین میکند که پلتفرم حتی در ساعات اوج ترافیک یا هنگام خرابی سختافزار نیز در دسترس و قابل استفاده باقی بماند.
پایداری (Stability) نیز یکی دیگر از جنبههای مهم است. سرویس باید قابلاعتماد باشد، زمان ازکارافتادگی حداقلی داشته باشد و حتی در شرایط همزمانی بالا، عملکرد یکنواختی ارائه دهد.
نیازمندیهای غیرعملکردی اصلی که باید در مصاحبه مطرح کنید عبارتاند از:
- مقیاسپذیری: سیستم باید تعداد زیادی کاربر، توییت و تعامل را مدیریت کند.
- دسترسپذیری بالا: سیستم باید حتی در شرایط ترافیک سنگین نیز در دسترس باشد.
- پایداری: سیستم باید پایدار باشد و بدون اختلال یا قطعی مکرر به کار خود ادامه دهد.
۲. تخمین ظرفیت (Capacity Estimation)
تخمین تعداد کاربران، نخستین قدم برای درک مقیاس سیستم است. در این طراحی فرض میکنیم سیستم ۵۰۰ میلیون کاربر دارد. این فرض به ما کمک میکند بار مورد انتظار و زیرساخت موردنیاز برای پشتیبانی از چنین تعداد زیادی کاربر را تخمین بزنیم.
تعداد کاربران
فرض میکنیم تعداد کاربران سیستم ۵۰۰ میلیون نفر باشد.
ترافیک سیستم (Traffic)
برای درک میزان فعالیت روزانه، باید ترافیک سیستم را تخمین بزنیم.
فرض کنیم هر کاربر روزانه یک توییت منتشر کند. در این صورت، روزانه ۵۰۰ میلیون توییت خواهیم داشت.
همچنین اگر هر کاربر روزانه ۱۰ صفحه از فید صفحه اصلی خود را مشاهده کند، تعداد عملیات خواندن بسیار زیاد خواهد بود.
روابط دنبالکردن کاربران نیز پیچیدگی سیستم را افزایش میدهند. اگر هر کاربر بهطور میانگین ۱۰۰ حساب را دنبال کند، در مجموع ۵۰ میلیارد رابطه دنبالکردن خواهیم داشت.
در نهایت، اگر هر کاربر روزانه ۵ توییت را لایک کند، تعداد عملیات لایک به ۲٫۵ میلیارد مورد در روز میرسد.
در ادامه، مهمترین فرضهای ترافیکی را مرور میکنیم:
- توییتها: روزانه ۵۰۰ میلیون توییت، با فرض انتشار یک توییت بهازای هر کاربر.
- فید صفحه اصلی (Home Feed): هر کاربر روزانه ۱۰ صفحه از فید خود را مشاهده میکند.
- دنبالکردن کاربران (Following): هر کاربر بهطور میانگین ۱۰۰ حساب را دنبال میکند که در مجموع به ۵۰ میلیارد رابطه دنبالکردن منجر میشود.
- لایکها (Favorites): هر کاربر روزانه ۵ توییت را لایک میکند که به معنای ۲٫۵ میلیارد عملیات لایک در روز است.
تعداد درخواست در ثانیه (QPS)
محاسبه تعداد درخواستها در ثانیه (Queries Per Second یا QPS) به ما کمک میکند بار لحظهای سیستم را بهتر درک کنیم.
برای عملیات نوشتن، حدود ۱۵ هزار درخواست در ثانیه، برای عملیات خواندن، حدود ۷۵ هزار درخواست در ثانیه، و برای عملیات لایک، حدود ۳۰ هزار درخواست در ثانیه تخمین زده میشود.
این اعداد به برنامهریزی زیرساخت موردنیاز و راهبردهای توزیع بار کمک میکنند.
محاسبات ارائهشده به این صورت هستند:
- نوشتن (Write): حدود ۱۵ هزار QPS
- خواندن (Read): حدود ۷۵ هزار QPS
- لایکها (Favorites): حدود ۳۰ هزار QPS
فرمول کلی محاسبه به شکل زیر است:
\[ QPS = \frac{\text{تعداد کاربران} \times \text{تعداد عملیات روزانه هر کاربر}}{3600 \times 24} \]حجم دادهها (Data Size)
درک حجم دادهها برای برنامهریزی فضای ذخیرهسازی ضروری است.
با فرض انتشار ۵۰۰ میلیون توییت در روز و میانگین حجم ۳۰۰ بایت برای هر توییت، حجم دادههای جدید روزانه حدود ۱۴۰ گیگابایت و حجم سالانه آن حدود ۵۰ ترابایت خواهد بود.
برای محتوای رسانهای، اگر فرض کنیم حجم آن ۱۰۰ برابر حجم توییتها باشد، حجم دادهها به حدود ۱۰ ترابایت در روز یا ۴ پتابایت در سال میرسد.
این تخمین نشان میدهد که به یک معماری ذخیرهسازی توزیعشده نیاز داریم.
خلاصه تخمین حجم دادهها:
- توییتها: روزانه ۵۰۰ میلیون توییت، با حداکثر ۱۴۰ کاراکتر و حجم متوسط ۳۰۰ بایت برای هر توییت. این مقدار به حدود ۱۴۰ گیگابایت در روز و ۵۰ ترابایت در سال میرسد.
- رسانهها (تصاویر و ویدئوها): با فرض حجمی ۱۰۰ برابر حجم توییتها، حدود ۱۰ ترابایت در روز و ۴ پتابایت در سال.
۳. طراحی API
طراحی API یکی دیگر از بخشهای مهم در مصاحبههای طراحی سیستم است.
انتشار توییت (Tweeting)
APIهای انتشار توییت باید ایجاد و ارسال توییتها را بهشکل کارآمد مدیریت کنند. این فرایند شامل دریافت اطلاعات کاربر، محتوای توییت، اطلاعات مکانی و زمان انتشار است.
مدیریت صحیح خطاها و اعتبارسنجی دادهها نیز برای ارائه تجربه کاربری روان ضروری است.
public Result postTweet(Long userId, String tweetText, String location, DateTime date);دنبالکردن کاربران (Following)
قابلیت دنبالکردن کاربران به APIهایی برای مدیریت روابط بین حسابها نیاز دارد. این APIها باید دنبالکردن و لغو دنبالکردن را مدیریت کنند، یکپارچگی دادهها را حفظ کنند و فهرست حسابهای دنبالشده را بهموقع بهروزرسانی کنند.
public Result followUser(Long userId, Long followedUserId);

public Result unfollowUser(Long userId, Long followedUserId);لایککردن توییتها (Favorites)
APIهای مربوط به لایک به کاربران اجازه میدهند توییتها را لایک کنند یا لایک خود را بردارند.
این عملیات باید کارآمد باشند. استفاده از ایندکسهای مناسب و مدیریت صحیح خطاها برای بهروزرسانی سریع و محاسبه دقیق تعداد لایکهای هر توییت ضروری است.
public Result favoriteTweet(Long userId, Long tweetId);

public Result unfavoriteTweet(Long userId, Long tweetId);
API دریافت فید
API دریافت فید برای واکشی و نمایش توییتهای منتشرشده توسط حسابهای دنبالشده ضروری است.
این API به کوئریهای کارآمد و صفحهبندی (Pagination) نیاز دارد تا زمان بارگذاری کاهش یابد و تجربه کاربری روانی فراهم شود.
public Result getFeeds(Long userId, String location, int pageNo);۴. طراحی پایگاه داده (Database Design)
پس از طراحی API، به سراغ طراحی پایگاه داده میرویم.
جدولها (Tables)
در طراحی پایگاه داده باید جدولهایی برای کاربران، توییتها و روابط دنبالکردن تعریف کنیم.
جدول UserInfo اطلاعات کاربران را ذخیره میکند، جدول Tweets محتوای توییتها و فرادادههای آنها را نگه میدارد و جدول Follower روابط دنبالکردن کاربران را مدیریت میکند.
استفاده از ایندکسهای مناسب برای جستوجو و بهروزرسانی سریع ضروری است.
جدول UserInfo
userId: شناسه کاربر، کلید اصلی (Primary Key)userName: نام کاربریstatus: وضعیت کاربرotherProfile: سایر اطلاعات پروفایل، مانند تصویر آواتار و سن
جدول Tweets
tweetId: شناسه توییت، کلید اصلیuserId: شناسه کاربر، دارای ایندکسcontent: محتوای توییتpostTime: زمان انتشار، دارای ایندکسmodifyTime: زمان ویرایشstatus: وضعیت توییت
جدول Follower
userId: شناسه کاربرfollowerId: شناسه دنبالکننده، دارای ایندکسfollowedTime: زمان دنبالکردن
ذخیرهسازی (Storage)
انتخاب راهکار مناسب ذخیرهسازی اهمیت زیادی دارد.
برای دادههای ساختاریافته، مانند پروفایل کاربران و توییتها، MySQL گزینه مناسبی است زیرا از کوئریهای پیچیده و تراکنشها پشتیبانی میکند.
برای ذخیره محتوای رسانهای، Amazon S3 امکان ذخیرهسازی مقیاسپذیر و مقرونبهصرفه تصاویر و ویدئوها را فراهم میکند.
بنابراین، انتخابهای پیشنهادی عبارتاند از:
- استفاده از MySQL برای دادههای ساختاریافته، شامل کاربران، توییتها و روابط دنبالکردن.
- استفاده از Amazon S3 برای ذخیره تصاویر و ویدئوها.
۵. طراحی سطح بالا (High-Level Design)
ابتدا طراحی سطح بالای سیستم را بررسی میکنیم.
لایه کلاینت (Client Layer)
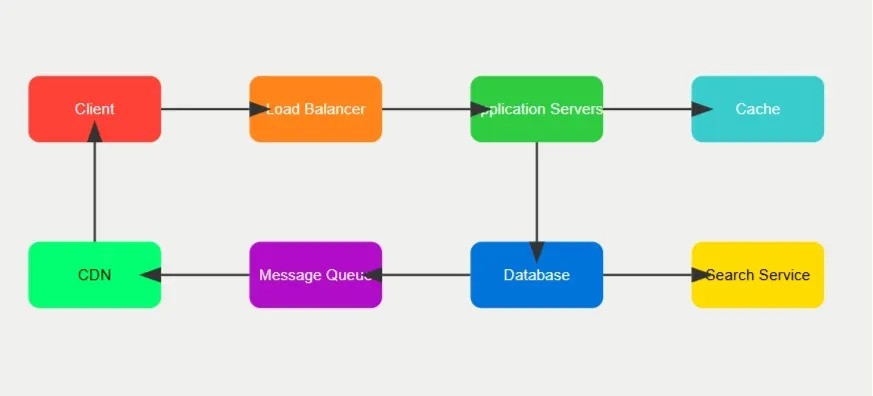
لایه کلاینت شامل وبسایتها و اپلیکیشنهایی است که درخواستها را به سرور ارسال میکنند.
درخواستها از طریق توزیعکننده بار (Load Balancer) میان سرورها توزیع میشوند تا بار بهشکل متعادل تقسیم شود و دسترسپذیری بالا بماند.
استفاده از شبکه توزیع محتوا (CDN) برای فایلهای ایستا نیز تاخیر را کاهش میدهد و سرعت بارگذاری را افزایش میدهد.
اجزای اصلی این لایه عبارتاند از:
- کلاینتها، شامل وبسایتها و اپلیکیشنها، درخواستها را به سرور ارسال میکنند.
- درخواستها از طریق Load Balancer توزیع میشوند.
- برای محافظت از سرورهای بکاند، از محدودکننده نرخ درخواست (Rate Limiter) استفاده میشود.
- برای ارائه فایلهای ایستا، تصاویر و ویدئوها، از CDN استفاده میشود.
لایه سرور (Server Layer)
در لایه سرور، خوشههایی از سرورها درخواستها را پردازش میکنند و مسئولیتها میان سرویسهای مختلف تقسیم میشود.
سرویسهای اصلی عبارتاند از:
- Tweet Service: مسئول انتشار توییتها.
- User Service: مسئول ثبتنام کاربران و مدیریت پروفایل آنها.
- Follow Service: مسئول دنبالکردن و لغو دنبالکردن کاربران.
- Home Feed Service: مسئول تولید و نمایش فید کاربران.
لایه داده (Data Layer)
در لایه داده، برای افزایش سرعت پاسخگویی از Redis بهعنوان کش استفاده میشود.
همچنین MySQL با معماری مستر ـ اسلیو (Master-Slave) برای ذخیرهسازی پایدار دادهها به کار میرود تا سازگاری و دسترسپذیری دادهها تامین شود.
Amazon S3 نیز برای ذخیره فایلهای رسانهای استفاده میشود و امکان ذخیرهسازی مقیاسپذیر و بادوام را فراهم میکند.
انتخابهای اصلی این لایه عبارتاند از:
- استفاده از Redis برای کشکردن دادهها و افزایش سرعت پاسخگویی.
- استفاده از MySQL با معماری مستر ـ اسلیو برای سازگاری و دسترسپذیری دادهها.
- استفاده از Amazon S3 برای ذخیره فایلهای رسانهای.
جریان درخواست (Request Flow)
بررسی جریان درخواست به ما کمک میکند تعامل میان اجزای مختلف سیستم را درک کنیم.
هنگامی که کلاینت درخواستی ارسال میکند، درخواست ابتدا به Load Balancer میرسد و سپس به سرور مناسب هدایت میشود.
سرور درخواست را پردازش میکند، پایگاه داده را بهروزرسانی میکند و دادههای موردنیاز را در کش قرار میدهد.
در درخواستهای خواندن، دادهها از کش یا پایگاه داده دریافت میشوند و فایلهای رسانهای از طریق CDN ارائه میشوند تا زمان پاسخگویی کاهش یابد.
مراحل جریان درخواست عبارتاند از:
- کلاینت درخواست را به Load Balancer ارسال میکند.
- Load Balancer درخواست را به یکی از سرورها هدایت میکند.
- Rate Limiter میزان ترافیک را بررسی میکند.
- سرور درخواست را پردازش میکند و دادهها را در MySQL و Redis ذخیره یا بهروزرسانی میکند.
- فایلهای رسانهای از طریق CDN ارائه میشوند.
- برای درخواستهای خواندن، سرور دادهها را از Redis یا MySQL دریافت میکند و فایلهای رسانهای از طریق CDN در اختیار کلاینت قرار میگیرند.
۶. طراحی تفصیلی اجزا (Detailed Component Design)
اکنون طراحی تفصیلی اجزا و مولفههای معماری نرمافزار را بررسی میکنیم که میتوان برای طراحی توییتر از آنها استفاده کرد.
توزیعکننده بار (Load Balancer)
استقرار چند توزیعکننده بار در قالب یک خوشه، دسترسپذیری بالا و توزیع متعادل بار را تضمین میکند.
قرار دادن توزیعکنندههای بار در مناطق جغرافیایی مختلف، تاخیر کاربران را کاهش میدهد. همچنین استفاده از الگوریتمهایی مانند Round Robin یا Least Connections به مدیریت کارآمد بار کمک میکند.
راهکارهای پیشنهادی عبارتاند از:
- استقرار چند Load Balancer در یک خوشه.
- قرار دادن توزیعکنندههای بار در مناطق مختلف برای کاهش تاخیر.
- استفاده از الگوریتمهایی مانند Round Robin، Least Connections یا IP Hash.
شبکه توزیع محتوا (CDN)
استفاده از CDN برای محتوای ایستا، بار سرور مبدا (Origin Server) را کاهش میدهد و زمان بارگذاری را بهبود میبخشد.
بهینهسازی قوانین کش و تنظیم مقدار TTL به افزایش نرخ برخورد کش (Cache Hit Ratio) کمک میکند و باعث میشود محتوا با سرعت بیشتری در اختیار کاربران قرار گیرد.
راهکارهای پیشنهادی عبارتاند از:
- استفاده از هر دو روش کشکردن Pull و Push.
- بهینهسازی قوانین کش و TTL برای افزایش نرخ برخورد کش.
- افزایش مقیاس سیستم با اضافهکردن گرههای سرور جدید.
ردیس (Redis)
برای استفاده از Redis در مقیاس بزرگ، میتوان یک خوشه Redis راهاندازی کرد و برای افزایش دسترسپذیری، از تکثیر مستر ـ اسلیو استفاده کرد.
Redis Sentinel وضعیت خوشه را پایش میکند و هنگام خرابی یک گره، فرایند انتقال وظایف به گره جایگزین (Failover) را مدیریت میکند. این سازوکار کمک میکند کش حتی هنگام خرابی گرهها در دسترس باقی بماند.
راهکارهای پیشنهادی عبارتاند از:
- استفاده از Redis Cluster برای دادههای حجیم و سیستمهای بزرگمقیاس.
- استفاده از تکثیر مستر ـ اسلیو برای افزایش دسترسپذیری.
- استفاده از Sentinel برای پایش خوشه و مدیریت Failover.
مایاسکیوال (MySQL)
معماری مستر ـ اسلیو در MySQL از ترافیک بالا پشتیبانی میکند. تکثیر دادهها (Replication) نیز به حفظ سازگاری و دسترسپذیری دادهها کمک میکند.
پارتیشنبندی افقی (Horizontal Partitioning) امکان توزیع بار میان چند سرور را فراهم میکند و به مدیریت کارآمد مجموعهدادههای بزرگ کمک میکند.
راهکارهای پیشنهادی عبارتاند از:
- استفاده از معماری مستر ـ اسلیو برای مدیریت ترافیک بالا.
- استفاده از پارتیشنبندی افقی برای مدیریت حجم بیشتر دادهها.
۷. مصالحهها و انتخاب فناوریها (Trade-offs and Tech Choices)
این بخش احتمالا مهمترین قسمت مصاحبه است. در ادامه، انتخابهای فنی مطرحشده در مقاله را بررسی میکنیم.
پایگاه داده (Database)
انتخاب MySQL بهجای NoSQL به نیاز سیستم به کوئریهای پیچیده و پشتیبانی از تراکنشها مربوط میشود.
اگرچه پایگاههای داده NoSQL انعطافپذیری بیشتری در ساختار دادهها ارائه میدهند، طبق استدلال مقاله، برای مدل کسبوکار توییتر به دادههای ساختاریافته و تراکنشهای پیچیده نیاز داریم، بنابراین MySQL انتخاب مناسبی در نظر گرفته شده است.
کش (Cache)
Redis نسبت به Memcached ترجیح داده شده است، زیرا از انواع مختلف داده پشتیبانی میکند و قابلیتهای مقیاسپذیری افقی دارد.
Memcached برای ذخیرهسازی ساده کلید ـ مقدار (Key-Value) کارآمد است، اما Redis امکانات پیشرفتهتری ارائه میدهد و برای سیستمهای بزرگمقیاس مناسب است.
۸. سناریوهای خرابی و گلوگاهها (Failure Scenarios and Bottlenecks)
مدل ترکیبی (Hybrid Model)
برای مدیریت کاربرانی که تعداد زیادی حساب را دنبال میکنند، میتوان از یک مدل ترکیبی شامل دو رویکرد Pull و Push استفاده کرد. این ترکیب میتواند تاخیر را کاهش دهد.
برای کاربرانی که افراد زیادی را دنبال میکنند، ارسال توییتهای جدید به فید کاربران از طریق رویکرد Push، بار پردازش هنگام تجمیع فید را کاهش میدهد و تجربه کاربری را بهبود میبخشد.
راهکار پیشنهادی:
- اگر کاربری تعداد زیادی حساب را دنبال میکند، از ترکیب مدلهای Pull و Push برای کاهش تاخیر استفاده کنید.
نقاط داغ خواندن (Read Hotspots)
مدیریت نقاط داغ خواندن، مانند حسابهای محبوبی که تعداد زیادی دنبالکننده دارند، یکی از چالشهای سیستم است.
برای مدیریت این وضعیت، میتوان توییتهای این حسابها را در Redis کش کرد و از الگوی Cache-Aside برای مدیریت کش و حفظ سازگاری دادهها استفاده کرد.
افزودن نواحی داغ (Hot Zones) در سرورهای Redis و استفاده از کشهای محلی (Local Cache) نیز میتواند بار را میان منابع مختلف توزیع کند و از ارسال درخواستهای بیشازحد به یک سرور جلوگیری کند.
راهکارهای پیشنهادی عبارتاند از:
- کشکردن دادههای پرتکرار در Redis با استفاده از الگوی Cache-Aside.
- استفاده از کش محلی برای مدیریت ترافیک بالا.
بهبودهای آینده (Future Improvements)
بهبودهای آینده میتوانند شامل پیادهسازی راهبرد Active-Active چندمنطقهای (Multi-Region Active-Active) برای بازیابی پس از بحران (Disaster Recovery) و افزایش دسترسپذیری باشند.
استقرار خوشههای سرویس و پایگاه داده در مناطق جغرافیایی مختلف، همراه با Failover خودکار و توزیع بار، از ایجاد نقطه شکست منفرد (Single Point of Failure) جلوگیری میکند و تداوم و قابلیت اطمینان سرویس را حفظ میکند.
بهبودهای پیشنهادی عبارتاند از:
- پیادهسازی راهبرد Active-Active چندمنطقهای برای بازیابی پس از بحران و افزایش دسترسپذیری.
- ادامه بهینهسازی کش، توزیع بار و راهکارهای ذخیرهسازی دادهها برای پشتیبانی از رشد آینده.
۹. ده منبع برتر برای آمادگی در مصاحبه طراحی سیستم
در ادامه، فهرستی از بهترین کتابها، دورههای آنلاین و وبسایتهای تمرینی برای آمادگی بهتر در مصاحبه طراحی سیستم ارائه شده است. بسیاری از این منابع به سوالاتی که پیشتر معرفی شدهاند نیز پاسخ میدهند.
۱. ByteByteGo
کتاب و دوره آموزشی الکس ژو (Alex Xu) برای آمادگی مصاحبه طراحی سیستم. این مجموعه محتوای دو جلد نخست کتاب System Design Interview را پوشش میدهد و قرار است با انتشار جلد سوم که در زمان نگارش مقاله در آینده عرضه میشود، بهروزرسانی شود.
۲. Codemia.io
پلتفرمی مناسب برای تمرین مسائل طراحی سیستم در مصاحبهها. این وبسایت بیش از ۱۲۰ مسئله طراحی سیستم دارد که بسیاری از آنها رایگان هستند. همچنین ساختار مشخصی برای حل مسائل ارائه میدهد.
۳. دوره Grokking System Design از DesignGuru
یک پلتفرم آموزشی تعاملی با تمرینهای عملی و سناریوهای واقعی که به تقویت مهارتهای طراحی سیستم کمک میکند.
۴. Exponent
وبسایتی تخصصی برای آمادگی مصاحبه، بهویژه در شرکتهای بزرگ فناوری مانند آمازون و گوگل. این وبسایت دوره طراحی سیستم و منابع آموزشی دیگری برای موفقیت در مصاحبههای شرکتهای بزرگ فناوری ارائه میدهد.
۵. کتاب System Design Interview نوشته الکس ژو
این کتاب مفاهیم طراحی سیستم، راهبردهای طراحی و نکات آمادگی برای مصاحبه را بهصورت عمیق بررسی میکند.
۶. کتاب Designing Data-Intensive Applications نوشته مارتین کلپمن
کتابی جامع درباره اصول و روشهای طراحی سیستمهای مقیاسپذیر و قابلاعتماد که برای درک معماری سیستمهای دادهمحور بسیار مفید است.
۷. Bugfree.ai
پلتفرمی محبوب برای آمادگی مصاحبههای فنی. این وبسایت که ساختاری شبیه LeetCode دارد، مجموعهای از سوالات تمرینی را در اختیار کاربران قرار میدهد.
۸. مخزن System Design Primer در گیتهاب
مجموعهای از منابع آموزشی شامل مقالهها، کتابها و ویدئوها که به یادگیری و آمادگی برای مصاحبه طراحی سیستم کمک میکنند.
۹. دوره طراحی سیستم Educative
یک پلتفرم آموزشی تعاملی که با تمرینهای عملی و سناریوهای واقعی، مهارتهای طراحی سیستم را تقویت میکند.
۱۰. وبلاگ High Scalability
وبلاگ High Scalability مقالهها و مطالعات موردی درباره معماری وبسایتهای پرترافیک و سیستمهای مقیاسپذیر منتشر میکند.
۱1. کانالهای یوتیوب
همچنین میتوانید کانالهای یوتیوبی مانند Gaurav Sen و Tech Dummies را برای یادگیری مفاهیم طراحی سیستم و آمادگی برای مصاحبه بررسی کنید.
۱۰. نتیجهگیری
به یاد داشته باشید که دانش نظری را با کاربرد عملی ترکیب کنید. کار روی پروژههای واقعی و شرکت در مصاحبههای آزمایشی به شما کمک میکند مفاهیم را بهتر درک کنید و برای مصاحبههای طراحی سیستم اعتمادبهنفس بیشتری داشته باشید.
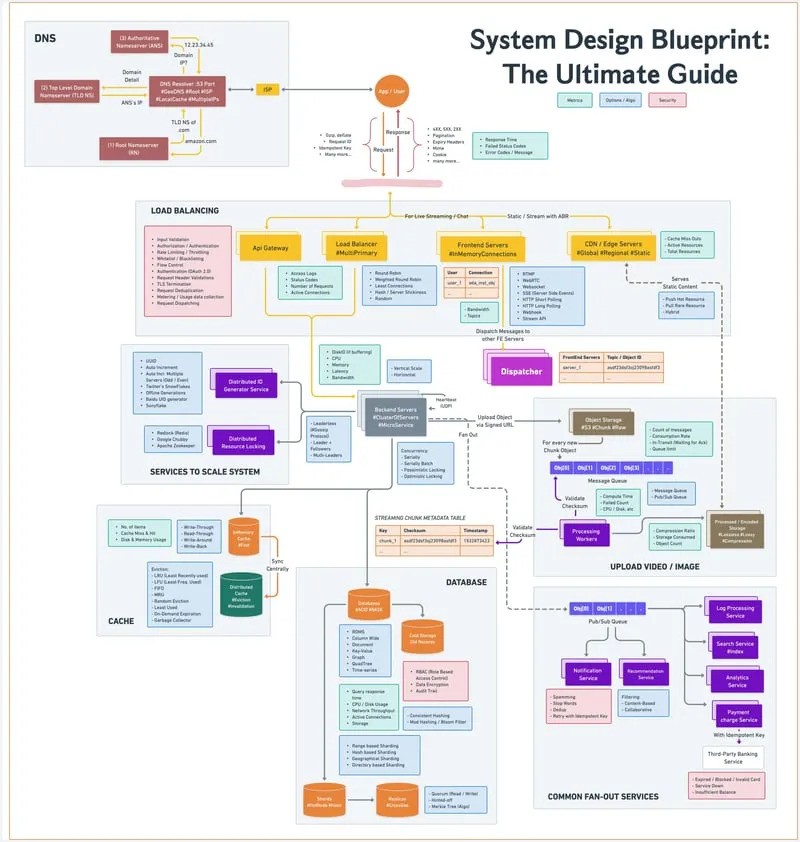
این مقاله به بررسی نحوه طراحی یک اپلیکیشن پیامرسان مانند توییتر یا X.com در مصاحبه طراحی سیستم پرداخت. با پیروی از این ساختار، میتوانید سیستمی قدرتمند و مقیاسپذیر مشابه توییتر طراحی کنید.
این راهنما به شما کمک میکند طراحی خود را در مصاحبه طراحی سیستم بهشکلی موثر ارائه دهید.
دیدگاهها
ثبت دیدگاه