مثالی ساده از کاربرد این رویکرد برای تولید محتوای پویا در صفحات وب و بهبود تجربه کاربری
مقدمه
آموزش هوش مصنوعی (AI) و یادگیری ماشین (Machine Learning) معمولا با معرفی مفاهیم پایه علم داده آغاز میشود. یادگیری نظارتشده (Supervised Learning) و یادگیری بدون نظارت (Unsupervised Learning) دو مورد از مهمترین این مفاهیم هستند.
یادگیری نظارتشده روشی است که در آن مدل با استفاده از دادههای برچسبگذاریشده آموزش میبیند. این برچسبها به الگوریتم کمک میکنند تا دادهها را در دستههای مشخص و معنادار قرار دهد. در مقابل، یادگیری بدون نظارت از الگوریتمهای یادگیری ماشین برای خوشهبندی دادههای بدون برچسب استفاده میکند تا الگوها و روابط پنهان میان آنها را شناسایی کند.
هر دو روش به نوعی دادهها را گروهبندی میکنند، اما در یادگیری ماشین تفاوت مهمی میان طبقهبندی (Classification) و خوشهبندی (Clustering) وجود دارد. شناخت این تفاوت به ما کمک میکند برای هر مسئله، روش مناسبتری انتخاب کنیم.
یادگیری نظارتشده: طبقهبندی (Classification)
در یادگیری نظارتشده، مدل طبقهبندی از دادههای برچسبگذاریشده یاد میگیرد و سپس برای نمونههای جدید، کلاس یا دسته مناسب را پیشبینی میکند.
در این روش، مدل با استفاده از دادههای ورودی ((x))، تابعی را یاد میگیرد که ورودیها را به خروجیهای مشخص ((y)) نگاشت میکند. این خروجیها معمولا مقادیر گسستهای هستند که هرکدام نشاندهنده یک کلاس مشخصاند.
مدلهای طبقهبندی میتوانند علاوه بر تعیین کلاس، احتمال تعلق هر نمونه به کلاسهای مختلف را نیز محاسبه کنند.
برای مثال، فرض کنید میخواهیم ایمیلهای هرزنامه را شناسایی کنیم. یک مدل ممکن است برای ایمیلی که کلمه «promotion» در آن وجود دارد، احتمال هرزنامه بودن را ۰٫۳ و احتمال عادی بودن آن را ۰٫۷ تخمین بزند. در این شرایط، اگر معیار تصمیمگیری انتخاب کلاسی با احتمال بیشتر باشد، ایمیل بهعنوان یک پیام عادی طبقهبندی میشود.
اگر هدف، اختصاص دادن یک برچسب مشخص به هر نمونه باشد، با یک مسئله طبقهبندی سروکار داریم.
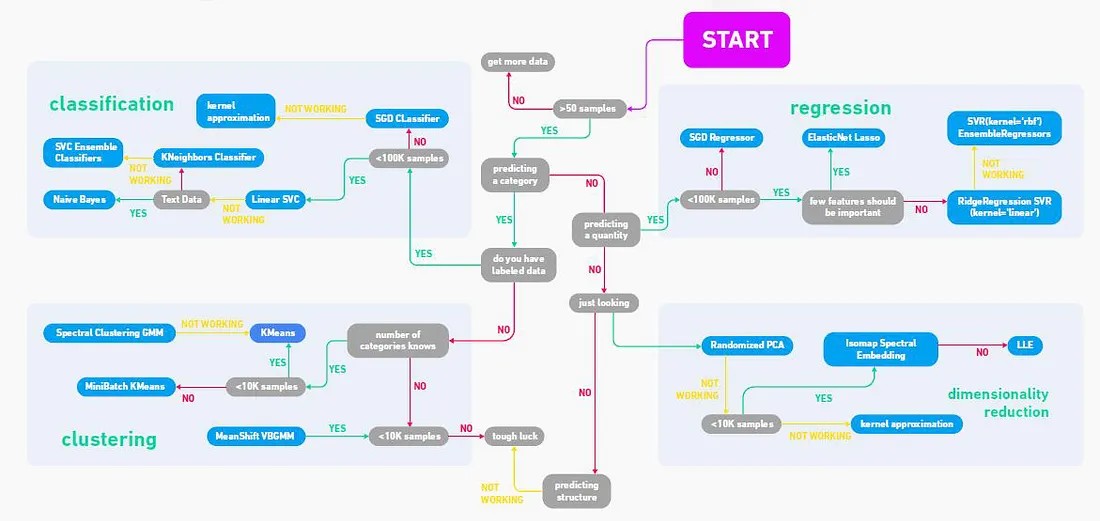
الگوریتمهای رایج طبقهبندی
از الگوریتمهای پرکاربرد این حوزه میتوان به موارد زیر اشاره کرد:
- رگرسیون لجستیک (Logistic Regression): برای پیشبینی احتمال تعلق دادهها به کلاسهای مختلف استفاده میشود.
- بیز ساده (Naive Bayes): بر پایه قضیه بیز عمل میکند و در مسائل مختلف، از جمله دستهبندی متن، کاربرد دارد.
- نزدیکترین همسایهها (K-Nearest Neighbors): کلاس یک نمونه را بر اساس کلاس نمونههای مشابه و نزدیک به آن تعیین میکند.
هر الگوریتم مزایا، محدودیتها و فرضیات خاص خود را دارد. بنابراین، انتخاب الگوریتم مناسب به نوع دادهها، حجم مجموعهداده، منابع محاسباتی و نیازهای پروژه بستگی دارد.
برای مثال، برخی الگوریتمها در شرایطی که ویژگیهای دادهها استقلال بیشتری از یکدیگر دارند، عملکرد مناسبی نشان میدهند. بعضی دیگر برای مجموعهدادههای بزرگ مناسبترند و برخی نیز پیشبینیها را با سرعت بیشتری انجام میدهند، قابلیتی که برای سامانههای بلادرنگ اهمیت زیادی دارد.
برای انتخاب بهترین الگوریتم، معمولا چند گزینه مناسب را آزمایش و عملکرد آنها را مقایسه میکنیم. یکی از معیارهای رایج در این مقایسه، دقت (Accuracy) است که از تقسیم تعداد پیشبینیهای صحیح بر تعداد کل نمونهها به دست میآید.
البته دقت بهتنهایی همیشه معیار کافی نیست. برای مجموعهدادههای نامتوازن، معیارهایی مانند Precision، Recall و F1-score نیز میتوانند در ارزیابی عملکرد مدل اهمیت داشته باشند.
یادگیری بدون نظارت: خوشهبندی (Clustering)
در خوشهبندی، دادهها از قبل برچسب مشخصی ندارند. هدف این است که الگوریتم بهصورت خودکار، الگوهای مشترک و گروهبندیهای طبیعی موجود در دادهها را شناسایی کند.
این روش زمانی کاربرد دارد که اطلاعات زیادی در اختیار داریم، اما هنوز نمیدانیم کدام ویژگیها برای تقسیم دادهها به گروههای معنادار مناسب هستند.
برای مثال، ممکن است بخواهیم رفتار بازدیدکنندگان یک وبسایت را تحلیل کنیم، اما از قبل ندانیم کاربران به چه گروههایی تقسیم میشوند یا چه ویژگیهایی آنها را از یکدیگر متمایز میکند. در چنین شرایطی، خوشهبندی میتواند به شناسایی الگوهای رفتاری کمک کند.
الگوریتمهای رایج خوشهبندی
از الگوریتمهای پرکاربرد این حوزه میتوان به موارد زیر اشاره کرد:
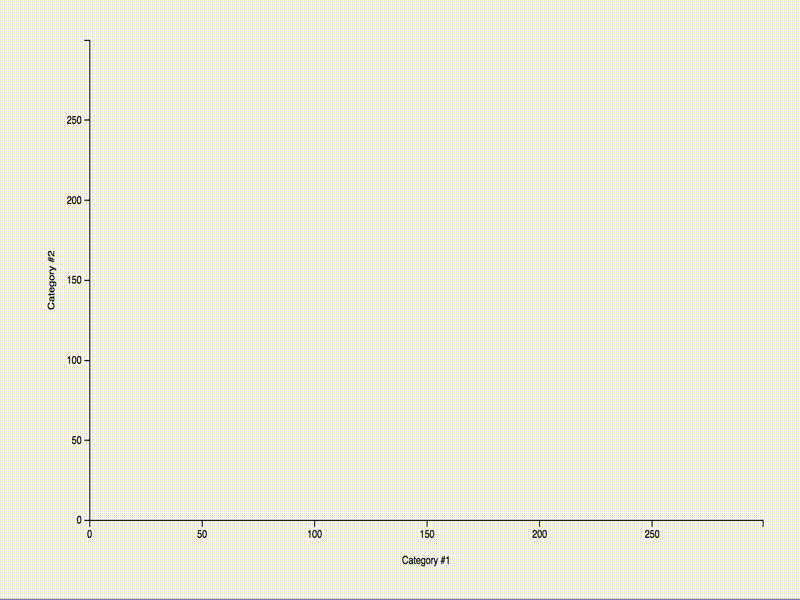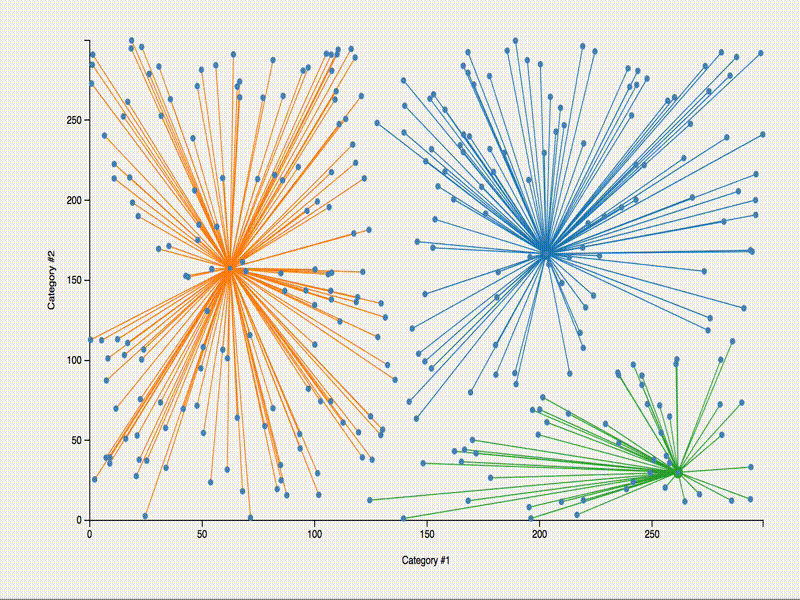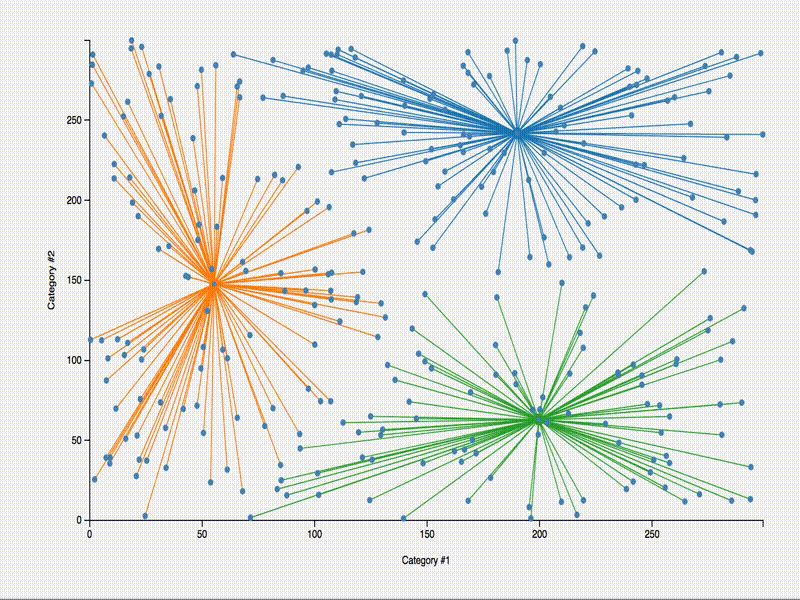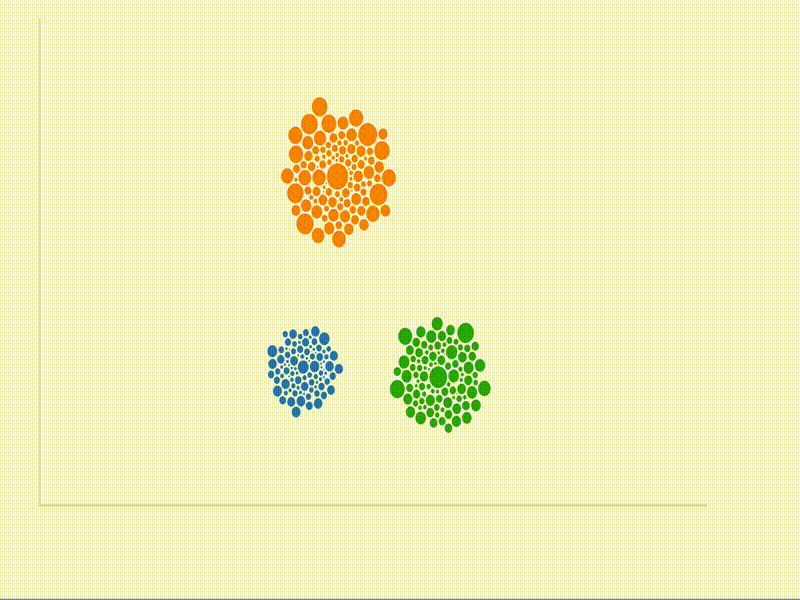
- K-means: دادهها را بر اساس شباهت و فاصله از مراکز خوشهها گروهبندی میکند.
- Mean-Shift: با شناسایی نواحی پرتراکم در فضای دادهها، خوشهها را تعیین میکند.
- DBSCAN: خوشهها را بر اساس تراکم دادهها شناسایی میکند و میتواند برخی دادههای پرت را نیز از خوشههای اصلی جدا کند.
در میان این روشها، الگوریتم K-means به دلیل سادگی و قابلدرک بودن، یکی از گزینههای رایج برای شروع کار است.
الگوریتم K-means چگونه کار میکند؟
در الگوریتم K-means، ابتدا تعداد خوشههای موردنظر مشخص میشود. سپس الگوریتم مراکز اولیه خوشهها را تعیین میکند و مراحل زیر را بهصورت تکراری انجام میدهد:
۱. فاصله هر نمونه از مراکز خوشهها محاسبه میشود.
۲. هر نمونه به خوشهای اختصاص داده میشود که نزدیکترین مرکز را دارد.
۳. مرکز هر خوشه با محاسبه میانگین مقادیر نمونههای عضو آن دوباره تعیین میشود.
۴. مراحل بالا تکرار میشوند تا مراکز خوشهها دیگر تغییر قابلتوجهی نداشته باشند یا الگوریتم به شرط توقف تعیینشده برسد.
با وجود سادگی، K-means محدودیتهایی دارد. یکی از مهمترین چالشها، تعیین تعداد مناسب خوشهها پیش از اجرای الگوریتم است.
برای تخمین تعداد مناسب خوشهها میتوان از روشهایی مانند روش آرنج (Elbow Method) و تحلیل سیلوئت (Silhouette Analysis) استفاده کرد.
محدودیت دیگر این است که خوشهبندی لزوما گروههایی با معنای تجاری یا مفهومی مشخص تولید نمیکند. در برخی موارد، الگوریتم صرفا بر اساس فاصله و موقعیت نمونهها نسبت به یکدیگر تصمیم میگیرد. به همین دلیل، خوشههای حاصل باید با توجه به مسئله موردنظر تفسیر شوند.
همچنین، عملکرد الگوریتمها در مواجهه با دادههای پرت متفاوت است. برای مثال، K-means نسبت به دادههای پرت حساس است، زیرا این دادهها میتوانند میانگین و در نتیجه مرکز خوشهها را تحت تاثیر قرار دهند.
با این حال، خوشهبندی میتواند نقطه شروع مناسبی برای تحلیل دادههای بدون برچسب باشد. ابتدا با استفاده از آن ساختار و روابط احتمالی میان دادهها را بررسی میکنیم و سپس بر اساس نتایج بهدستآمده، روش مناسبتری برای ادامه تحلیل انتخاب میکنیم.
ترکیب طبقهبندی و خوشهبندی
در مسائل پیچیده که با دادههای متنوع و بدون ساختار مشخص سروکار داریم، ترکیب یادگیری نظارتشده و یادگیری بدون نظارت میتواند راهکار موثری باشد.
البته پیش از ترکیب این روشها، باید بررسی کنیم که هر مرحله چه نقشی در حل مسئله دارد و آیا نتیجه نهایی با هدف تحلیل سازگار است یا خیر.
برای درک بهتر این موضوع، فرض کنید میخواهیم با استفاده از یادگیری ماشین، مسیر حرکت کاربران را در صفحات یک یا چند وبسایت تحلیل کنیم.
جمعآوری اطلاعات مربوط به رفتار کاربران
در گام نخست، باید مشخص کنیم کاربران از چه صفحاتی بازدید میکنند و این بازدیدها با چه ترتیبی انجام میشوند.
جدول زیر نمونهای ساده از اطلاعات ثبتشده درباره بازدید صفحات یک وبسایت را نشان میدهد.
| زمان بازدید | مسیر صفحه (Page Path) |
|---|---|
| ۱۱ مه ۲۰۲۱، ساعت ۰۸:۰۰ | / |
| ۱۱ مه ۲۰۲۱، ساعت ۰۸:۱۶ | /our-new-brand-story |
| ۱۱ مه ۲۰۲۱، ساعت ۰۸:۲۳ | /about-ximnet-malaysia |
| ۱۱ مه ۲۰۲۱، ساعت ۰۸:۴۰ | /services/xtopiaio-dev-platform |
| ۱۱ مه ۲۰۲۱، ساعت ۰۸:۵۰ | /projects-case-studies |
| ۱۱ مه ۲۰۲۱، ساعت ۰۹:۰۵ | /get-in-touch |
هدف این است که کاربران را بر اساس رفتارشان در وبسایت به گروههای معنادار تقسیم کنیم. با این حال، در ابتدای کار نمیدانیم کدام ویژگیها بیشترین نقش را در تعیین این گروهها دارند.
به همین دلیل، بهتر است اطلاعات مرتبط بیشتری جمعآوری کنیم تا بتوانیم ابعاد مختلف رفتار کاربران را بررسی کنیم.
برای مثال، با استفاده از ابزارهای تحلیل وب میتوان دادههایی مانند موارد زیر را ثبت کرد:
- تاریخ و زمان بازدید
- مسیر صفحات مشاهدهشده
- شناسه منحصربهفرد کاربر برای تفکیک کاربران مختلف
- مدتزمان نشست کاربر
- نوع دستگاه مورد استفاده
- موقعیت جغرافیایی کاربر، در صورت دسترسی مجاز به این اطلاعات
این دادهها به ما کمک میکنند رفتار کاربران را دقیقتر بررسی کنیم و ویژگیهایی را که برای گروهبندی آنها اهمیت دارند، شناسایی کنیم.
ساخت توالی مسیر صفحات
ستون مسیر صفحه بهتنهایی اطلاعات محدودی ارائه میدهد. برای مثال، بازدید یک کاربر از صفحه اصلی مشخص نمیکند که او کاربر جدید است یا قبلا نیز از وبسایت بازدید کرده است.
برای رفع این محدودیت، میتوانیم بازدیدهای مربوط به هر نشست را در یک ردیف تجمیع کنیم و ستون جدیدی با عنوان «توالی مسیر صفحات» (Page Path Sequence) بسازیم.
در اینجا، نشست مجموعهای از تعاملات کاربر است که بر اساس قواعد تعریفشده برای تحلیل، در یک بازه زمانی مشخص قرار میگیرند. برای مثال، میتوان نشستهایی را که وقفه غیرفعال بودن کاربر در آنها کمتر از ۳۰ دقیقه است، یک نشست واحد در نظر گرفت.
در نتیجه، بهجای اینکه هر بازدید از یک صفحه را بهصورت مستقل بررسی کنیم، کل مسیر پیمودهشده توسط کاربر در طول یک نشست را تحلیل خواهیم کرد.
برای نمونه، ممکن است توالی بازدید یک کاربر به شکل زیر باشد:
Home
→ Our New Brand Story
→ About Us
→ Services
→ Projects
→ Contact Us
این توالی اطلاعات بیشتری درباره رفتار کاربر در اختیار ما قرار میدهد و میتواند به شناسایی الگوهای مشترک میان کاربران کمک کند.
چالش تفاوت مسیر صفحات در وبسایتهای مختلف
برای ساخت یک مدل عمومی که بتواند رفتار کاربران را در وبسایتهای مختلف تحلیل کند، به دادههای متنوعتری نیاز داریم.
هر وبسایت ممکن است برای صفحات مشابه از مسیرهای متفاوتی استفاده کند. برای مثال، صفحه تماس با ما در یک وبسایت ممکن است مسیر /contact-us داشته باشد، درحالیکه وبسایت دیگری از مسیر /enquire-more استفاده کند.
اگر مسیر صفحات را بدون پردازش وارد مدل کنیم، تفاوتهای ظاهری میان این مسیرها ممکن است باعث شود صفحات مشابه از نظر معنایی، متفاوت تشخیص داده شوند.
با افزایش تعداد ویژگیها و تنوع مقادیر آنها، مسئله دیگری نیز ممکن است ایجاد شود که به آن نفرین ابعاد (Curse of Dimensionality) گفته میشود.
در چنین شرایطی، تشخیص شباهت میان نمونههای داده دشوارتر میشود و الگوریتم ممکن است نتواند گروههای معناداری ایجاد کند. در نتیجه، تعداد خوشهها افزایش مییابد و مدل بهجای شناسایی الگوهای مشترک، نمونههای مشابه را نیز در گروههای جداگانه قرار میدهد.
طبقهبندی مسیر صفحات با استفاده از کلمات کلیدی
یکی از راهکارهای پیشنهادی برای کاهش این مشکل، طبقهبندی مسیر صفحات پیش از انجام خوشهبندی رفتار کاربران است.
در این روش، ابتدا یک مجموعه از کلمات کلیدی تعریف میکنیم و هر مجموعه را به نوع مشخصی از صفحه اختصاص میدهیم. سپس مسیر صفحات را بررسی میکنیم تا بر اساس کلمات موجود در آنها، دسته مناسب را تعیین کنیم.
برای پیادهسازی این روش در پایتون، میتوان از ابزارهایی مانند KeywordProcessor در کتابخانه flashtext استفاده کرد.
منطق اصلی این است که کلمات کلیدی موجود در مسیر هر صفحه با فهرستهای تعریفشده مقایسه شوند. سپس بر اساس میزان تطبیق، دسته مناسب انتخاب شود.
برای محاسبه میزان تطبیق میتوان از فرمول زیر استفاده کرد:
[
\text{میزان تطبیق} =
\frac{\text{تعداد کلمات منطبق با یک دسته}}
{\text{تعداد کل کلمات منطبقشده}}
]برای مثال، فهرست کلمات کلیدی مربوط به انواع صفحات میتواند به شکل زیر باشد:
keywords_AboutUs = [
    "about-us", "about", "organisation", "staff",
    "team", "who", "join", "careers"
]

keywords_ContactUs = [
    "contact", "reach-us", "contact-us",
    "email", "phone", "know", "more"
]

keywords_Event_Happening_News = [
    "whats on", "news", "berita", "cerita", "updates",
    "terkini", "events", "press-release", "apply", "media",
    "january", "february", "march", "april", "may",
    "june", "july", "august", "september", "october",
    "november", "december", "newsletter"
]

keywords_Miscellaneous = [
    "terms", "covid", "faq", "feedback", "help",
    "legal", "privacy", "whistleblowing", "safety",
    "sustainability", "policy", "subscribe", "improve",
    "social", "unsubscribe"
]
در این مثال، چند دسته اصلی برای صفحات تعریف شدهاند:
- صفحات درباره ما (About Us): شامل کلماتی مانند
about،teamوcareers - صفحات تماس با ما (Contact Us): شامل کلماتی مانند
contact،emailوphone - صفحات اخبار و رویدادها (News & Events): شامل کلماتی مانند
news،eventsو نام ماههای سال - صفحات متفرقه (Miscellaneous): شامل کلماتی مانند
terms،faqوprivacy
برای صفحه اصلی نیز میتوان یک قاعده مشخص تعریف کرد: هر مسیر نسبی برابر با / بهعنوان صفحه اصلی (HomePage) شناخته شود.
در نسخه ساده این روش، مسیرهایی که با هیچیک از فهرستهای تعریفشده تطبیق نداشته باشند، در دسته صفحات کسبوکار یا محصول (Business/Product) قرار میگیرند.
البته این دستهبندی یک نمونه اولیه است و برای استفاده در محیط واقعی باید مواردی مانند همپوشانی کلمات کلیدی، اولویت دستهها، مسیرهای چندزبانه و صفحات دارای نامگذاری متفاوت نیز در نظر گرفته شوند.
با اختصاص دسته مناسب به هر صفحه، دادهها ساختار منظمتری پیدا میکنند. این کار باعث میشود صفحات مشابه در وبسایتهای مختلف، حتی اگر مسیرهای متفاوتی داشته باشند، در یک دسته مشترک قرار بگیرند.
برای مثال، توالی بازدید کاربر میتواند به شکل زیر تبدیل شود:
HomePage
→ AboutUs
→ AboutUs
→ Business/Product
→ Business/Product
→ ContactUs
در این حالت، بهجای کار با رشتههای متنی متفاوت، توالی استانداردشدهای از انواع صفحات در اختیار داریم.
اجرای خوشهبندی روی رفتار کاربران
اکنون میتوان ستون توالی مسیر صفحات را با سایر ویژگیهای مهم ترکیب کرد، از جمله:
- مدتزمان نشست (
session_duration) - نوع دستگاه (
device_category) - موقعیت جغرافیایی (
geolocation) - توالی صفحات مشاهدهشده (
page_path_sequence)
سپس میتوان از الگوریتمهایی مانند K-means برای شناسایی گروههای رفتاری کاربران استفاده کرد.
با این حال، باید به یک نکته مهم توجه داشت: K-means معمولا با دادههای عددی کار میکند. از آنجا که مجموعهداده ما ترکیبی از ویژگیهای عددی و دستهای است، لازم است پیش از اجرای الگوریتم، دادهها به شکل مناسبی آمادهسازی شوند.
برای مقایسه نتایج میتوان از روشهای دیگری نیز استفاده کرد، برای مثال، فاصله گوئر (Gower Distance) برای محاسبه شباهت میان دادههای ترکیبی و الگوریتم K-Medoids برای خوشهبندی نمونهها بر اساس نمایندههای واقعی مجموعهداده.
در نهایت، باید خوشههای ایجادشده را تحلیل کنیم تا مشخص شود هر گروه چه ویژگیها و الگوهای رفتاری مشترکی دارد. صرفا ایجاد چند خوشه به معنای دستیابی به بینش ارزشمند نیست، ارزش اصلی زمانی به دست میآید که بتوانیم نتایج را تفسیر کنیم و از آنها برای تصمیمگیری استفاده کنیم.
جمعبندی
پیش از اجرای مرحله نهایی خوشهبندی کاربران، بهتر است زمان کافی برای پاکسازی، آمادهسازی و استانداردسازی دادهها اختصاص دهیم. همچنین، آزمایش الگوریتمهای مختلف به ما کمک میکند روشی را انتخاب کنیم که با نوع دادهها و هدف تحلیل سازگاری بیشتری دارد.
در این مقاله، نمونهای ساده از ترکیب دو رویکرد یادگیری ماشین را بررسی کردیم: استفاده از طبقهبندی برای استانداردسازی انواع صفحات وب و استفاده از خوشهبندی برای شناسایی الگوهای رفتاری کاربران.
خوشهبندی رفتار کاربران میتواند پایهای برای تولید محتوای پویای وبسایت و بهبود تجربه کاربری باشد. با شناسایی گروههای مختلف کاربران، میتوان محتوای صفحات را متناسب با نیازها و رفتار آنها نمایش داد، برای مثال، تجربه کاربری را برای بازدیدکنندگان جدید، کاربران بازگشتی یا سرمایهگذاران بالقوه شخصیسازی کرد.
البته برای رسیدن به این هدف، باید اطمینان حاصل کنیم که دادههای جمعآوریشده معتبر هستند، گروههای شناساییشده معنای مشخصی دارند و تغییرات محتوایی واقعا به بهبود تجربه کاربری منجر میشوند.
دیدگاهها
ثبت دیدگاه