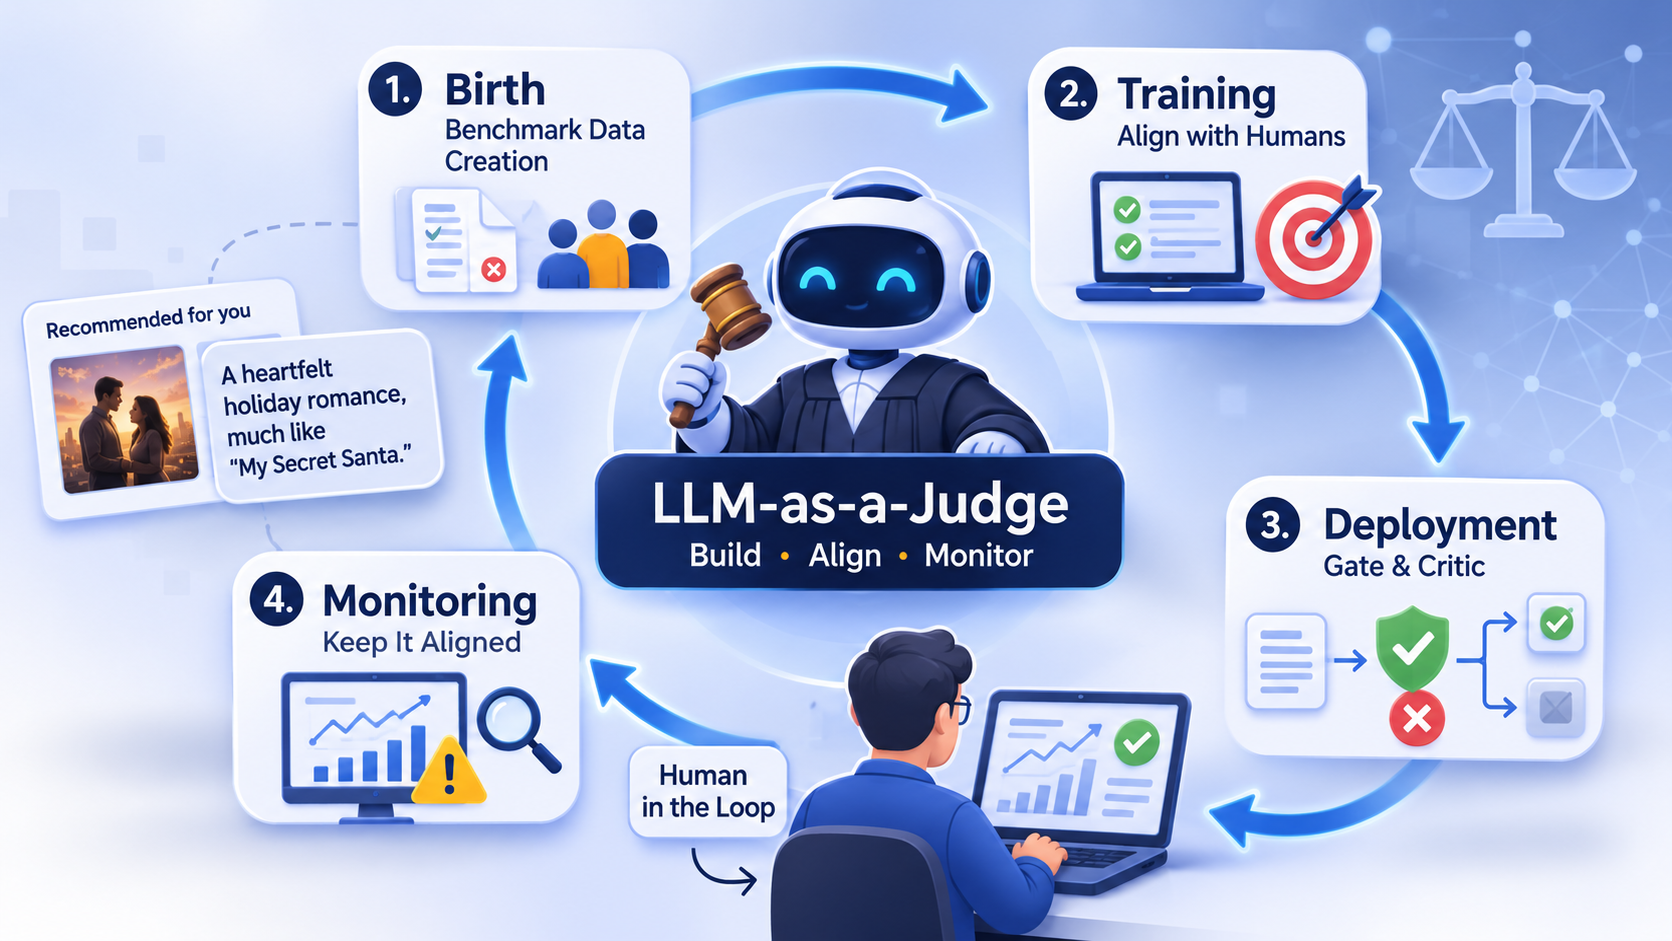
مقدمه (Introduction)
هر تیمی که در مقیاس گسترده با استفاده از یک مدل زبانی بزرگ (LLM) متن تولید میکند، دیر یا زود با یک مشکل مشترک روبهرو میشود: نمیتوان تمام خروجیها را بهصورت دستی ارزیابی کرد. شما نمیدانید کدام خروجیها عالی هستند، کدام کیفیت متوسطی دارند و کدامیک مضر یا نامناسباند، چون اساساً امکان خواندن و بررسی تمام آنها وجود ندارد.
راهکار استاندارد برای حل این مشکل، استفاده از رویکرد LLM-as-a-Judge است. در این روش، یک مدل زبانی دوم وظیفه دارد خروجی مدل اول را ارزیابی و امتیازدهی کند و بهعنوان جایگزینی برای ارزیابهای انسانی عمل کند.
این روش سریع، کمهزینه و بهسادگی قابل پیادهسازی است. بااینحال، یک سوال جدید و بسیار مهم ایجاد میکند:
چه کسی ارزیاب را ارزیابی میکند؟
علاوه بر این، اگر مدل داور بهمرور دچار انحراف (Drift) شود و بدون اینکه متوجه شویم، کیفیت ارزیابیهایش افت کند و شروع به تایید خروجیهای نامناسب کند، هیچکدام از مراحل بعدی سیستم قادر به شناسایی این مشکل نخواهند بود.
این مقاله درباره روشی است که برای حل این مسئله به کار گرفتهایم، یعنی ساخت، همراستاسازی و پایش مستمر مدلهای داور (LLM Judges) تا بتوانیم در طول زمان به نتایج آنها اعتماد کنیم.
اصل اساسی ما ساده است:
یک مدل داور مبتنی بر LLM هرگز نباید بهتنهایی فعالیت کند. این مدل باید همواره به قضاوت انسانی متکی باشد.
ما در تمام مراحل چرخه عمر این سیستم، انسان را در فرایند تصمیمگیری دخیل نگه میداریم (Human-in-the-Loop یا HITL).
انسانها مشخص میکنند که چه چیزی «خوب» محسوب میشود، مجموعهدادههای معیار (Benchmark) برچسبگذاریشده را برای آموزش و اعتبارسنجی مدل داور ایجاد میکنند، رفتار آن را هنگام فعالیت در سیستم زیر نظر میگیرند و پیش از انتشار هرگونه بهروزرسانی، آن را بررسی و تایید میکنند.
باور ما این است:
یک مدل داور قابلاعتماد، یک محصول ثابت و بدون تغییر نیست، بلکه چرخه عمری دارد که باید مدیریت شود.
این مدل باید بر اساس برچسبهای معتبر انسانی ساخته شود، با ترجیحات و شیوه استدلال انسانها همراستا باشد، تحت سیاستهایی که انسان تعیین کرده فعالیت کند و همزمان با تغییر دادهها و الگوهای استفاده، بهروزرسانی و نگهداری شود.
در هر یک از این مراحل، افراد مشخصی مسئولیت دارند.
در بخشهای بعدی، این چهار مرحله، تصمیمهای کلیدی طراحی در هر مرحله و درسهایی را که میتوانیم با تیمهایی که قصد ساخت مدل داور اختصاصی خود را دارند به اشتراک بگذاریم، بررسی میکنیم.
برای توضیح بهتر، از یک مثال واقعی و مشخص استفاده خواهیم کرد: توضیحات مربوط به پیشنهاد محتوا (Recommendation Explanations).
توضیح پیشنهاد (recommendation explanation)، یک پیام کوتاه به زبان طبیعی (natural-language) است که همراه با یک محتوای پیشنهادی نمایش داده میشود. این پیام بر نحوه درک کاربران از سیستم پیشنهاددهنده و میزان اعتماد آنها به سیستم تاثیر میگذارد.
در پروژه ما، این توضیحات شواهدی قابلفهم برای انسان هستند که نشان میدهند چرا یک عنوان محتوایی خاص، بر اساس چیزهایی که کاربر قبلاً تماشا کرده، به او پیشنهاد شده است.
این توضیحات در صفحه جزئیات محتوا نمایش داده میشوند، همان صفحهای که کاربر با انتخاب یک عنوان از صفحه اصلی وارد آن میشود.
تمرکز ما بر توضیحات مبتنی بر شباهت (Similarity-based Explanations) است. این توضیحات، محتوای پیشنهادی را به یک عنوان مرجع که کاربر قبلاً با آن تعامل داشته، مرتبط میکنند. این ارتباط بر اساس ویژگیهای مشترکی مانند ژانر و حالوهوای محتوا (Tone) شکل میگیرد.
برای مثال:
یک داستان عاشقانه کمدی و احساسی با حالوهوای تعطیلات، درباره عشق و شروع دوباره، درست شبیه فیلم «My Secret Santa».
کیفیت این توضیحات اهمیت زیادی دارد، زیرا توضیحی که گمراهکننده باشد یا پشتوانه معتبری نداشته باشد، دقیقاً همان اعتمادی را از بین میبرد که قرار بوده این توضیح ایجاد کند.
تمام مطالبی که در ادامه میآیند، حاصل مجموعهای از آزمایشهای آنلاین کنترلشده و قابل مشاهده برای کاربران هستند که روی قابلیت توضیح پیشنهادها اجرا کردیم. یکی از این آزمایشها به مدت یک ماه در اپلیکیشن موبایل نتفلیکس انجام شد.
در این آزمایشها، از یک مدل زبانی بزرگ برای تولید توضیحات استفاده کردیم، بهطوریکه هر هفته صدها هزار توضیح تولید میشد و کاتالوگ محتوا نیز دائماً تغییر میکرد.
بررسی دستی چنین حجمی از خروجیها امکانپذیر نبود. بنابراین، یک مدل LLM دوم را برای ارزیابی آنها مستقر کردیم.
اینکه دقیقاً چه چیزی یک توضیح خوب محسوب میشود، به وظیفه و کاربرد ما بستگی دارد. بااینحال، روشی که برای ساخت، همراستاسازی و پایش مدل داور به کار گرفتهایم، میتواند در وظایف مختلف نیز استفاده شود و قابلیت تعمیم دارد.
نگاهی کلی به چرخه عمر (The Lifecycle at a Glance)
شکل ۱ چهار مرحله چرخه عمر مدل داور مبتنی بر LLM و جریان دادهای را که این مراحل را به یکدیگر متصل میکند، نشان میدهد.
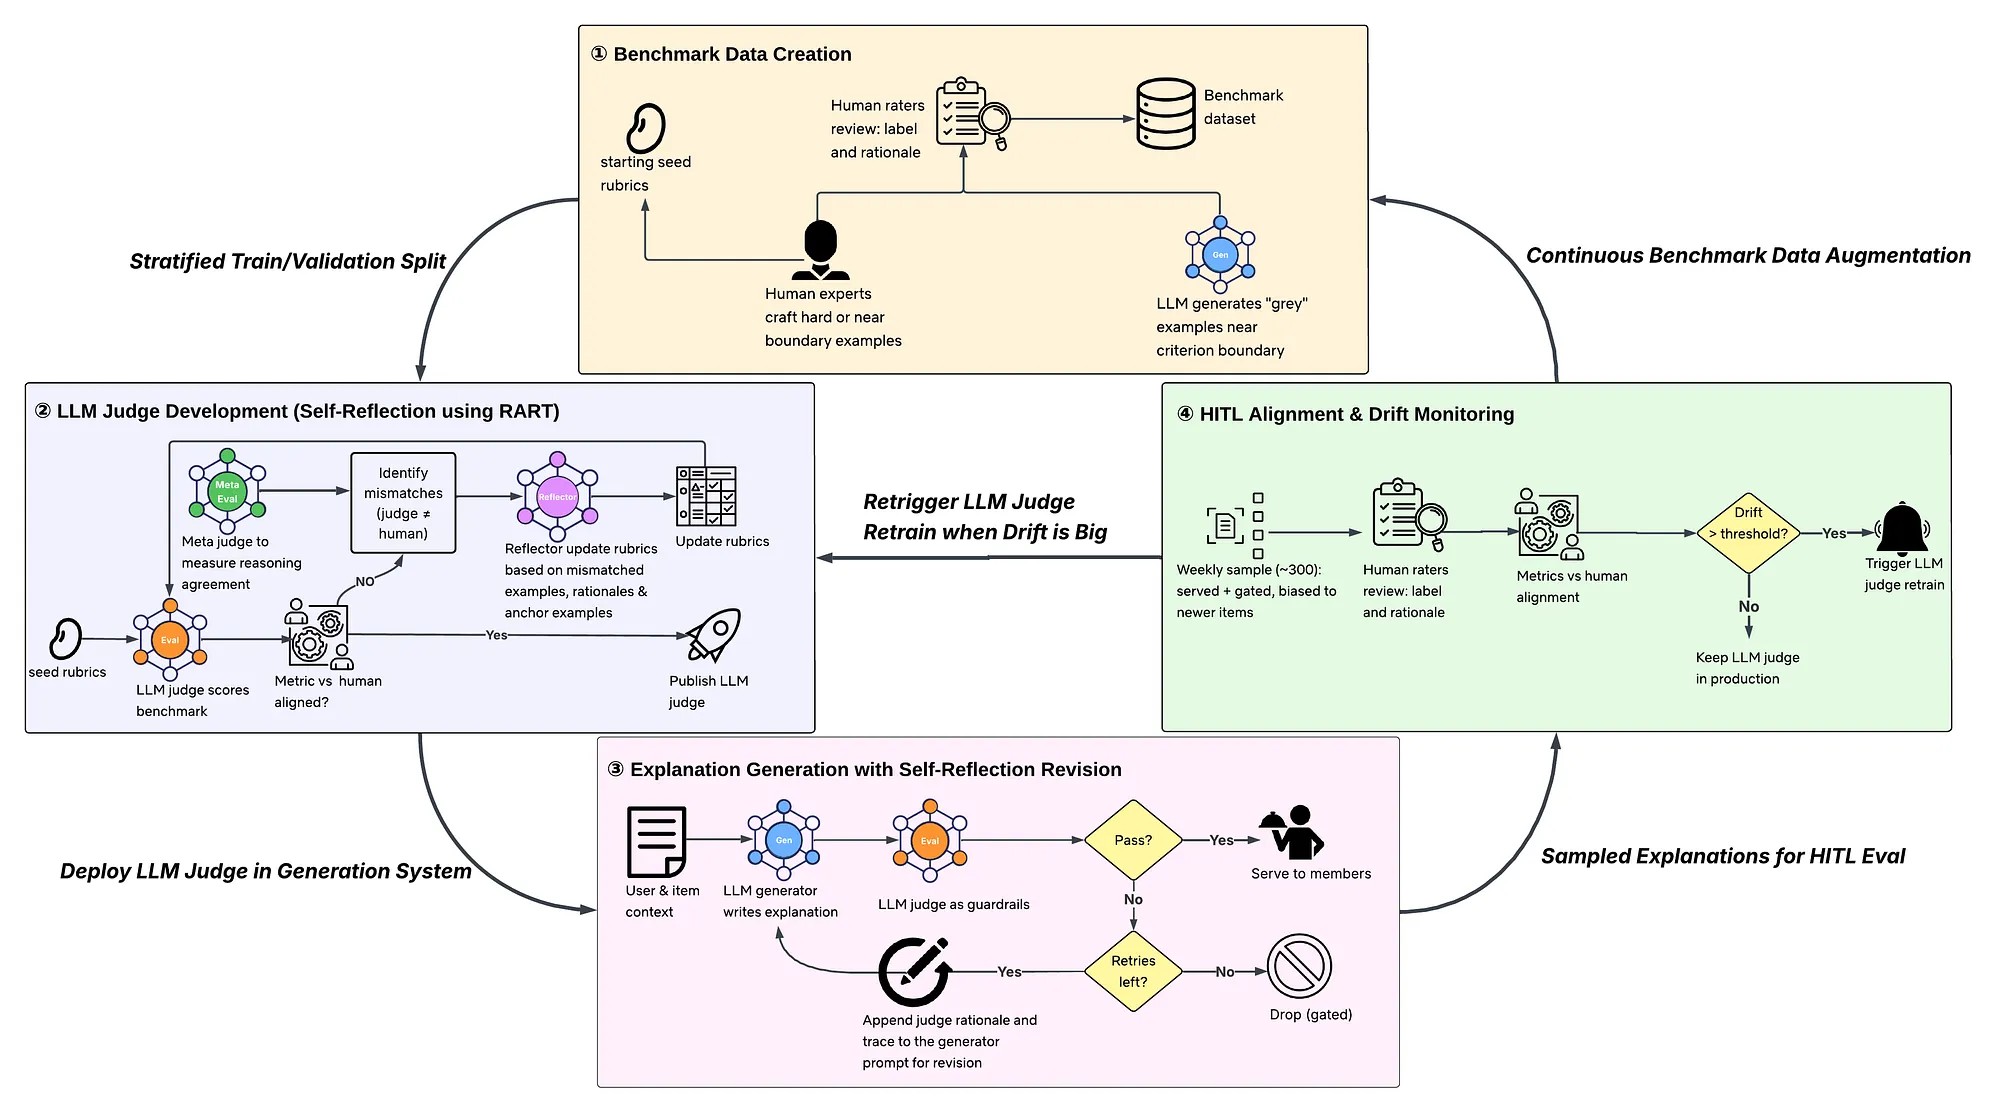
کار را با مرحله اول، یعنی تولد (Birth): ایجاد دادههای معیار (Benchmark Data Creation) آغاز میکنیم.
در این مرحله، متخصصان انسانی نمونههای دشوار یا نمونههایی را طراحی میکنند که در مرز تصمیمگیری قرار دارند. سپس ارزیابهای انسانی این نمونهها را با برچسبهای قبول/رد (Pass/Fail) و توضیحات مکتوب درباره دلایل تصمیمگیری، برچسبگذاری میکنند.
برای ساخت مجموعهدادهای غنیتر، نمونههای مبهم و مرزی دیگری را نیز با کمک LLM تولید میکنیم و به دادههای قبلی اضافه میکنیم.
در مرحله دوم، یعنی آموزش (Training): توسعه مدل داور LLM، مدل داور را بهگونهای تنظیم میکنیم که با برچسبها و دلایل ارائهشده توسط انسانها در مرحله تولد همراستا شود.
برای این کار از قابلیت خودبازبینی (Self-reflection) استفاده میکنیم تا اختلافهای میان قضاوت مدل و انسانها شناسایی شوند. سپس بر اساس این اختلافها و نمونههای مرجع (Anchor Examples)، معیارهای ارزیابی یا همان Rubricها را بهروزرسانی میکنیم.
این فرایند را آنقدر تکرار میکنیم تا معیارهای اندازهگیری نشان دهند که مدل داور بهاندازه کافی با ارزیابهای انسانی همراستا شده است.
در مرحله سوم، یعنی دپلویمنت (Deployment)، مدل داور را به سیستم تولید توضیحات اضافه میکنیم تا هم نقش یک فیلتر کنترلی (Gate) و هم نقش یک منتقد (Critic) را ایفا کند.
مدل تولیدکننده LLM توضیحات را مینویسد و مدل داور آنها را ارزیابی میکند. سپس یا توضیح را تایید و عبور میدهد یا آن را رد میکند و دلیل رد شدن را ارائه میدهد.
مدل تولیدکننده میتواند از این بازخورد برای اصلاح خروجی و تلاش مجدد استفاده کند.
در نهایت، توضیحات تاییدشده به کاربران نمایش داده میشوند و توضیحات بیکیفیت از انتشار بازمیمانند.
مرحله چهارم و پایانی، همراستاسازی با دخالت انسان و پایش انحراف (HITL Alignment & Drift Monitoring) است.
در این مرحله، تلاش میکنیم مدل داور را در طول زمان با قضاوت انسانها همراستا نگه داریم.
منظور از Human-in-the-Loop در اینجا این است که یک انسان مستقیماً در فرایند تصمیمگیری حضور داشته باشد، نه اینکه صرفاً پس از انجام کار، نتایج را بررسی کند.
ما عملکرد مدل داور را در مقایسه با ارزیابهای آموزشدیده بررسی میکنیم و پیش از اعمال هر تغییری در سیستم، تایید یک انسان را الزامی میدانیم.
در طول هر آزمایش، هر هفته تعدادی از توضیحات را نمونهبرداری میکردیم، هم توضیحاتی که تایید شده بودند و هم مواردی که از انتشار آنها جلوگیری شده بود. در این نمونهبرداری، وزن بیشتری به محتوای جدیدتر اختصاص میدادیم.
سپس ارزیابهای انسانی این توضیحات را بررسی و با برچسب و دلیل مشخص، ارزیابی میکردند. در ادامه، نتایج مدل داور را با ارزیابیهای انسانی مقایسه میکردیم.
اگر میزان انحراف از یک آستانه مشخص بیشتر میشد، فرایند آموزش مجدد (Retraining) و غنیسازی مجموعهداده معیار را آغاز میکردیم.
به این ترتیب، حلقه بازخورد تکمیل میشود و دادههای جدید برچسبگذاریشده توسط انسانها و سیگنالهای بهروزرسانیشده، دوباره به مراحل ایجاد دادههای معیار و توسعه مدل بازمیگردند.
اجزای سیستم (System Components)
در تمام مراحل این چرخه، چهار مولفه خودکار وجود دارند که در کنار نقشهای انسانی، وظیفه تعریف، اعتبارسنجی و نظارت بر سیستم را بر عهده دارند.
۱. تولیدکننده (Generator)
متن توضیحات را تولید میکند. در صورت نیاز، میتواند از دلایل و ردپاهای ارزیابی قبلی مدل داور نیز در Prompt خود استفاده کند تا خروجی را اصلاح کند.
۲. داور (Judge)
یک توضیح را ارزیابی میکند و همراه با یک دلیل مکتوب، برچسب قبول یا رد را برمیگرداند.
در خط لوله مستقرشده در محیط عملیاتی (Production Pipeline)، این مولفه دو نقش دارد:
- نقش حفاظتی (Guardrail): جلوگیری از انتشار خروجیهای نامناسب.
- نقش منتقد (Critic): ارائه بازخورد برای اصلاح و بهبود خروجی توسط مدل تولیدکننده.
۳. بازتابدهنده (Reflector)
هنگامی که مدل داور اشتباه میکند، معیارهای ارزیابی (Rubric) آن را اصلاح میکند.
این مولفه بر اساس نمونههایی که مدل در آنها با انسان اختلاف داشته، دلایل ارائهشده توسط ارزیابهای انسانی و نمونههای مرجع، متن Rubric را بهروزرسانی میکند.
وظیفه Reflector تنظیم و اصلاح معیارهای ارزیابی است، نه ارزیابی مستقیم توضیحات.
۴. فراداور (Meta-Judge)
بررسی میکند که آیا مدل داور یک توضیح را به دلیل درستی رد کرده است یا خیر.
برای این کار، دلیل ارائهشده توسط مدل داور را با دلیل ارائهشده توسط ارزیاب انسانی مقایسه میکند.
۵. متخصصان و ارزیابهای انسانی (Human Experts and Raters)
این گروه شامل چند نقش مختلف است:
- متخصصانی که معیارهای کیفیت را تعریف میکنند.
- ارزیابهایی که برچسبها و دلایل مکتوب آنها مبنای تنظیم و سنجش مدل داور قرار میگیرد.
- بازبینهایی که عملکرد مدل داور را در زمان اجرا زیر نظر دارند و پیش از انتشار هر تغییری، آن را بهصورت صریح تایید میکنند.
مرحله اول، تولد: تعیین حقیقت مبنا (Phase I, Birth: Establishing Ground Truth)
تمام مراحل بعدی به این موضوع وابسته هستند که بدانیم منظورمان از «خوب» دقیقاً چیست. به همین دلیل، این مرحله بیشترین میزان مشارکت انسانی را نیاز دارد.
متخصصان داخلی ما در حوزه نگارش محتوا، معیارهای ضروریای را تعریف میکنند که هر توضیح باید آنها را برآورده کند. آنها دستورالعملهای دقیق برچسبگذاری را تدوین میکنند و نمونههای دشوار و چالشبرانگیز (Adversarial Examples) را بهصورت دستی میسازند.
همین دستورالعملها دو کاربرد همزمان دارند:
- بهعنوان مجموعه قوانین و راهنمای کار ارزیابهای انسانی استفاده میشوند.
- بهعنوان Rubric اولیه برای مدلهای داوری LLM که در مراحل بعدی تنظیم میکنیم، به کار میروند.
چرا مجموعهداده معیار اختصاصی خودمان را ساختیم؟
مجموعهدادههای معیار آماده برای ارزیابی مدلهای داور، معمولاً بر ارزیابی عمومی متن تمرکز دارند و ویژگیهای خاص وظیفه ما را در نظر نمیگیرند.
توضیحات ما کوتاه، وابسته به یک محتوای مشخص و وابسته به زمینه (Context-dependent) هستند. هر توضیح به یک عنوان هدف و یک یا دو عنوان مرجع که کاربر قبلاً تماشا کرده، مرتبط است.
علاوه بر این، برای ما مهم است که خروجیها با استانداردهای محتوایی و ویراستاری اختصاصی خودمان همراستا باشند، نه اینکه صرفاً از نظر کیفیت عمومی زبان مناسب به نظر برسند.
به همین دلیل، مجموعهداده معیار اختصاصی خود را از سه منبع مکمل ایجاد کردیم:
۱. نمونههای خصمانه طراحیشده توسط متخصصان (Expert-crafted Adversarial Cases)
نمونههای قبول و رد که بهصورت دستی نوشته شدهاند و حالتهای شکست مشخصی دارند. این نمونهها شامل موارد مرزی و خاصی هستند که هیچ روش دیگری نمیتواند بهطور قابلاعتماد آنها را تولید کند.
۲. نمونههای مرزی (Boundary Examples)
توضیحاتی که با استفاده از LLM تولید شدهاند و عمداً به محدوده مرزی میان قبول و رد نزدیک شدهاند. سپس این نمونهها توسط انسانها ارزیابی شدهاند.
این نمونهها موارد مبهمی را پوشش میدهند که معمولاً از نمونهبرداری ترافیک واقعی بهتنهایی به دست نمیآیند.
۳. توضیحات واقعی نمونهبرداریشده (Real Sampled Explanations)
توضیحاتی که در جریان اجرای آزمایشها، از خروجی واقعی مدل تولیدکننده LLM نمونهبرداری شدهاند.
دو نکته مهم
اول: مجموعهداده معیار ثابت و بدون تغییر نیست.
یک خط لوله پایش (Monitoring Pipeline) در مرحله چهارم، هر هفته مجموعه جدیدی از توضیحات ارزیابیشده توسط انسانها را به آن اضافه میکند.
به این ترتیب، در طول اجرای آزمایش، مجموعهداده معیار همواره با کاتالوگ فعلی محتوا و الگوهای جدید استفاده از سیستم هماهنگ باقی میماند و بهمرور قدیمی و منسوخ نمیشود.
دوم: هر برچسب «رد» باید همراه با دلیل متنی باشد.
هر نمونهای که برچسب Fail دریافت میکند، یک توضیح متنی آزاد (Free-text Rationale) نیز دارد که مشخص میکند چرا آن توضیح رد شده است.
این موضوع شاید در نگاه اول یک جزئیات کوچک در ثبت دادهها به نظر برسد، اما در مرحله بعد اهمیت حیاتی پیدا میکند، زیرا از همین دلایل برای تنظیم و ممیزی فرایند استدلال مدل داور استفاده میکنیم.
مرحله دوم، آموزش: همراستاسازی مدل داور با انسانها (Phase II, Training: Aligning the Judge to Humans)
حالت شکست: پاسخ درست، دلیل اشتباه (The Failure Mode: Right Answer, Wrong Reason)
یک نوع خطا وجود دارد که اصلاً در معیارهای توافق برچسب (Label Agreement) قابل مشاهده نیست.
ممکن است مدل داور در برچسبگذاری کاملاً با انسانها موافق باشد، یعنی همان مواردی را تایید کند که انسانها تایید میکنند و همان مواردی را رد کند که انسانها رد میکنند، اما برای رسیدن به نتیجه درست، از دلیل اشتباهی استفاده کرده باشد.
در داشبورد، همهچیز کاملاً هماهنگ و درست به نظر میرسد.
اما بهمحض اینکه از مدل بخواهید دلیل رد یک خروجی را توضیح دهد ــ کاری که در خط لوله ما برای هدایت فرایند اصلاح خروجی انجام میشود ــ ممکن است بازخوردی گمراهکننده ارائه کند.
به همین دلیل، برای ما فقط توافق در برچسبگذاری اهمیت ندارد، بلکه همراستایی در استدلال (Reasoning Alignment) نیز اهمیت دارد.
در ساختار ما، از مدل داور همیشه خواسته میشود دو خروجی تولید کند:
- یک برچسب (برای مثال PASS/FAIL).
- یک دلیل کوتاه به زبان طبیعی برای آن برچسب.
در ادامه، یک مثال توضیحی را بررسی میکنیم.
فرض کنید یکی از کاربران یک فیلم موزیکال تماشا کرده است، اثری فانتزی و خانوادگی که شخصیت اصلی آن یک دختر جوان است و گروهی از بازیگران شناختهشده در آن حضور دارند.
سیستم پیشنهاددهنده، یک فیلم ماجراجویی را پیشنهاد میکند که آن هم اثری فانتزی و خانوادگی با شخصیت اصلی دختر جوان است. به همین دلیل، سیستم این دو فیلم را به یکدیگر مرتبط کرده است.
اما فیلم پیشنهادی نه ترانههای مشابهی دارد و نه از همان گروه بازیگران استفاده میکند.
مثال تصویری از ارزیابی مدل داور و دلیل ارائهشده برای رد توضیح.
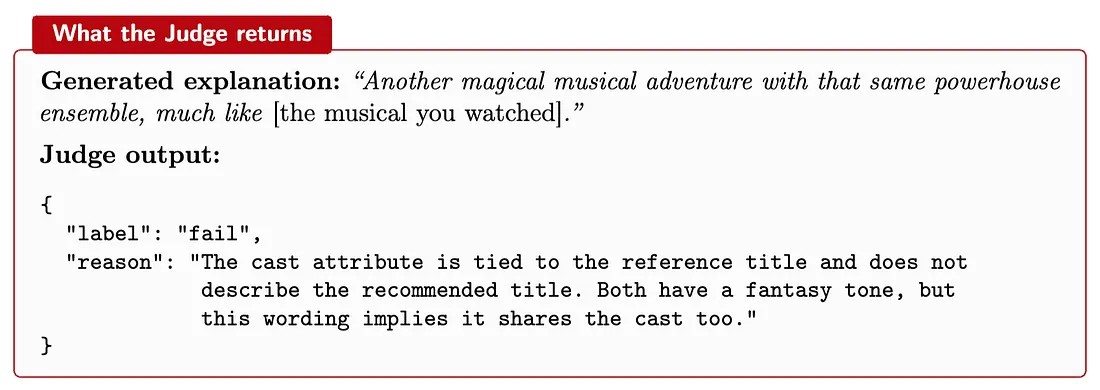
برچسب مدل داور (FAIL) درست است و دلیلی که در نگاه اول ارائه میدهد نیز منطقی به نظر میرسد.
اما همانطور که در ادامه نشان میدهیم، این دلیل ناقص است، نقصی که با بررسی ساده توافق برچسبها قابل شناسایی نیست.
تنظیم Rubric با همراستاسازی استدلال (Reasoning-Aligned Rubric Tuning)
ما برای تنظیم مدل داور هر معیار، از روشی استفاده میکنیم که آن را Reasoning-Aligned Rubric Tuning (RART) نامیدهایم.
همانطور که در بخش اجزای سیستم توضیح دادیم، سه مولفه Judge، Meta-Judge و Reflector از یکدیگر مستقل هستند:
- Judge یک توضیح را بر اساس Rubric ارزیابی میکند و دلیل تصمیم خود را ارائه میدهد.
- Meta-Judge این دلیل را با دلیل نوشتهشده توسط انسان مقایسه میکند.
- Reflector متن خود Rubric را ویرایش و اصلاح میکند.
RART روشی است که این سه مولفه را در قالب یک چرخه آموزشی به یکدیگر متصل میکند.
هر مدل Judge از یک قالب ثابت Prompt استفاده میکند که Rubric بهعنوان پارامتر به آن داده میشود. بنابراین، تنظیم مدل به معنای آموزش مجدد مدل پایه نیست.
در عوض، متن Rubric را بهصورت تکرارشونده اصلاح میکنیم تا رفتار مدل داور با برچسبها و دلایل ارائهشده توسط انسانها مطابقت پیدا کند.
در تکرار شماره i، مدل Judge با استفاده از متن فعلی Rubric شرطیسازی میشود و یک توضیح را به یک زوج خروجی تبدیل میکند: یک برچسب و یک دلیل.
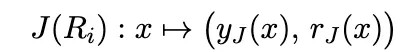
در این رابطه:
R_iمتن فعلی Rubric است.y_J(x)برچسب تولیدشده توسط Judge است.r_J(x)دلیل ارائهشده توسط Judge است.
در سطح کلی، هر تکرار از فرایند RART به شکل زیر انجام میشود:
1. دادههای آموزشی را با استفاده از Rubric فعلی امتیازدهی میکنیم.
2. معیارهای همراستایی وزندهیشده را روی مجموعه اعتبارسنجی مستقل (Held-out Validation Set) ارزیابی میکنیم. اگر تمام معیارهای مربوط به هر یک از معیارهای اصلی از آستانه تعیینشده بالاتر باشند، فرایند متوقف میشود.
3. در غیر این صورت، مجموعهای از نمونههای دارای اختلاف و خطا (Error-driven Focus Set) ایجاد میکنیم و آن را در اختیار Reflector قرار میدهیم تا نسخه اصلاحشدهای از Rubric پیشنهاد کند.
تفاوت اصلی این روش با یک چرخه معمولی در نحوه تعریف «اشتباه» است.
بیشتر چرخههای خودبهبوددهی (Self-improvement Loops) فقط اختلاف در برچسبها را بررسی میکنند.
اما RART یک دسته دوم از خطاها را نیز در نظر میگیرد.
Meta-Judge مواردی را بررسی میکند که در آنها هم مدل Judge و هم ارزیاب انسانی به یک نتیجه مشترک، یعنی Fail، رسیدهاند. سپس دلیل ارائهشده توسط مدل داور را با دلیل ارزیاب انسانی مقایسه میکند.
اگر این دو دلیل با یکدیگر اختلاف داشته باشند، با خطای «پاسخ درست، دلیل اشتباه» مواجه هستیم. این نمونه نیز به Reflector ارسال میشود.
بهطور مشخص، مجموعه نمونههایی که در اختیار Reflector قرار میگیرند، اجتماع دو دسته خطا هستند:
- عدم تطابق برچسبها (Label Mismatches): نمونههایی که در آنها برچسب مدل داور با برچسب ارزیاب انسانی متفاوت است.
- برچسب درست، دلیل اشتباه (Right Label, Wrong Reason): نمونههایی که در آنها مدل Judge و ارزیاب انسانی هر دو برچسب FAIL دادهاند، اما Meta-Judge تشخیص میدهد که دلایل ارائهشده توسط آنها با یکدیگر مطابقت ندارند.
بنابراین، رفلکتور، Rubric را بر اساس هر دو نوع خطا اصلاح میکند: هم خطاهای معمول در برچسبگذاری و هم خطاهای مربوط به درست بودن نتیجه و اشتباه بودن دلیل.
این دسته دوم، هسته اصلی روش RART است.
در این روش، مدل Judge نهتنها باید تصمیمهای انسانی را تکرار کند، بلکه باید بتواند آن تصمیمها را با استدلالی توجیه کند که از نظر Meta-Judge با شیوه استدلال انسانها همراستا باشد.
اگر به مثال قبلی برگردیم، مدل Judge برچسب FAIL داده و ارزیاب انسانی نیز همین برچسب را انتخاب کرده است. بنابراین، یک بررسی ساده که فقط برچسبها را مقایسه میکند، این مورد را بهعنوان یک توافق موفق ثبت خواهد کرد.
اما وقتی دو دلیل را در کنار یکدیگر قرار میدهیم، مشخص میشود که این بررسی ساده چه چیزی را نادیده گرفته است.
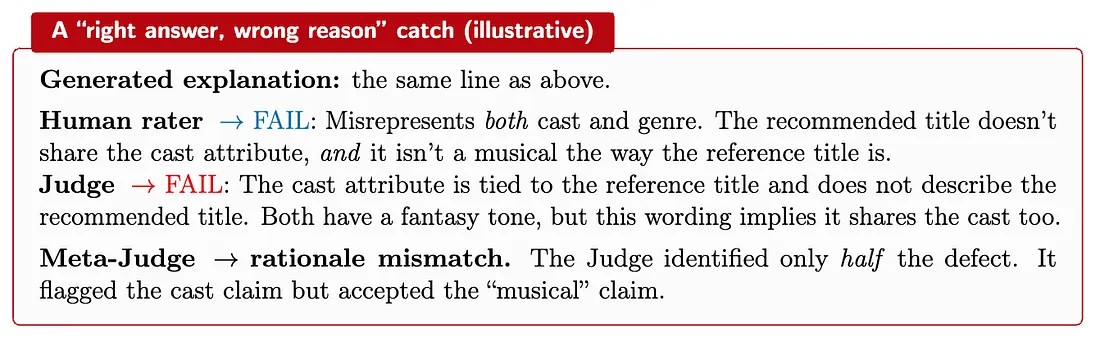
روش RART این نمونه را وارد مجموعه تمرکز بر خطا (Focus Set) میکند تا در نسخه بعدی Rubric، این اختلاف نیز برطرف شود.
از آنجا که Meta-Judge نیز خودش یک مدل LLM است، ابتدا عملکرد آن را در مقایسه با انسانها بررسی کردیم.
ارزیابهای انسانی آموزشدیده، نمونهای از زوجدلیلهایی را که هر دو طرف در آنها برچسب Fail داده بودند، بررسی کردند. نتایج نشان داد که Meta-Judge تقریباً در تمام این موارد با تصمیم ارزیابهای انسانی مطابقت داشته است.
معیارهای همراستایی (Alignment Metrics)
برای هر معیار، یک مدل Judge مستقل داریم که Rubric اختصاصی خودش را دارد و بهصورت جداگانه تنظیم و ارزیابی میشود.
بنابراین، تمام نتایجی که در ادامه ارائه میکنیم، برای هر معیار بهصورت مستقل و بر اساس دادههای اعتبارسنجی جداگانه اندازهگیری شدهاند.
برای هر معیار، سه شاخص را دنبال میکنیم:
- ویژگیمندی (Specificity یا Fail-Recall): این شاخص نشان میدهد مدل داور چند وقت یکبار توضیحات نامناسب را بهدرستی رد میکند. این مهمترین شاخص برای ماست، زیرا عبور یک توضیح نامناسب از فیلتر، میتواند اعتماد کاربران را به خطر بیندازد.
- یادآوری (Recall یا Pass-Recall): نشان میدهد مدل چند وقت یکبار توضیحات خوب را بهدرستی تایید میکند. این شاخص به حفظ پوشش مناسب (Coverage) و پایین نگه داشتن هزینه اصلاح خروجیها کمک میکند.
- توافق در استدلال (Reasoning Agreement): در میان توضیحاتی که هر دو طرف آنها را رد کردهاند، نشان میدهد چند درصد از موارد به دلیل یکسانی رد شدهاند.
هر مدل Judge برای هر معیار، سه شاخص اختصاصی خودش را دارد. ممکن است عملکرد یک مدل در وضعیت مطلوبی باشد، درحالیکه عملکرد مدل دیگر افت کرده باشد.
به همین دلیل، فیلتر ما سختگیرانه طراحی شده است.
یک توضیح تنها زمانی مجاز به انتشار است که تمام معیارهای ضروری را با موفقیت پشت سر بگذارد.
آزمایش حذف مولفه (Ablation): آیا سیگنال استدلال واقعاً کمک میکند؟
برای اینکه تاثیر سیگنال استدلال را بهصورت مستقل بررسی کنیم، روش RART را با یک چرخه مشابه مقایسه کردیم که فقط از اختلاف برچسبها استفاده میکند.
این روش پایه را Vanilla نامیدیم.
در این روش، همهچیز مانند RART است:
- همان Reflector
- همان Judge
- همان دادهها
اما Meta-Judge و دلایل انسانی در فرایند استفاده نمیشوند.
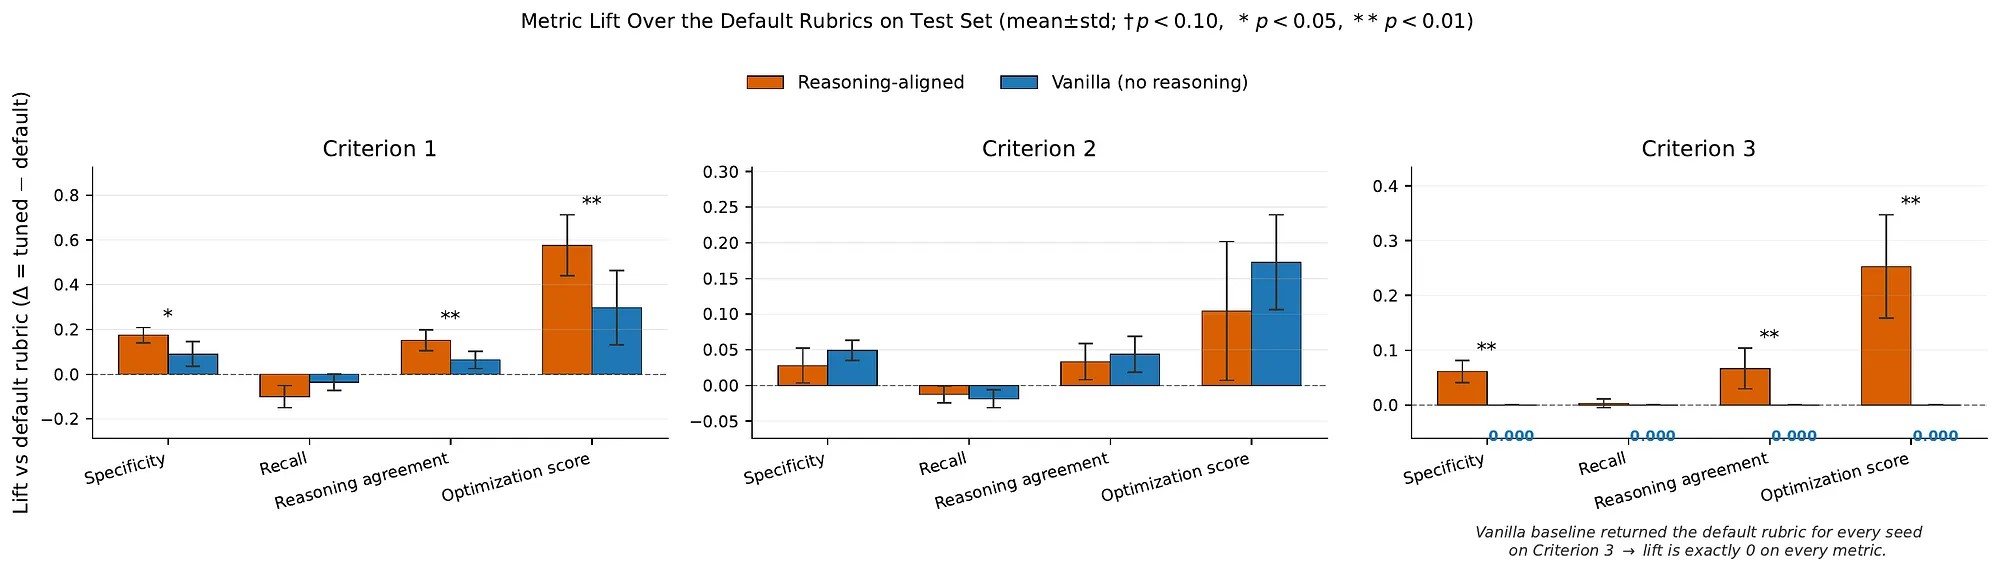
شکل ۲ نتایج این آزمایش را نشان میدهد.
در دو مورد از سه معیار ضروری، هر دو روش Vanilla و RART به نتیجه یکسانی رسیدند، زیرا Rubric اولیه از همان ابتدا عملکرد بسیار خوبی داشت و فضای زیادی برای بهبود باقی نمانده بود.
اما در معیار سوم، روش Vanilla که فقط بر اساس برچسبها کار میکند، عملکرد را بدتر کرد.
Reflector در چرخه وانیلا، Rubric را به شکلهای نامناسب و بیاثر بازنویسی کرد. در نتیجه، با هر بار تکرار، شاخصهای Specificity و Reasoning Agreement کاهش پیدا کردند و در نهایت عملکرد Rubric از نسخه اولیه آن نیز بدتر شد.
در مقابل، RART در همان معیار عملکرد خود را پایدار نگه داشت و هر دو شاخص را بهبود داد. همچنین، مقدار کمی بهبود در Recall نیز مشاهده شد.
دلیل این اتفاق آن است که یک بهینهساز مبتنی بر برچسب (Vanilla) میتواند با استفاده از استدلالی نامعتبر به برچسب درست برسد، اما چنین استدلالی معمولاً به دادههای جدید تعمیم پیدا نمیکند.
متصل کردن سیگنال ارزیابی به دلایل انسانی، از بروز این مشکل جلوگیری میکند.
در نتیجه، همراستایی استدلال در شرایطی که ظرفیت بهبود وجود دارد، به عملکرد کمک میکند و در شرایطی که عملکرد از قبل مطلوب است، باعث افت آن نمیشود.
مرحله سوم، استقرار: بهکارگیری مدل داور (Phase III, Deployment: Putting the Judge to Work)
پس از استقرار، مدل داور درون خط لوله تولید قرار گرفت و در طول آزمایشها، توضیحات تولیدشده را هم فیلتر میکرد و هم مورد انتقاد و بررسی قرار میداد.
دو نقش برای یک مدل داور (Two Roles for One Judge)
پس از اینکه مدل Judge را با قضاوت انسانها همراستا کردیم، از همان مدل برای دو نقش متفاوت در ارزیابی هر توضیح تولیدشده استفاده کردیم:
- نقش اول: فیلتر (Gate). مدل Judge هر توضیح را بر اساس معیارهای ضروری ارزیابی میکند و هر خروجیای را که نتواند این معیارها را برآورده کند، رد میکند.
- نقش دوم: منتقد (Critic). وقتی یک توضیح رد میشود، صرفاً آن را دور نمیاندازیم. دلیل متنی که مدل Judge ارائه کرده است، به Prompt مدل Generator اضافه میشود تا مدل تولیدکننده بتواند دوباره تلاش کند و نسخه بهتری از توضیح را تولید کند.
نقش دوم باعث میشود خط لوله ما به یک چرخه تبدیل شود:
Generate → Judge → Reviseیعنی تولید، ارزیابی و اصلاح.
در این چرخه، نقد و بازخورد مدل Judge مسیر هر بار اصلاح را مشخص میکند.
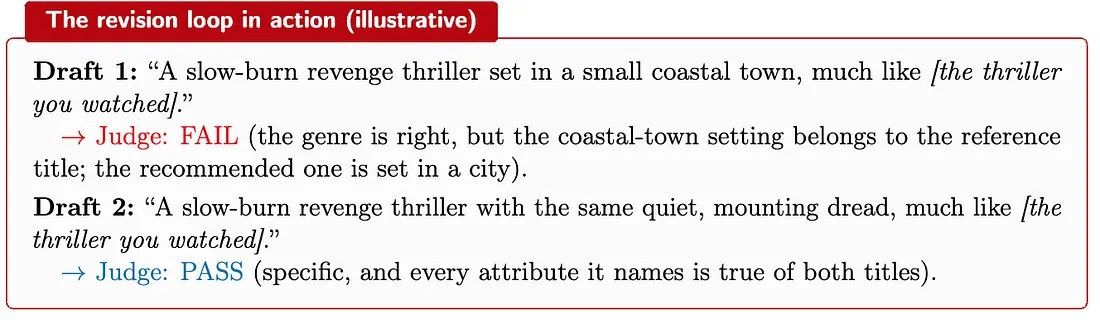
تلاشهای مجدد محدود و دلیل حذف خروجی بهجای انتشار آن
تعداد دفعات تلاش مجدد (Retry) را محدود میکنیم.
هر بار اصلاح خروجی، به یک مرحله دیگر از تولید و ارزیابی نیاز دارد و هزینه محاسباتی سیستم را افزایش میدهد. از طرف دیگر، میزان بهبود خروجی پس از چند بار تکرار، بهسرعت کاهش پیدا میکند.
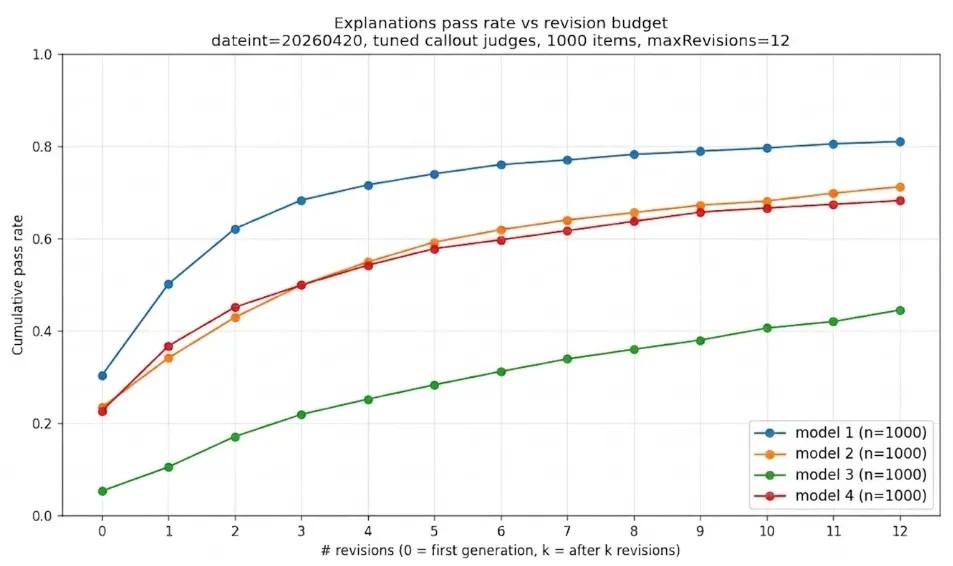
شکل ۳ نشان میدهد این چرخه در عمل چه میزان بهبود ایجاد میکند.
در این آزمایش، ۱۰۰۰ توضیح تولیدشده را با چهار مدل Generator بررسی کردیم و اجازه دادیم هر توضیح حداکثر ۱۲ بار اصلاح شود.
تمام منحنیها روند صعودی دارند. این موضوع نشان میدهد بازخورد مدل Judge در بهبود خروجیها موثر است.
بااینحال، بخش عمده بهبود در مراحل ابتدایی اتفاق میافتد و تفاوت عملکرد میان مدلهای تولیدکننده نیز کاملاً مشخص است.
اصلاح و بازبینی، عملکرد یک مدل تولیدکننده توانمند را تقویت میکند، اما نمیتواند یک مدل ضعیف را نجات دهد.
در آزمایشهای خود، با استفاده از قویترین مدل Generator، بودجه سه بار تلاش مجدد را در نظر گرفتیم.
اگر یک توضیح پس از این سه بار تلاش همچنان معیارهای مدل Judge را برآورده نمیکرد، بهجای انتشار، بهطور کامل حذف میشد.
این قانون که «حذف بهجای انتشار» نام دارد، کاملاً آگاهانه انتخاب شده است.
زیرا این دو نتیجه از نظر پیامد یکسان نیستند.
یک توضیح نامناسب میتواند اعتماد کاربران را از بین ببرد، درحالیکه نمایش ندادن یک توضیح صرفاً به معنای از دست دادن یک فرصت است.
بنابراین، در شرایطی که مطمئن نیستیم، ترجیح میدهیم هیچ توضیحی نمایش ندهیم.
البته در عمل، بیشتر توضیحات در همان محدوده تلاشهای مجدد تعیینشده، معیارهای لازم را پشت سر گذاشتند.
آیا توضیحاتی که توسط Judge تایید میشوند واقعاً به کاربران کمک میکنند؟
عبور از ارزیابی Judge ثابت میکند که یک توضیح بر اساس استانداردهای ما کیفیت مناسبی دارد، اما این موضوع بهتنهایی ثابت نمیکند که آن توضیح برای کاربران مفید است.
برای بررسی این ارتباط، یک آزمایش کنترلشده یکباره در اپلیکیشن موبایل نتفلیکس اجرا کردیم.
در این آزمایش، دو گروه از کاربران را مقایسه کردیم:
- گروهی که در صفحه جزئیات محتوا توضیحات مربوط به پیشنهادها را مشاهده میکردند.
- گروهی که هیچ توضیحی دریافت نمیکردند.
این آزمایش حدود یک ماه طول کشید. در همین مدت، خط لوله ما هر هفته صدها هزار توضیح را تولید و ارزیابی میکرد.
نتایج نشان داد کاربرانی که توضیحات را مشاهده کرده بودند، بیشتر به سمت تماشای محتواهایی رفتند که قبلاً ندیده بودند.
همچنین، تعداد بیشتری از جلسات جستوجو و مرور محتوای آنها (Browse Sessions) در نهایت به یک پخش معنادار محتوا (Meaningful Play) منجر شد.
هر دو اثر از نظر آماری معنادار بودند.
همچنین، در طول آزمایش هیچ موردی از درخواست حذف محتوا یا ارجاع شکایت از سوی کاربران درباره کیفیت توضیحات مشاهده نکردیم.
مهمترین نتیجهای که باید از این آزمایش به خاطر بسپاریم، اندازه این تاثیر نیست.
بلکه این است که توافق آفلاین مدل داور با ارزیابهای انسانی برای عملکرد موفق توضیحات ضروری بود، اما بهتنهایی کافی نبود.
تنها آزمایش آنلاین A/B توانست ثابت کند که توضیحات همراستا با مدل داور، صرفاً از نظر کیفیت با استانداردهای ما مطابقت ندارند، بلکه واقعاً برای کاربران نیز مفید هستند.
مرحله چهارم، پایش: حفظ همراستایی مدل داور (Phase IV, Monitoring: Keeping the Judge Aligned)
مدلی که در زمان شروع به کار با انسانها همراستا بوده، لزوماً در آینده نیز همین وضعیت را حفظ نخواهد کرد.
کاتالوگ محتوا تغییر میکند و همزمان، تعریف ما از کیفیت بالا نیز ممکن است تغییر کند.
بنابراین، چرخه عمر سیستم باید بهگونهای طراحی شود که این حلقه بازخورد همواره فعال باقی بماند.
بررسی هفتگی توسط انسانها (The Weekly Human Review)
در هر هفتهای که آزمایش در حال اجرا بود، حدود ۳۰۰ توضیح تولیدشده را برای بررسی انسانی انتخاب میکردیم.
این نمونهها بهصورت طبقهبندیشده (Stratified Sampling) و بر اساس تصمیمهای مدل Judge انتخاب میشدند:
- توضیحاتی که منتشر شده بودند (Served).
- توضیحاتی که اصلاح شده بودند (Revised).
- توضیحاتی که حذف شده بودند (Dropped).
همچنین، وزن بیشتری به آیتمهای جدیدتر کاتالوگ اختصاص میدادیم، زیرا احتمال بروز انحراف در این موارد بیشتر است.
روش نمونهبرداری در تمام هفتهها ثابت باقی میماند تا بتوان نتایج هفتههای مختلف را با یکدیگر مقایسه کرد.
یک گروه متشکل از حداقل سه ارزیاب، هر توضیح را بررسی میکردند و برچسبی که اکثریت ارزیابها انتخاب کرده بودند، بهعنوان حقیقت مبنا (Ground Truth) در نظر گرفته میشد.
این برچسبها دو کاربرد داشتند:
1. مشخص میکردند که آیا میزان توافق میان مدل Judge و ارزیابهای انسانی در حال کاهش است یا خیر.
2. به غنیتر شدن مجموعهداده معیار کمک میکردند.
تعیین آستانه با استفاده از اختلافنظر انسانها (Setting the Bar with Human Disagreement)
گروه ارزیابها علاوه بر برچسب نهایی، میزان اختلافنظر میان خودشان را نیز مشخص میکنند.
این اختلافنظر در واقع معیار مناسبی برای سنجش عملکرد مدل Judge است.
بهجای اینکه یک آستانه ثابت برای مدل تعیین کنیم، عملکرد مدل Judge و هر یک از ارزیابهای انسانی را در مقایسه با همان برچسب اکثریت محاسبه میکنیم.
سپس بررسی میکنیم که آیا عملکرد مدل Judge در محدوده پراکندگی عملکرد ارزیابهای انسانی قرار دارد یا خیر.
فرض کنید یک معیار مشخص و یکی از شاخصهای آن را با M نشان دهیم.
نمونههای انتخابشده در آن هفته، یک مقدار برای مدل Judge با نماد M(J) و مجموعهای از مقادیر برای هر یک از ارزیابهای انسانی با نماد M(H) در اختیار ما قرار میدهند.
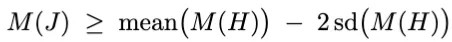
این گروه شامل سه ارزیاب یا بیشتر است.
شرط ما به این صورت است:
شرط پذیرش عملکرد مدل Judge بر اساس میانگین و انحراف معیار عملکرد ارزیابهای انسانی.
بنابراین، امتیاز مدل Judge نباید بیش از دو انحراف معیار پایینتر از میانگین امتیاز ارزیابهای انسانی باشد.
در هفتههایی که ارزیابی دشوارتر است و اختلافنظر میان انسانها افزایش پیدا میکند، محدوده مجاز نیز متناسب با آن گستردهتر میشود.
به این ترتیب، مدل Judge به دلیل دشواریای که خود انسانها نیز با آن مواجه شدهاند، بهناحق جریمه نمیشود.
اگر عملکرد مدل در هر ترکیبی از معیار و شاخص، پایینتر از این محدوده قرار بگیرد، یک رویداد انحراف (Drift Event) ثبت میشود.
این اتفاق باعث آغاز فرایند تنظیم مجدد مدل (Re-tuning) در مرحله دوم و بر اساس مجموعهداده معیار غنیشده میشود.
البته Rubric اصلاحشده هرگز بهصورت خودکار وارد محیط عملیاتی نمیشود.
یکی از اعضای تیم باید تغییرات پیشنهادی را بررسی کند و پیش از اعمال آنها در خط لوله فعال سیستم، تایید نهایی خود را ارائه دهد.
همچنین، نسخه قبلی Rubric را نگه میداریم تا در صورت نیاز بتوانیم فوراً به نسخه قبلی بازگردیم (Rollback).
چه چیزهایی را بررسی انسانی شناسایی میکند که معیارهای عددی قادر به تشخیص آنها نیستند؟
بررسی هفتگی انسانی، علاوه بر پاسخ دادن به این سوال که آیا مدل Judge همچنان با ارزیابهای انسانی توافق دارد یا خیر، به سوال دومی نیز پاسخ میدهد:
آیا دستورالعملها و معیارهای فعلی هنوز چیزهای درستی را از ما میخواهند؟
در فرایند بررسی هفتگی، بازبینها مشکلاتی را شناسایی کردند که در معیارهای توافق میان Judge و ارزیابهای انسانی دیده نمیشدند.
برای مثال:
- ممکن است یک توضیح از ویژگیهای دقیق و واقعی دو عنوان استفاده کند، اما میزان شباهت آنها را بیش از حد واقعی نشان دهد.
- استفاده از یک صفت مبهم مانند «هیجانانگیز»، «سرگرمکننده» یا «احساسی» ممکن است از نظر فنی معیارهای Rubric را برآورده کند، اما در عمل اطلاعات چندانی به کاربر ندهد.
- گاهی مشکل از خود عنوان مرجع است، یعنی محتوایی که کاربر اصلاً آن را مشابه عنوان پیشنهادی نمیداند. در چنین شرایطی، مقایسه حتی اگر ویژگیهای مشترک درستی داشته باشد، همچنان عجیب و نامناسب به نظر میرسد.
- برخی ژانرها نیز در مقیاس بزرگ همین مشکل را نشان میدهند. برای مثال، برنامههای استندآپ کمدی ممکن است برچسبهای متادیتای مشابهی داشته باشند، اما از نظر لحن و زمینه فرهنگی کاملاً متفاوت باشند. بنابراین، ممکن است مقایسه آنها روی کاغذ منطقی به نظر برسد، آنقدر نامناسب نباشد که ارزیاب انسانی آن را رد کند، اما همچنان برای کاربران تجربه خوبی ایجاد نکند.
- برخی توضیحات تمام معیارهای ضروری را رعایت میکنند، اما در نهایت شبیه مجموعهای از کلمات عمومی و بیارتباط به نظر میرسند، چیزی که کمک چندانی به کاربر نمیکند.
هر زمان که یک الگوی تکرارشونده از این مشکلات مشاهده میکردیم، دستورالعملهای مرحله اول را بهروزرسانی میکردیم.
این دستورالعملها هم مبنای راهنمای ارزیابهای انسانی هستند و هم Rubric مدلهای داور را شکل میدهند. بنابراین، اصلاح آنها باعث بهروزرسانی هر دو بخش میشود.
در برخی موارد دیگر، قوانین جدیدی را خارج از مدل Judge و در سطح محصول اضافه کردیم، برای مثال، با جلوگیری از استفاده برخی انواع محتوا بهعنوان عنوان مرجع.
تشخیص انحراف مشخص میکند که چه زمانی مدل داور دیگر با قضاوت انسانها هماهنگ نیست.
اما تنها بررسی مستمر انسانی میتواند به ما نشان دهد که چه زمانی تعریف ما از یک «توضیح خوب» بیش از حد محدود یا ناقص شده است.
ما به هر دو مورد نیاز داریم:
- تشخیص انحراف (Drift Detection): مدل Judge را با Rubric فعلی همراستا نگه میدارد.
- بررسی مستمر انسانی (Continuous Human Review): Rubric را با آنچه واقعاً برای کاربران مفید است، همراستا نگه میدارد.
آموختههای ما (What We Learned)
پنج درسی که فکر میکنیم برای هر تیمی که قصد عرضه یک مدل داور مبتنی بر LLM را دارد، قابل استفاده هستند:
۱. پیش از ساخت مدل داور، روی مجموعهداده معیار سرمایهگذاری کنید.
یک مجموعهداده معیار کوچک اما دارای دلایل مکتوب و دقیق، بسیار ارزشمندتر از یک مجموعهداده بزرگ است که فقط برچسب دارد.
همین دلایل مکتوب هستند که امکان تنظیم مدل بر اساس همراستایی استدلال (Reasoning-aligned Tuning) را فراهم میکنند.
اگر هرگز استدلال انسان را ثبت نکرده باشید، نمیتوانید استدلال مدل داور را اصلاح کنید.
۲. مدل را بر اساس استدلال تنظیم کنید، نه صرفاً برچسبها.
ممکن است مدل داور به نتیجه درست برسد، اما دلیل اشتباهی برای آن داشته باشد.
این مسئله در داشبوردها قابل مشاهده نیست، اما میتواند بازخورد گمراهکنندهای ایجاد کند و در مواجهه با دادههای جدید نیز عملکرد مناسبی نداشته باشد.
در آزمایش حذف مولفه ما (Ablation)، چرخه مبتنی بر برچسب باعث افت کیفیت Rubric شد، درحالیکه چرخه مبتنی بر استدلال توانست عملکرد آن را پایدار نگه دارد.
۳. یک مدل داور همراستا میتواند چندین نقش داشته باشد.
استفاده مجدد از یک مدل Judge بهعنوان فیلتر و منتقد، هزینه همراستاسازی را در چند کاربرد سرشکن میکند و باعث میشود رفتار سیستم در نقشهای مختلف، یکپارچه باقی بماند.
همراستاسازی بخش پرهزینه این فرایند است، بنابراین بهتر است یک مدل داور را بهدرستی تنظیم کنید و بیش از یک بار از آن استفاده کنید.
۴. از همان روز اول برای پایش برنامهریزی کنید.
آیتمها و کاربران یک پلتفرم پیشنهاددهنده دائماً در حال تغییر هستند.
بنابراین، مدل داور مبتنی بر LLM نیز مانند هر مدل یادگیری ماشین دیگری باید بهطور مستمر تحت نظر باشد و در صورت نیاز دوباره تنظیم شود.
نباید آن را صرفاً مستقر کنیم و بعد فراموشش کنیم.
۵. دخالت انسان را از ابتدا در طراحی سیستم قرار دهید، نه اینکه آن را به یک استثنا تبدیل کنید.
خودکارسازی فرایند ارزیابی به معنای واگذاری کامل مسئولیت آن نیست.
در چرخه عمر ما، انسانها در تمام مراحل نقش مشخصی دارند:
- در مرحله اول، انسانها استانداردها و معیارهای کیفیت را تعیین میکنند.
- در مرحله دوم، دلایل و استدلالهایی را ارائه میدهند که مدل داور باید با آنها همراستا شود.
- در مرحله سوم، تصمیم محافظهکارانه حذف خروجیهای مشکوک بهجای انتشار آنها را اتخاذ میکنند.
- در مرحله چهارم، نمونهای مستمر از تصمیمهای واقعی سیستم را بررسی میکنند و پیش از انتشار هر تغییری، Rubric جدید را تایید میکنند.
اضافه کردن این نقاط کنترل پس از آنکه مدل داور بهتنهایی شروع به تصمیمگیری کرده باشد، بسیار دشوارتر خواهد بود.
بررسی مستمر انسانی همچنین مشخص میکند که Rubric چه مواردی را نادیده گرفته است، نه اینکه صرفاً چه زمانی عملکرد مدل داور افت کرده است.
در مجموع، مدل داور دامنه فعالیت و توانایی ارزیابهای انسانی را گسترش میدهد و در مقابل، همین ارزیابهای انسانی هستند که مبنای اعتماد به مدل داور را فراهم میکنند.
این رابطه متقابل است که امکان اجرای مسئولانه چنین سیستمی را در مقیاس بزرگ فراهم میکند.
یک ارزیاب خودکار که هیچکس عملکردش را ممیزی نمیکند، هیچ تضمینی درباره درستی تصمیمهایی که میگیرد ارائه نمیدهد.
دیدگاهها
ثبت دیدگاه