اگر میخواهید یادگیری ماشین را شروع کنید، در این مقاله با مسیر یادگیری، پروژههای مناسب برای تمرین و راههای پیشرفت در این حوزه آشنا میشوید.
عصر داده فرا رسیده است. اگر بهاندازه کافی برای ورود به این عصر آماده نشدهاید، نگران نباشید، هنوز هم میتوانیم به شما کمک کنیم تا وارد این مسیر شوید.
شاید در گذشته پول بود که دنیا را به حرکت درمیآورد، اما امروزه دادهها و اطلاعات از مهمترین عوامل پیشرفت هستند. استفاده از این دو مفهوم اساسی، تجزیهوتحلیل دادهها و بهکارگیری نتایج حاصل از آنها به ما کمک میکند تا اطلاعات ارزشمندی را جمعآوری و تحلیل کنیم، اطلاعاتی که میتوانند ما را یک قدم جلوتر از رقبا نگه دارند.
تحلیل داده در کسبوکار، فناوری و امور مالی ضروری است. این کار به شما کمک میکند روندهای بازار را شناسایی کنید، چه در شرکتهای بزرگ و چه در کسبوکارهای کوچک و خانوادگی!
امروزه پیشبینی میشود که بازار جهانی یادگیری ماشین بین سالهای ۲۰۱۸ تا ۲۰۲۴ با نرخ رشد مرکب سالانه (CAGR) معادل ۴۲٫۰۸ درصد رشد کند. زبانهای برنامهنویسی نیز مزایای خاص خود را دارند، زیرا به توسعهدهندگان امکان میدهند وبسایتها را مطابق با سلیقه طراحی و قابلیتهای موردنیاز خود پیادهسازی کنند. این فرایند شبیه کار هنرمندی است که روی بوم نقاشی خالی، اثری جدید خلق میکند.
در کنار تمام این حوزهها، زمینه دیگری وجود دارد که تحلیل داده در آن نقشی بسیار ارزشمند ایفا میکند: هوش مصنوعی (AI)، بهویژه یادگیری ماشین. توانایی شناسایی الگوها در مجموعهدادهها، هنگام تلاش برای پیشبینی رویدادهای آینده اهمیت زیادی پیدا میکند. این توانایی در یادگیری ماشین ضروری است، زیرا به پیشبینی نتایج احتمالی و جلوگیری از شکست یا بروز خطا کمک میکند.
این مهارتها و دانش تکمیلی مرتبط با علم داده، ابزارها و منابعی ارزشمند برای فعالیت در محیط پرشتاب و همواره در حال تحول امروزی هستند. اما پرسش اینجاست: برای یادگیری ماشین و کسب دانش بیشتر در این زمینه، از کجا باید شروع کرد؟
در این مقاله، یک نقشه راه یادگیری ماشین در اختیار شما قرار میدهیم تا بتوانید مهارتهای خود را تقویت کنید و با جنبههای مختلف این حوزه آشنا شوید.
یادگیری ماشین به زبان ساده
بهطور کلی، یادگیری ماشین زیرشاخهای از هوش مصنوعی است که برای تصمیمگیری یا پیشبینی، از الگوهای موجود در دادههای گذشته استفاده میکند. یادگیری ماشین روشی است که به کامپیوترها امکان میدهد از تجربه بیاموزند و خود را با فرایندها و نتایج تکرارشونده تطبیق دهند، بدون اینکه لازم باشد مانند الگوریتمهای سنتی، تمام دستورالعملهای مشخص از ابتدا برای آنها برنامهنویسی شوند.
به زبان ساده، یادگیری ماشین یعنی هوشمندتر کردن ماشینها از طریق توانایی یادگیری، پیشبینی و سازگاری با رفتارهای گذشته. این روش امکان دستیابی به هوش مصنوعی را بدون نیاز به تعریف تمام قوانین و فرایندها از پیش فراهم میکند.
هدف یادگیری ماشین
الگوریتمهای یادگیری ماشین از دادههای تاریخی برای پیشبینی مقادیر خروجی جدید و تصمیمگیری بر اساس اطلاعات موجود استفاده میکنند. این نوع هوش مصنوعی با شناسایی خودکار الگوهایی در سوابق و دادهها، حجم کار بسیاری از صنایع، از جمله حوزه سلامت و امور مالی، را کاهش داده است، الگوهایی که ممکن است در شرایط عادی از چشم انسان پنهان بمانند. با استفاده از یادگیری ماشین، برنامهها میتوانند بدون نیاز به برنامهنویسی صریح برای هر پیشبینی، به نتایج دقیقتری دست پیدا کنند.
یادگیری ماشین قابلیتهای زیادی دارد، اما ویژگی متمایزکننده آن توانایی پیشبینی نتایج و کمک به جلوگیری از پیامدهای نامطلوب در آینده است.
برخی از کاربردهای آن عبارتاند از پیشبینی تقاضای بازار، پیشبینی قیمت سهام و حتی برآورد احتمال بقا برای بررسی اینکه فردی در یک موقعیت مشخص تا چه اندازه شانس زنده ماندن دارد.
دنبال کردن مسیر شغلی در حوزه یادگیری ماشین
اکنون که با مفهوم یادگیری ماشین بیشتر آشنا شدهاید، بیایید کاربردهای آن و دلایل تبدیل شدنش به یک انتخاب شغلی مناسب برای بسیاری از افراد را بررسی کنیم.
تقاضا برای متخصصان و مهندسان یادگیری ماشین به بالاترین سطح خود رسیده است. مهارتهای این متخصصان میتواند به شرکتها کمک کند تا به اهداف خود دست پیدا کنند و در عین حال، کارایی و بهرهوری بیشتری داشته باشند. همچنین، یادگیری ماشین به کسبوکارها امکان میدهد تصمیمهای مبتنی بر داده بگیرند و محصولاتی بسازند که نیازها و خواستههای مشتریان را بهتر برآورده کنند.
بر اساس مطالعهای از لینکدین، تعداد مهندسان یادگیری ماشین طی پنج سال گذشته ۹٫۸ برابر شده است. طبق این گزارش، در حال حاضر حوزههای علم داده و یادگیری ماشین فرصتهای شغلی بیشتری نسبت به تعداد متقاضیان ایجاد میکنند و در نتیجه، از سریعترین حوزههای فناوری از نظر رشد فرصتهای استخدامی به شمار میروند.
در واقع، وبسایت Glassdoor در فهرست ۵۰ شغل برتر ایالات متحده در سال ۲۰۲۲، مهندسی یادگیری ماشین را نیز قرار داده است. حقوق پایه میانه برای این موقعیت شغلی ۱۳۰٬۴۸۹ دلار گزارش شده بود. اگر به یادگیری ماشین علاقهمند هستید و از آینده فناوریهای این حوزه هیجانزدهاید، شاید اکنون زمان مناسبی باشد تا یادگیری را آغاز کنید و خود را برای نوآوریها و پیشرفتهای آینده آماده سازید.
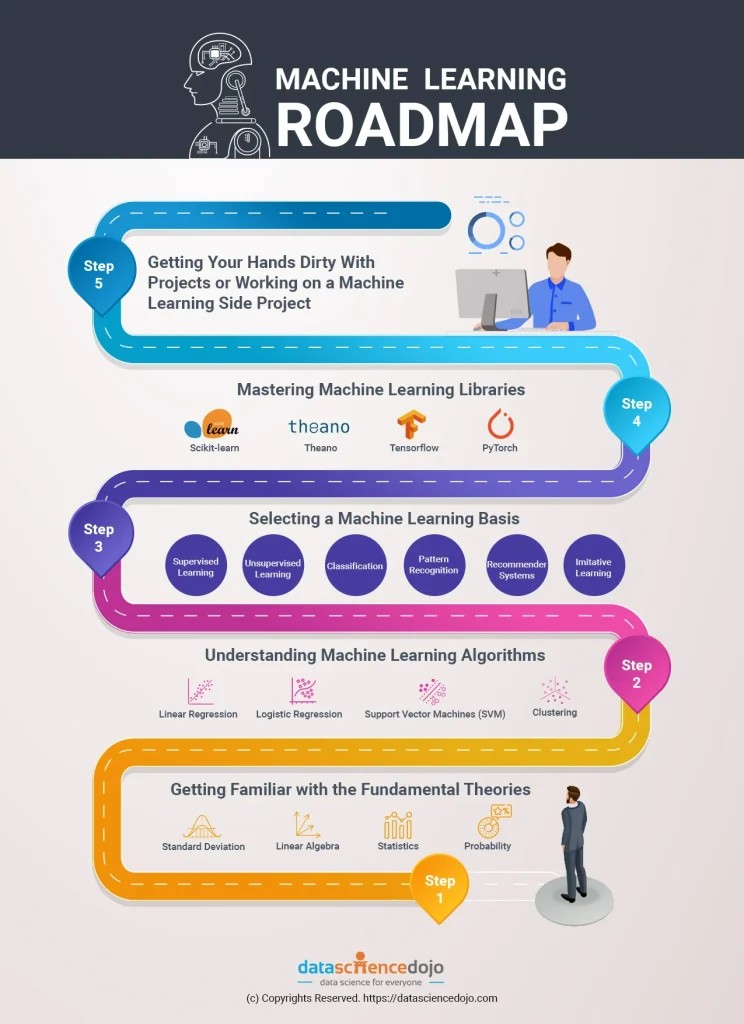
نقشه راه یادگیری ماشین
گام اول: آشنایی با نظریهها، مفاهیم و فناوریهای بنیادی
بهترین راه برای درک ماهیت یادگیری ماشین و نحوه عملکرد آن، مطالعه نظریهها، مفاهیم، روشها و الگوریتمهای زیربنایی آن است. این موارد، اجزای اصلی مدلهای یادگیری ماشین هستند که در سیستمهای مبتنی بر این فناوری به کار میروند.
بهتر است ابتدا مروری کلی بر این مفاهیم داشته باشید تا درک روشنی از مباحث ریاضی موردنیاز در دورهها و مقالات بعدی به دست آورید. برای مثال، پیش از درک نحوه عملکرد الگوریتمهای یادگیری ماشین و مسائلی که حل میکنند، باید جبر خطی، آمار و احتمال را یاد بگیرید.
همچنین میتوانید در بوتکمپ علم داده شرکت کنید تا مهارتهای خود را در زمینه یادگیری ماشین توسعه دهید.
پس از کسب درک کاربردی از این مفاهیم بنیادی، میتوانید به سراغ مدلهای یادگیری ماشین بروید که در دنیای واقعی کاربرد گستردهای دارند.
در ادامه، برخی از مبانیای را معرفی میکنیم که بهتر است پیش از شروع مسیر یادگیری ماشین مطالعه کنید:
- انحراف معیار (Standard Deviation): معیاری آماری برای اندازهگیری میزان تغییرپذیری یا پراکندگی دادهها نسبت به میانگین آنها.
- جبر خطی (Linear Algebra): شاخهای از ریاضیات که به مطالعه فضاهای برداری و نگاشتهای خطی میان این فضاها میپردازد.
- آمار (Statistics): حوزهای از دانش که جمعآوری، تحلیل، تفسیر و ارائه دادهها را بررسی میکند.
- احتمال (Probability): شاخهای از ریاضیات که به تحلیل پدیدههای تصادفی میپردازد و در آمار کاربرد گستردهای دارد.
گام دوم: درک الگوریتمهای یادگیری ماشین
در یادگیری ماشین، الگوریتمها مجموعه دستورالعملهایی هستند که نحوه انجام کار را برای کامپیوتر مشخص میکنند. در برخی موارد، این دستورالعملها میتوانند به سادگی «اگر X درست بود، آنگاه Y را انجام بده» باشند. در موارد پیچیدهتر، ممکن است شامل شرطها و حلقههای تکرار باشند.
بسیاری از الگوریتمهای یادگیری ماشین با پردازش نقاط داده کار میکنند. هر نقطه داده میتواند خروجی مشخصی داشته باشد، برای مثال، یک ایمیل بهعنوان هرزنامه یا ایمیل عادی طبقهبندی شود. این الگوریتمها همچنین از مدلهای ریاضی برای پیشبینی خروجیهای آینده استفاده میکنند.
برای آشنایی بیشتر، در ادامه فهرستی از فرایندها و الگوریتمهای پرکاربردی را میبینید که معمولا هنگام یادگیری ماشین آموزش داده میشوند:
- رگرسیون خطی (Linear Regression): روشی برای مدلسازی رابطه میان متغیرهاست. در این روش، یک مدل خطی با استفاده از دادههای موجود تنظیم میشود تا بتواند مقادیر جدید را پیشبینی کند.
- رگرسیون لجستیک (Logistic Regression): نوعی الگوریتم طبقهبندی احتمالاتی است که با استفاده از ویژگیهای مشاهدات جدید، احتمال تعلق آنها به کلاسهای مختلف را محاسبه میکند و بر اساس این احتمالها تصمیم میگیرد.
- ماشین بردار پشتیبان (Support Vector Machine یا SVM): روشی برای حل مسائل یادگیری نظارتشده است که میتواند با ورودیهای عددی یا دستهای و خروجیهای گسسته کار کند. بردارهای پشتیبان، نمونههای آموزشیای هستند که به مرز تصمیم مدل نزدیکاند.
- خوشهبندی (Clustering): تکنیکی برای شناسایی زیرگروهها در دادههاست. ایده اصلی این است که مجموعهای از نقاط داده را بررسی کنیم و بر اساس میزان شباهت یا نزدیکی آنها، نقاط متعلق به گروههای مختلف را شناسایی کنیم.
گام سوم: انتخاب حوزه یادگیری ماشین موردنظر
همزمان با آشنایی بیشتر با مفاهیم و نظریهها، زمان مناسبی است تا حوزهای از یادگیری ماشین را که میخواهید روی آن تمرکز کنید، انتخاب کنید.
برای شروع، میتوانید با موضوعات گسترده زیر آشنا شوید:
- یادگیری نظارتشده (Supervised Learning): نوعی یادگیری ماشین که در آن مجموعهای از دادههای آموزشی در اختیار کامپیوتر قرار میگیرد و مدل باید یاد بگیرد چگونه ورودیها را به خروجیهای موردنظر نگاشت کند.
- یادگیری بدون نظارت (Unsupervised Learning): نوعی یادگیری ماشین که در آن دادهها در اختیار کامپیوتر قرار میگیرند، اما خروجی صحیح از پیش مشخص نشده است. هدف، شناسایی ساختارها و الگوهای موجود در دادهها و یادگیری از آنهاست.
- طبقهبندی (Classification): فرایند تعیین دستهای است که یک نمونه بر اساس مثالهای برچسبگذاریشده به آن تعلق دارد. برای مثال، تشخیص هرزنامه از ایمیل عادی یا تشخیص تومور بدخیم از تومور خوشخیم.
- تشخیص الگو (Pattern Recognition): وظیفه شناسایی الگوها در دادههاست. این دادهها میتوانند شامل متغیرهای ورودی، مانند پیکسلهای یک تصویر، و متغیرهای هدف، مانند بدخیم یا خوشخیم بودن یک تومور، باشند.
- سیستمهای توصیهگر (Recommender Systems): برنامههایی هستند که بر اساس ترجیحات و رفتارهای قبلی کاربران، مواردی را که احتمالا به آنها علاقه دارند پیشبینی میکنند. این سیستمها در پلتفرمهایی مانند نتفلیکس، موتورهای جستوجویی مانند گوگل و بینگ و شبکههای اجتماعی برای پیشنهاد محتوا، محصولات یا حتی دوستان جدید کاربرد دارند.
- یادگیری تقلیدی (Imitative Learning): روشی برای یادگیری از طریق مشاهده و الگوبرداری از عملکرد یک فرد متخصص است. در این روش، سیستم با مشاهده رفتار فرد متخصص، یاد میگیرد چگونه وظایف را انجام دهد، بدون اینکه لزوما دستورالعمل مستقیمی برای حل هر مسئله دریافت کند.
گام چهارم: تسلط بر کتابخانههای یادگیری ماشین
کتابخانههای یادگیری ماشین از اجزای اصلی توسعه برنامههای مبتنی بر این فناوری هستند. کتابخانهها مجموعههایی از توابع و ابزارهای ازپیشپیادهسازیشدهاند که با فراهم کردن قابلیتهای آماده، فرایند توسعه برنامههای یادگیری ماشین را سادهتر میکنند.
- Scikit-learn: کتابخانهای متنباز برای یادگیری ماشین در زبان پایتون است که از ابزارهای علمی پایتون، از جمله NumPy و SciPy، بهره میبرد.
- Theano: کتابخانهای برای پایتون است که امکان تعریف، بهینهسازی و ارزیابی کارآمد عبارتهای ریاضی شامل آرایههای چندبعدی را فراهم میکند.
- TensorFlow: کتابخانهای متنباز برای محاسبات عددی است که از گرافهای جریان داده استفاده میکند. گرههای این گراف نشاندهنده عملیات ریاضی هستند و یالها، آرایههای چندبعدی داده یا همان تنسورها را نمایش میدهند که میان گرهها جابهجا میشوند.
- PyTorch: بستهای برای پایتون است که دو قابلیت اصلی ارائه میدهد: انجام محاسبات تنسوری، مشابه NumPy، با شتابدهی قدرتمند GPU و توسعه شبکههای عصبی عمیق با استفاده از سامانه خودکار مشتقگیری مبتنی بر گراف محاسباتی.
گام پنجم: کسب تجربه عملی با پروژهها یا توسعه یک پروژه جانبی در یادگیری ماشین
هنگام کار با الگوریتمهای یادگیری ماشین، فراموش نکنید که مهارتهای خود را با حل مسائل دنیای واقعی به کار بگیرید. برای این کار، روشهای مختلفی وجود دارد:
- همکاری با یک استارتاپ یا شرکت کوچک: به سازمانهایی بپیوندید که به راهکارهای مبتنی بر داده نیاز دارند و میتوانید در حل مسائل واقعی آنها مشارکت کنید.
- ساخت نمونهکار در حوزه علم داده: مجموعهای از پروژههای خود را آماده کنید تا مهارتهایتان را به کارفرمایان نشان دهید. اگر نمیدانید از کجا شروع کنید، عبارت «رزومه دانشمند داده» (Data Scientist Resume) را جستوجو کنید و نمونه رزومهها را بررسی کنید. همچنین میتوانید از انجمنهایی مانند Reddit یا Analytics Stack Exchange کمک بگیرید.
- شرکت در چالشهای یادگیری ماشین: وبسایتهایی مانند DataKind پروژههای مرتبط با یادگیری ماشین دارند که برای پیشبرد آنها به مشارکت داوطلبان نیاز است.
جمعبندی
حوزه یادگیری ماشین بسیار گسترده است و موضوعات زیادی برای یادگیری دارد. بنابراین، بهترین راه برای شروع این مسیر آن است که ابتدا هدف نهایی خود را مشخص کنید، برای مثال، «میخواهم از دادههای کسبوکارم برای تصمیمگیری هوشمندانهتر استفاده کنم» یا «به یک سیستم توصیهگر برای وبسایتم نیاز دارم».
پس از تعیین اهداف، مقالات مرتبط با موضوع موردنظر را مطالعه کنید تا با مسائل و چالشهای پیش رو آشنا شوید. سپس یادگیری اجزای مختلف را بهتدریج آغاز کنید تا درک خوبی از نحوه ارتباط این اجزا با یکدیگر به دست آورید.
در نهایت، آموختههای خود را در عمل به کار بگیرید، چه با مشارکت در پروژههای ازپیشتعریفشده و چه با ساخت پروژهای مستقل که بتوانید در مصاحبه شغلی بعدی خود در حوزه علم داده ارائه کنید.
دیدگاهها
ثبت دیدگاه