از لحظه کلیک تا نمایش صفحه، بهعلاوه کمی دانش پیشرفتهتر که در ادامه به آن نیاز پیدا میکنید.
وقتی تازه کارم را بهعنوان توسعهدهنده شروع کرده بودم، میتوانستم فیچر بسازم، اما درک درستی از کل سیستم نداشتم. میدانستم کدم «روی یک سرور» اجرا میشود، درست مثل اینکه میدانستم غذایم «از یک مزرعه» میآید. روزی که بالاخره کسی تمام تصویر را برایم توضیح داد، از تکتک اجزا گرفته تا فلشهایی که آنها را به هم وصل میکنند، همان روزی بود که کار Backend دیگر برایم شبیه مجموعهای از دانستههای اسرارآمیز نبود و شکل واقعی مهندسی به خودش گرفت.
این مقاله همان توضیح مرحلهبهمرحله است. ایده اولیه آن از مقاله معماری وب 101 نوشته Jonathan Fulton در سال ۲۰۱۷ گرفته شده است، مقالهای که آنقدر محبوب شد که خوانندگان نمودارش را چاپ میکردند و به دیوار اتاقشان میزدند. اما ۹ سال در دنیای زیرساخت، بهاندازه چندین عمر تغییر و تحول به همراه دارد و بخش نظرات آن مقاله...
برای اینکه بحث ملموس باقی بماند، یک درخواست را در یک اپلیکیشن فرضی دنبال میکنیم که نامش را Platefull میگذارم، یک پلتفرم دستور پخت غذا که در آن آشپزهای خانگی عکس آپلود میکنند، ایدههایی برای شام پیدا میکنند و برای استفاده از قابلیت برنامهریزی حرفهای وعدههای غذایی، اشتراک میخرند. این اپلیکیشن خیالی است، اما تقریبا تمام اجزای آن را در شرکتهای واقعی پیدا خواهید کرد.
یک کلیک، چهارده سیستم
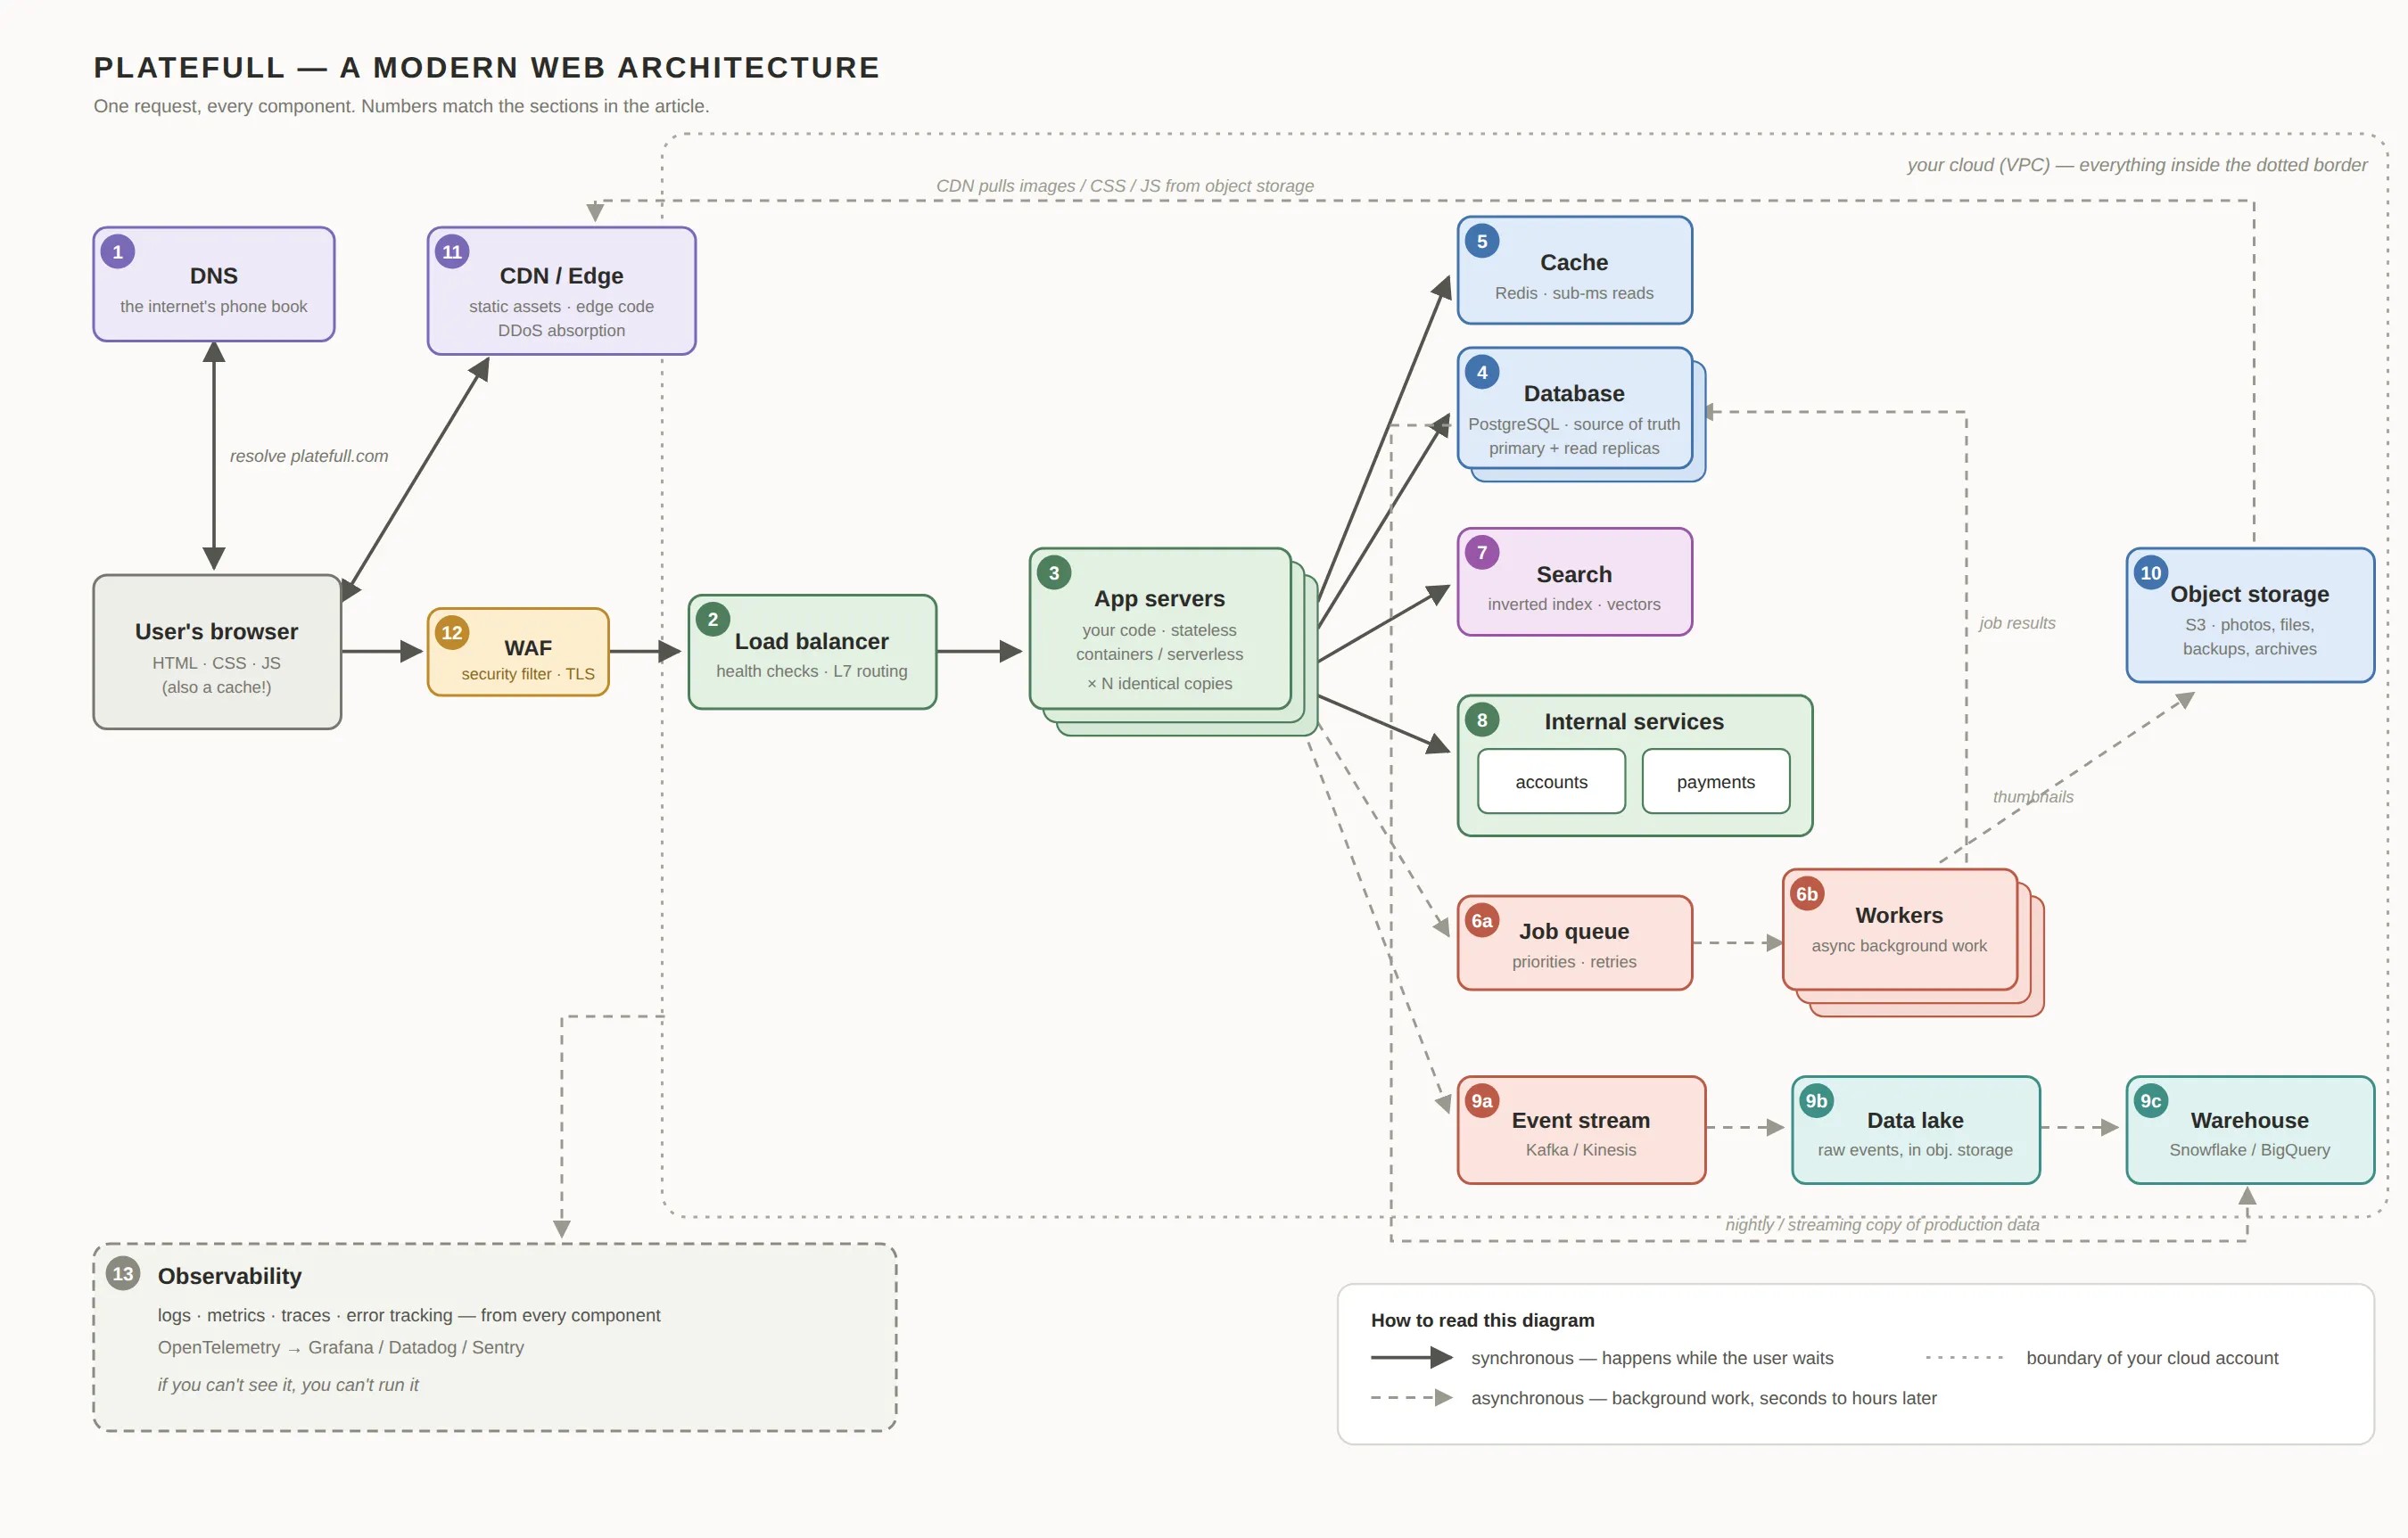
کاربری عبارت «توفوی ترد که از هم نپاشد» را در گوگل جستوجو میکند، روی یکی از نتایج Platefull کلیک میکند و در کمتر از یک ثانیه، اتفاقات زیر رخ میدهند:
مرورگر او از DNS میخواهد دامنه platefull.com را به یک IP Address تبدیل کند. درخواست از طریق TLS عبور میکند، همان ارتباط امنی که علامت قفل کنار نوار آدرس نشان میدهد. اما درخواست مستقیما به سرورهای ما نمیرسد، بلکه ابتدا به نزدیکترین نقطه حضور CDN میرسد، جایی که تصاویر، CSS و JavaScript ذخیرهشده را از یک دیتاسنتر در فاصله ۳۰ کیلومتری کاربر ارائه میکند. درخواست مربوط به خود صفحه از Firewall و WAF عبور میکند و به لودبالانسر میرسد. لود بالانسر یکی از دوازده سرور اپلیکیشن یکسان را برای پردازش درخواست انتخاب میکند.
سرور به اطلاعات دستور پخت نیاز دارد. ابتدا کش را بررسی میکند. این دستور پخت توفو محبوب است و اطلاعات آن در کش وجود دارد، بنابراین در کمتر از یک میلیثانیه بازیابی میشود و نیازی به اجرای کوئری روی دیتابیس نیست. صفحه همچنین بخش «دستورهای پخت مشابه» را نمایش میدهد که اطلاعاتش از Search Service و Inverted Index آن میآید. از آنجا که کاربر اشتراک حرفهای دارد، اپلیکیشن از Accounts Service میخواهد اعتبار اشتراک او را بررسی کند. پرداخت اشتراک از طریق Payment Service انجام شده که با Stripe ارتباط دارد، در نتیجه، ما هرگز مستقیما با شماره کارت بانکی سروکار نداریم.
یک اتفاق دیگر هم رخ میدهد: عکس آپلودشده توسط کاربر در روز گذشته آنقدر بزرگ بوده که پردازش آن در مدت انتظار کاربر منطقی نبوده است. بنابراین اپلیکیشن یک Job با عنوان «تغییر اندازه و تولید Thumbnail» به Job Queue اضافه کرده است. یک Worker در طول شب این Job را دریافت کرده، Thumbnailها را در Object Storage ذخیره کرده و حالا CDN آنها را در سراسر جهان ارائه میکند.
در نهایت، سرور یک Event با نام recipe_viewed به Event Pipeline ارسال میکند. این Event وارد Data Lake میشود و سپس به Data Warehouse منتقل خواهد شد، جایی که یک تحلیلگر در آینده متوجه میشود جستوجوی دستورهای پخت توفو در هر ماه ژانویه افزایش چشمگیری دارد.
در تمام این مدت، هر کامپوننت Logها، Metricها و Traceهای خود را به Observability Stack ارسال میکند، چون وقتی چیزی از کار میافتد، باید مشخص شود کدامیک از این اجزا مسئول مشکل است.
این هم از تور کوتاه ما. حالا بیایید هر کامپوننت را دقیقتر بررسی کنیم.
چطور نمودار را بخوانیم؟
فلشهای پیوسته مسیر Synchronous Request را نشان میدهند، یعنی اتفاقاتی که هنگام انتظار کاربر رخ میدهند. فلشهای خطچین نشاندهنده عملیات Asynchronous هستند، کارهایی که در پسزمینه انجام میشوند. مرز نقطهچین نیز مشخص میکند کدام بخش روی زیرساخت خودمان اجرا میشود و کدام بخش را بهصورت Managed Service اجاره میکنیم.
این یکی از پرتکرارترین پرسشها در بخش نظرات مقاله اصلی بود، بنابراین از همین ابتدا به آن پاسخ دادیم.
۱. DNS: دفترچه تلفن اینترنت
DNS یا Domain Name System، یک دامنه قابلفهم برای انسان، مانند platefull.com، را به یک IP Address قابلاستفاده برای ماشین، مانند 203.0.113.42، تبدیل میکند. DNS یک Key-Value Store جهانی و سلسلهمراتبی است و تقریبا در ابتدای هر درخواست اینترنتی قرار دارد.
تشبیه کلاسیک همچنان درست است: نام دامنه مثل «با مجتبی تماس بگیر» است، IP Address مثل «با شماره +48 123 456 789 تماس بگیر» و DNS همان دفترچه تلفن است. مرورگر، سیستمعامل و Resolverهایی که در مسیر قرار دارند، نتیجه این جستوجوها را مطابق TTL یا Time to Live که پیکربندی کردهاید، کش میکنند.
کمی عمیقتر
DNS صرفا یک ابزار برای پیدا کردن IP Address نیست، بلکه اولین ابزار شما برای Load Balancing و Failover هم محسوب میشود. سرویسدهندگانی مانند Route 53 یا Cloudflare میتوانند بر اساس موقعیت جغرافیایی کاربر، IPهای متفاوتی برگردانند یا Endpointهای شما را با Health Check بررسی کنند و در صورت از دسترس خارج شدن یک Region، ظرف چند ثانیه آن را از نتایج DNS حذف کنند.
وقتی مهندسان میگویند «Failover به eu-west انجام دادیم»، اغلب DNS یکی از سازوکارهای اصلی این جابهجایی است.
البته DNS میتواند یک Single Point of Failure بسیار جدی هم باشد. چند مورد از مشهورترین قطعیهای اینترنت به اختلالات DNS مربوط بودهاند. به همین دلیل، قدیمیترین شوخی دنیای Operations در قالب یک Haiku بیان میشود:
۲. لودبالانسر: سرورهای متعدد، یک ورودی واحد
برای درک نقش لودبالانسر، ابتدا باید تفاوت Vertical Scaling و Horizontal Scaling را بدانید.
- Vertical Scaling: خرید یک ماشین قدرتمندتر.
- Horizontal Scaling: اضافه کردن ماشینهای بیشتر.
معماری مدرن وب عمدتا بر Horizontal Scaling متکی است، بخشی به این دلیل که قدرت یک ماشین محدودیت دارد، اما دلیل مهمتر این است که تجهیزات و زیرساختها خراب میشوند. سرورها از کار میافتند، شبکهها دچار اختلال میشوند و گاهی یک دیتاسنتر کامل از دسترس خارج میشود. با یک سرور، چنین اتفاقی به قطعی سرویس منجر میشود، اما با دوازده سرور پشت یک لودبالانسر، ممکن است فقط یکی از روزهای معمول کاری باشد!
لودبالانسر امکان استفاده موثر از Horizontal Scaling را فراهم میکند. درخواستهای ورودی را دریافت میکند، آنها را بین مجموعهای از سرور اپلیکیشنهای یکسان توزیع میکند، سلامت هر سرور را میسنجد و درخواستها را از سرورهای ناسالم دور نگه میدارد.
کمی عمیقتر
یکی از پرسشهای رایج این است: «اگر خود لودبالانسر از کار بیفتد چه میشود؟» سوال منطقیای است، آیا فقط Single Point of Failure را به جای دیگری منتقل نکردهایم؟
در عمل، لودبالانسرها معمولا بهصورت زوجهای افزونه اجرا میشوند که سلامت یکدیگر را بررسی میکنند و در صورت نیاز، ظرف چند ثانیه کنترل یک IP مشترک را به دست میگیرند. سرویسهای ابری مانند AWS ALB و Google Cloud Load Balancing نیز خودشان سیستمهای توزیعشدهای هستند که چند Availability Zone را پوشش میدهند.
نکته مهم دیگر، تفاوت لودبالانسرهای لایه ۴ و لایه ۷ است:
- لودبالانسر L4: بر اساس IP و Port مسیریابی میکند و سرعت بسیار بالایی دارد.
- لودبالانسر L7: پروتکل HTTP را درک میکند و میتواند بر اساس Path مسیریابی کند، مثلا درخواستهای
/apiرا به یک مجموعه سرور و سایر درخواستها را به مجموعهای دیگر بفرستد. همچنین میتواند TLS را Terminate کند و درخواستهای ناموفق را دوباره امتحان کند.
بخش عمده لودبالانسرهایی که در کار روزمره با آنها سروکار خواهید داشت، از نوع L7 هستند.
۳. سرور اپلیکیشنها: جایی که کد شما واقعا اجرا میشود
این همان لایهای است که توسعهدهندگان بیشترین آشنایی را با آن دارند، چون کد خودشان در این بخش اجرا میشود. سرور اپلیکیشنها فرآیندهایی هستند که درخواست را دریافت میکنند، بیزنس لاجیک را اجرا میکنند و در نهایت HTML یا JSON برمیگردانند. سایر اجزای این مقاله برای پشتیبانی از همین لایه وجود دارند.
میتوانید این بخش را با زبان و Framework دلخواهتان بسازید، برای مثال:
- Node.js / Express
- Python / Django یا FastAPI
- Ruby on Rails
- PHP / Laravel
- Java / Spring
- Go
اگر قبلا اصطلاح MVC Framework را شنیدهاید و بدون اینکه دقیقا بدانید یعنی چه، با آن موافقت کردهاید، منظور فریمورکی است که کد را به سه بخش تقسیم میکند: Model برای دادهها، View برای نمایش و Controller برای منطق پردازش درخواست. بیشتر فریمورکهای کلاسیک از یکی از شکلهای این الگو استفاده میکنند.
قانون طلایی این لایه آن است که سرورها باید Stateless باشند، یعنی اطلاعات Session کاربران یا فایلهای آپلودشده نباید فقط روی خود ماشین نگهداری شوند. تمام State باید در دیتابیس، کش و Object Storage قرار بگیرد.
چرا؟ چون سرورهای Stateless قابلجایگزینی هستند. لودبالانسر میتواند هر درخواست را به هر سروری ارسال کند، Auto Scaling میتواند آزادانه سرورها را اضافه یا حذف کند و خرابی یک سرور باعث از دست رفتن اطلاعاتی نمیشود که فقط روی آن قرار داشتهاند.
کمی عمیقتر
بزرگترین تغییر از سال ۲۰۱۷ تاکنون، شیوه بستهبندی و اجرای کد بوده است. امروزه کد شما تقریبا بهطور قطع در قالب یک کانتینر، معمولا با داکر، منتشر میشود. در مقیاس بزرگ، کانتینرها توسط یک Orchestrator زمانبندی و مدیریت میشوند، معمولا کوبرنتیز یا یک لایه مدیریتشده روی آن، مانند ECS، Cloud Run یا Fly.io.
داکر از یک فناوری نسبتا تازه به ابزاری با میزان پذیرش بیش از ۷۰ درصد در میان توسعهدهندگان تبدیل شده است.
Serverless، مانند Lambda و Cloudflare Workers، یک قدم جلوتر میرود: دیگر نیازی نیست سرورها را خودتان مدیریت کنید و هزینه را بر اساس درخواست پرداخت میکنید. این مدل برای بارهای کاری متغیر و وظایف کوچک بسیار مناسب است، اما برای اتصالهای طولانیمدت و پیشبینی هزینه در بار کاری بالا و ثابت، میتواند پیچیدهتر باشد.
۴. دیتابیسها: منبع اصلی حقیقت
هر اپلیکیشن جدی حداقل یک دیتابیس دارد، کامپوننتی که دادهها را بهصورت پایدار ذخیره میکند، ساختار آنها را کنترل میکند و به کوئریها پاسخ میدهد.
دیتابیس عنوان مهمی دارد: Single Source of Truth یا منبع اصلی حقیقت.
ممکن است دادههای کش قدیمی باشند، Search Index با تاخیر بهروزرسانی شود یا نسخههای تحلیلی دادهها با اطلاعات فعلی تفاوت پیدا کنند. این موارد، اگر مطابق طراحی سیستم رخ دهند، لزوما مشکلی ایجاد نمیکنند، به شرط آنکه همه بپذیرند دیتابیس مرجع اصلی است و سایر نسخهها از آن مشتق میشوند.
معماری زمانی از هم میپاشد که دو سیستم همزمان تصور کنند مرجع اصلی دادهها هستند.
تقسیمبندی اصلی در این حوزه، SQL در مقابل NoSQL است.
دیتابیسهای رابطهای مبتنی بر SQL، مانند PostgreSQL و MySQL، دادهها را در جدولهایی ذخیره میکنند که از طریق Keyها به هم مرتبطاند. این دیتابیسها Schema مشخصی دارند و قابلیتهایی مانند ترنزکشن و Join را ارائه میکنند.
NoSQL عنوانی کلی برای انواع دیگر دیتابیسهاست، از جمله:
- Document Store: مانند MongoDB
- Wide-Column Store: مانند Cassandra
- Key-Value Store: مانند DynamoDB
NoSQL مخفف عبارت «Not Only SQL» است. جالب اینکه صنعت نرمافزار تا حد زیادی دوباره به سمت SQL بهعنوان زبان کوئری بازگشته است، حتی در برخی Engineهای غیررابطهای.
SQL را یاد بگیرید. راه میانبری برای دور زدن آن وجود ندارد.
پیشنهاد پیشفرض در سال ۲۰۲۶، سادهتر از چیزی است که موج تبلیغاتی سال ۲۰۱۷ القا میکرد: با PostgreSQL شروع کنید. PostgreSQL یکی از محبوبترین دیتابیسها در میان توسعهدهندگان است و در نظرسنجی Stack Overflow بیش از ۵۵ درصد سهم داشته است. این دیتابیس از JSON Documentها، Full-text Search و حتی Vector Embeddingها بهاندازهای خوب پشتیبانی میکند که بسیاری از تیمها هیچوقت به Engine دومی نیاز پیدا نمیکنند.
کمی عمیقتر
اولین اقدام برای افزایش مقیاس دیتابیس معمولا استفاده از Read Replica است، نسخههایی از دیتابیس که کوئریهای خواندن را پاسخ میدهند، در حالی که سرور اصلی مسئول نوشتن باقی میماند.
این کار Replication Lag را به همراه دارد و شما را با مفهوم Eventual Consistency آشنا میکند. فرض کنید کاربری نام پروفایل خود را تغییر میدهد، اما درخواست خواندن به Replicaای میرسد که ۲۰۰ میلیثانیه از سرور اصلی عقب است. در نتیجه، نام قدیمی برای لحظهای دوباره نمایش داده میشود.
بخش شگفتآوری از معماری دیتابیس به مدیریت همین تناقضهای کوچک اختصاص دارد.
۵. کشینگ: هنر دوباره انجام ندادن یک کار
کش یک Key-Value Store، مانند ردیس، است که نتیجه عملیات پرهزینه را نگه میدارد تا بتوان آن را در زمانی کمتر از یک میلیثانیه بازیابی کرد، بهجای اینکه هر بار عملیات را از ابتدا انجام دهیم.
در Platefull، صفحههای آماده دستور پخت، نتایج جستوجوهای پرتکرار و اطلاعات سشن در کش قرار میگیرند. گوگل هر بار که کسی عبارت «سگ» را جستوجو میکند، کل وب را از نو رتبهبندی نمیکند، چیزی که میبینید تا حدی حاصل کش است.
کشینگ به همین یک کامپوننت محدود نمیشود. مرورگر کش خودش را دارد، CDN اطلاعات را کش میکند، اپلیکیشن کش دارد و خود دیتابیس نیز از کشهای داخلی استفاده میکند.
یک سیستم خوب طوری طراحی میشود که بیشتر درخواستها بدون مراجعه مستقیم به منبع اصلی داده پاسخ داده شوند.
کمی عمیقتر
کشینگ بهعنوان یکی از دو مسئله دشوار علوم کامپیوتر شناخته میشود. بخش سخت ماجرا Cache Invalidation است، یعنی تشخیص اینکه چه زمانی نسخه ذخیرهشده دیگر معتبر نیست.
دو روش اصلی وجود دارد:
- انقضا بر اساس TTL: داده پس از مدت مشخصی منقضی میشود. ساده است، اما در فاصله زمانی موردنظر ممکن است داده قدیمی ارائه شود.
- حذف صریح کش: هر بار که داده اصلی تغییر میکند، Cache Key مربوط به آن حذف میشود. این روش میتواند داده تازهتری ارائه کند، اما فراموش کردن حتی یک مسیر بهروزرسانی آسان است.
همچنین مراقب Cache Stampede باشید. این اتفاق زمانی رخ میدهد که یک Cache Key محبوب منقضی شود و هزار درخواست همزمان کش را از دست بدهند و برای محاسبه مجدد همان مقدار به کش مراجعه کنند.
سیستمهای بالغ از Lock یا Background Refresh استفاده میکنند تا فقط یک درخواست مسئول محاسبه مجدد باشد.
کشها در ازدحام از کار میافتند، نه در تنهایی!
۶. پردازش Asynchronous: صفها، Workerها و Eventها
برخی عملیات نباید هنگام انتظار کاربر اجرا شوند. وقتی یک آشپز در Platefull عکسی ۱۲ مگابایتی آپلود میکند، تصویر را در همان ریکوئست پردازش نمیکنیم. ابتدا درخواست را سریع تایید میکنیم و سپس یک Job به Queue میفرستیم.
مجموعهای از Workerها، Jobها را از صف دریافت میکنند و عملیات زمانبر را در پسزمینه انجام میدهند.
از آنجا که خوانندگان مقاله اصلی مثالهای عملی میخواستند، اینها نمونههایی از کارهایی هستند که در سیستمهای واقعی به Queue سپرده میشوند:
- تبدیل و پردازش تصویر و ویدئو (Transcoding)
- ارسال ایمیل و Push Notification
- تولید PDF و گزارش
- همگامسازی داده با APIهای شخص ثالث
- محاسبه مجدد مدلهای پیشنهاددهنده
- وظایف پاکسازی شبانه
بیشتر Queueها از اولویت (Priority) پشتیبانی میکنند. برای مثال، ایمیل بازیابی رمز عبور میتواند زودتر از محاسبه مجدد دادههای تحلیلی پردازش شود، چون در حالت اول یک کاربر منتظر است، اما در حالت دوم چنین انتظاری وجود ندارد.
کمی عمیقتر
احتمالا اصطلاح Queue را برای دو ابزار مرتبط اما متفاوت شنیدهاید، تفاوتی که در ابتدا بسیاری را سردرگم میکند.
Job Queue، مانند Sidekiq، Celery، BullMQ و SQS، شبیه یک فهرست کارهاست. هر Job قرار است توسط یک Worker اجرا شود و سپس از صف حذف شود.
در مقابل، Event Stream، مانند Kafka و Kinesis، بیشتر شبیه یک Log پایدار از اتفاقات رخداده است، مثلا photo_uploaded یا payment_completed. چند Consumer مستقل میتوانند این رویدادها را با سرعت دلخواه خود بخوانند و حتی رویدادهای گذشته را دوباره پردازش کنند.
قاعده کلی این است:
- برای انجام دادن یک کار از Job Queue استفاده کنید.
- برای اعلام اینکه اتفاقی رخ داده و اجازه دادن به سیستمهای مختلف برای واکنش به آن، از Event Stream استفاده کنید.
این الگو، یعنی ارتباط سرویسها از طریق Event بهجای فراخوانی مستقیم، ستون اصلی چیزی است که Event-driven Architecture نامیده میشود.
۷. Full-text Search: پیدا کردن سریع سوزن در انبار کاه
وقتی عبارت «توفوی ترد» را در Platefull جستوجو میکنید، قرار نیست چنین کوئریای اجرا شود:
SELECT * FROM recipes WHERE title LIKE '%tofu%';این روش تمام ردیفها را بررسی میکند و امکان رتبهبندی نتایج را نیز فراهم نمیکند.
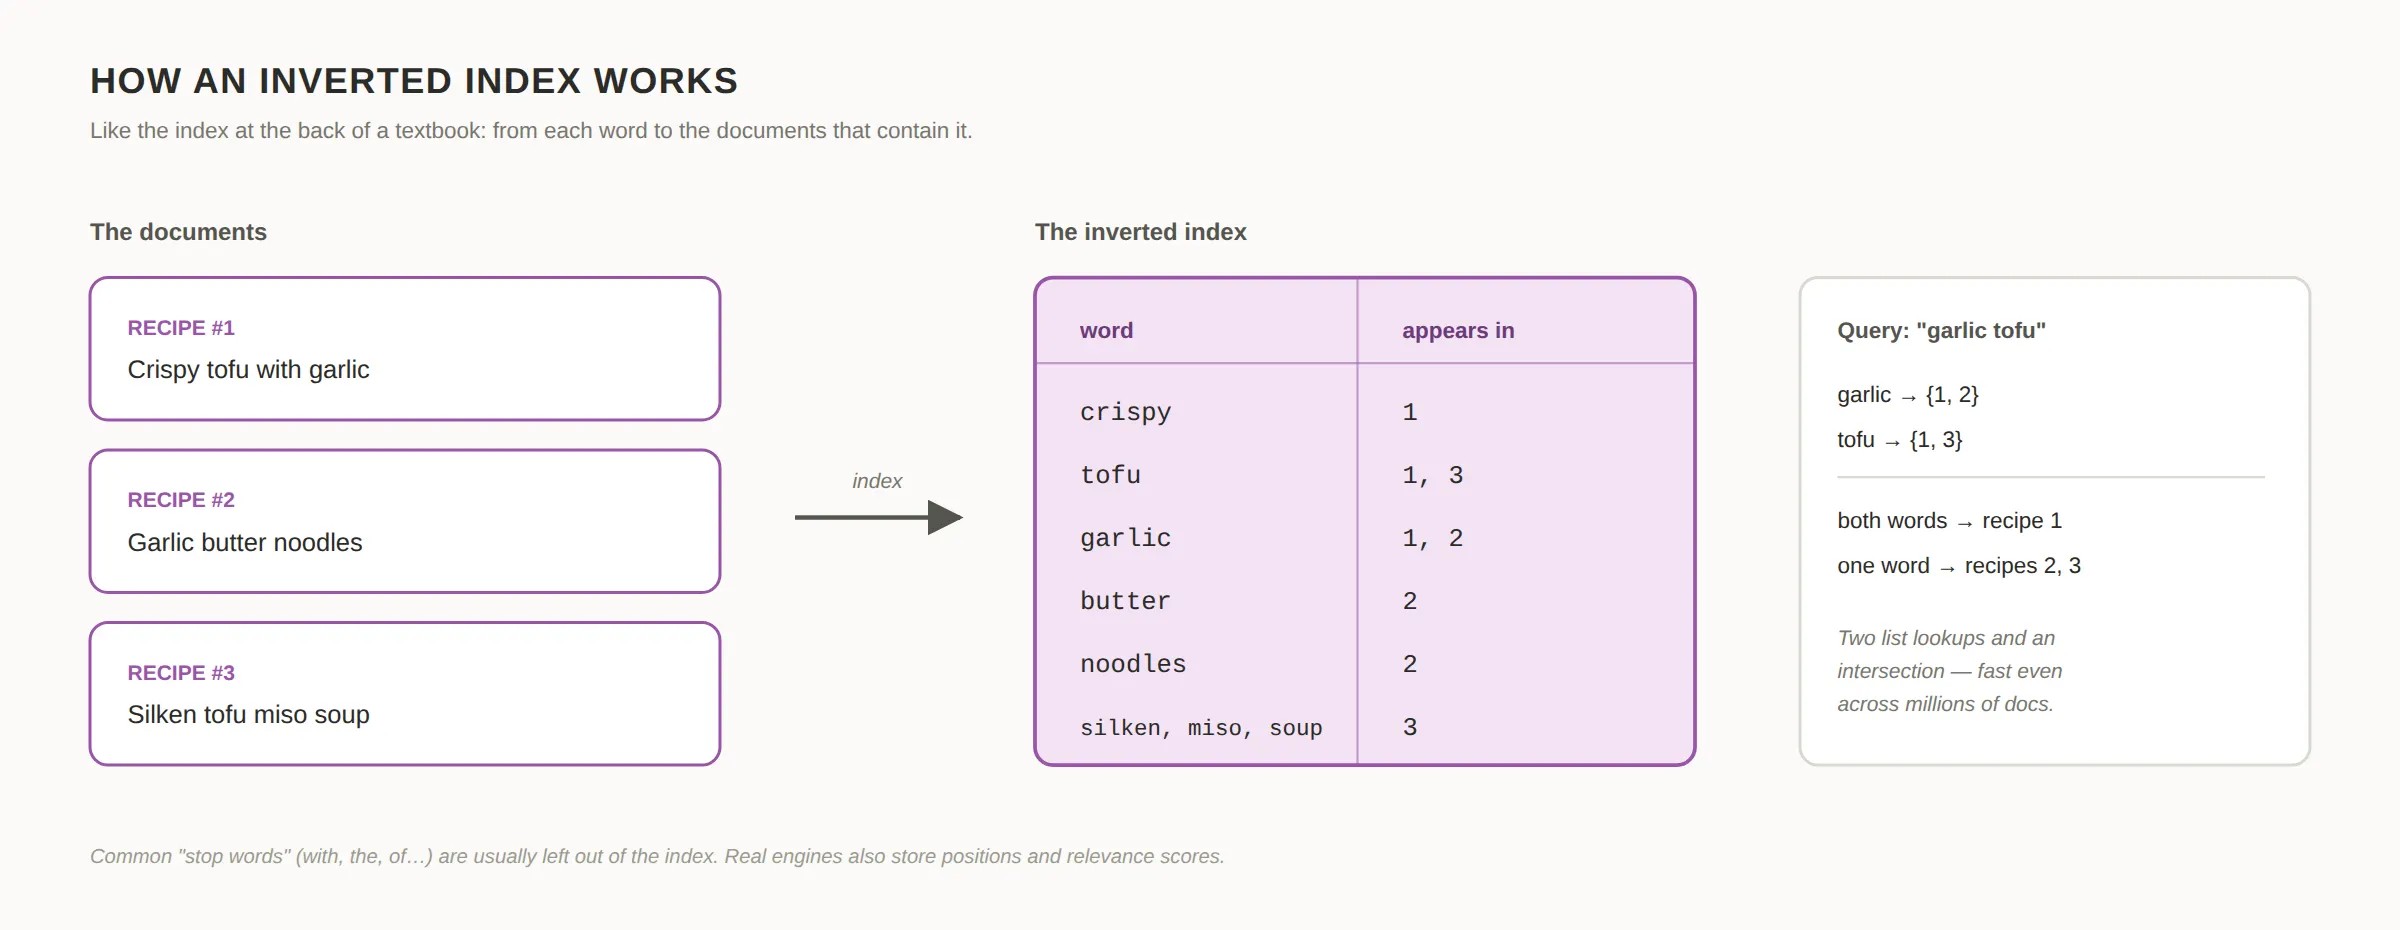
Search Serviceها با استفاده از Inverted Index این مشکل را حل میکنند. Inverted Index نگاشتی از هر کلمه به فهرست اسنادی است که آن کلمه در آنها وجود دارد، درست شبیه فهرست انتهایی یک کتاب.
پیدا کردن دو کلمه و اشتراک گرفتن از فهرستهای مربوط به آنها، حتی در میان میلیونها سند، سریع است. سپس الگوریتمهای امتیازدهی، نتایج را بر اساس میزان ارتباط رتبهبندی میکنند.
ابزارهای رایج در این حوزه عبارتاند از Elasticsearch و انشعاب متنباز آن، OpenSearch. ابزارهای سبکتری مانند Meilisearch، Typesense و Algolia نیز برای جستوجوی محصولات محبوبتر شدهاند.
کمی عمیقتر
شاید از همان روز اول به Search Service جداگانه نیاز نداشته باشید. قابلیت Full-text Search داخلی PostgreSQL برای محصولات کوچک و متوسط، فراتر از انتظار عمل میکند و معماری را سادهتر نگه میدارد، چون مجبور نیستید نسخه دومی از دادهها را مدیریت کنید.
تحول جدیدتر، Semantic Search یا جستوجوی مبتنی بر Vector است. در این روش، بهجای تطبیق مستقیم کلمات کلیدی، اسناد به Vector تبدیل میشوند و جستوجو بر اساس معنا انجام میگیرد.
به این ترتیب، جستوجوی «شام با پروتئین گیاهی» میتواند دستور پخت توفو را پیدا کند، حتی اگر هیچ کلمه مشترکی با آن نداشته باشد.
محصولات مدرن بهطور فزاینده از ترکیب امتیازهای جستوجوی کلمهمحور و Vector در قالب Hybrid Ranking استفاده میکنند.
۸. سرویسها: جداسازی Monolith، با احتیاط
با رشد اپلیکیشن، تیمها ممکن است قابلیتهای مختلف را به سرویسهای مستقلی تبدیل کنند که کد، فرآیند دپلوی و اغلب دیتابیس مخصوص خود را دارند.
Platefull سه سرویس دارد:
- Accounts Service: برای ارائه یک Login مشترک در اپلیکیشنهای مختلف
- Payment Service: برای جداسازی بخش پرداخت با هدف افزایش امنیت و رعایت الزامات قانونی
- Media Service: برای مدیریت آپلود و پردازش فایلها
سرویسها از طریق APIهای داخلی، مانند REST یا gRPC، با یکدیگر ارتباط برقرار میکنند. همچنین، استفاده از Eventهای بخش قبل برای واکنش سرویسها به رویدادهای یکدیگر روزبهروز رایجتر میشود.
مزایای این رویکرد واقعی هستند: تیمها میتوانند مستقل از یکدیگر دپلوی کنند، خرابی یک قابلیت در همان محدوده باقی میماند و هر سرویس میتواند جداگانه Scale شود.
کمی عمیقتر
مهمترین اصلاح دیدگاه صنعت از سال ۲۰۱۷ تاکنون، به زمان مناسب برای انجام این کار مربوط میشود.
میکروسرویسها پیچیدگی کد را با پیچیدگی سیستمهای توزیعشده مبادله میکنند، از خرابی ارتباط شبکه میان سرویسها گرفته تا APIهای نسخهبندیشده و ردیابی یک درخواست در ده مرحله مختلف.
این مبادله برای تیمهای کوچک هزینه زیادی دارد.
توصیهای که امروز از مهندسان باتجربه میشنوید، Monolith-first است: با یک کدبیس خوشساخت شروع کنید و تنها زمانی یک سرویس را جدا کنید که مرز مشخصی میان قابلیتها شکل گرفته باشد و حفظ آنها در یک سیستم واقعا دردسرساز شده باشد. بخش پرداخت تقریبا همیشه یکی از گزینههای مناسب برای چنین جداسازیای است.
تعداد سرویسها را نیز بسیار کمتر از تعداد مهندسان نگه دارید.
برخی شرکتهای بسیار بزرگ، مونولیتهای عظیمی را با موفقیت اداره میکنند، در حالی که بعضی شرکتها از رفتن زودهنگام به سمت میکروسرویسها پشیمان شدهاند.
ساده و کسلکننده بودن معماری، خودش یک مزیت است.
۹. Data Pipeline: از Event تا بینش
شرکتها تا حد زیادی بر اساس تواناییشان در یادگیری از دادهها موفق میشوند یا شکست میخورند. اما هرگز نباید Queryهای سنگین تحلیلگران را روی دیتابیس پروداکشنی اجرا کنید که مسئول پاسخگویی به کاربران است.
بنابراین، دادهها از مسیر اصلی پردازش درخواست خارج میشوند و وارد یک زیرساخت تحلیلی مستقل میشوند که سه مرحله دارد.
مرحله اول: جمعآوری (Collect)
اپلیکیشن Eventهایی مانند recipe_viewed و subscription_started را به یک Streaming Pipeline میفرستد، مثلا Kafka یا سرویس مدیریتشدهای مانند Kinesis.
مرحله دوم: ذخیرهسازی (Store)
Eventهای خام با هزینه کم در Object Storage ذخیره میشوند و Data Lake را تشکیل میدهند، لایهای با این رویکرد که «همهچیز را نگه دار، بعدا تصمیم بگیر».
مرحله سوم: تحلیل (Analyze)
دادههای پاکسازیشده و تبدیلشده به Data Warehouse منتقل میشوند، برای مثال Snowflake، BigQuery، Redshift یا ClickHouse.
Data Warehouse یک دیتابیس با Engine ستونی است که برای اسکن میلیاردها ردیف در هر کوئری طراحی شده است.
در کنار Eventها، دادههای دیتابیس پروداکشن نیز بهصورت شبانه یا Streaming همگامسازی میشوند تا تحلیلگران بتوانند دادههای کسبوکار و رفتار کاربران را کنار هم بررسی کنند.
ابزارهای Transformation مانند dbt و ابزارهایی مانند Spark برای پردازش توزیعشده سنگین، جایگزین بخش زیادی از دنیای Hadoop و MapReduce شدهاند که در مقاله سال ۲۰۱۷ به آن اشاره شده بود.
کمی عمیقتر: هر نوع داده باید کجا قرار بگیرد؟
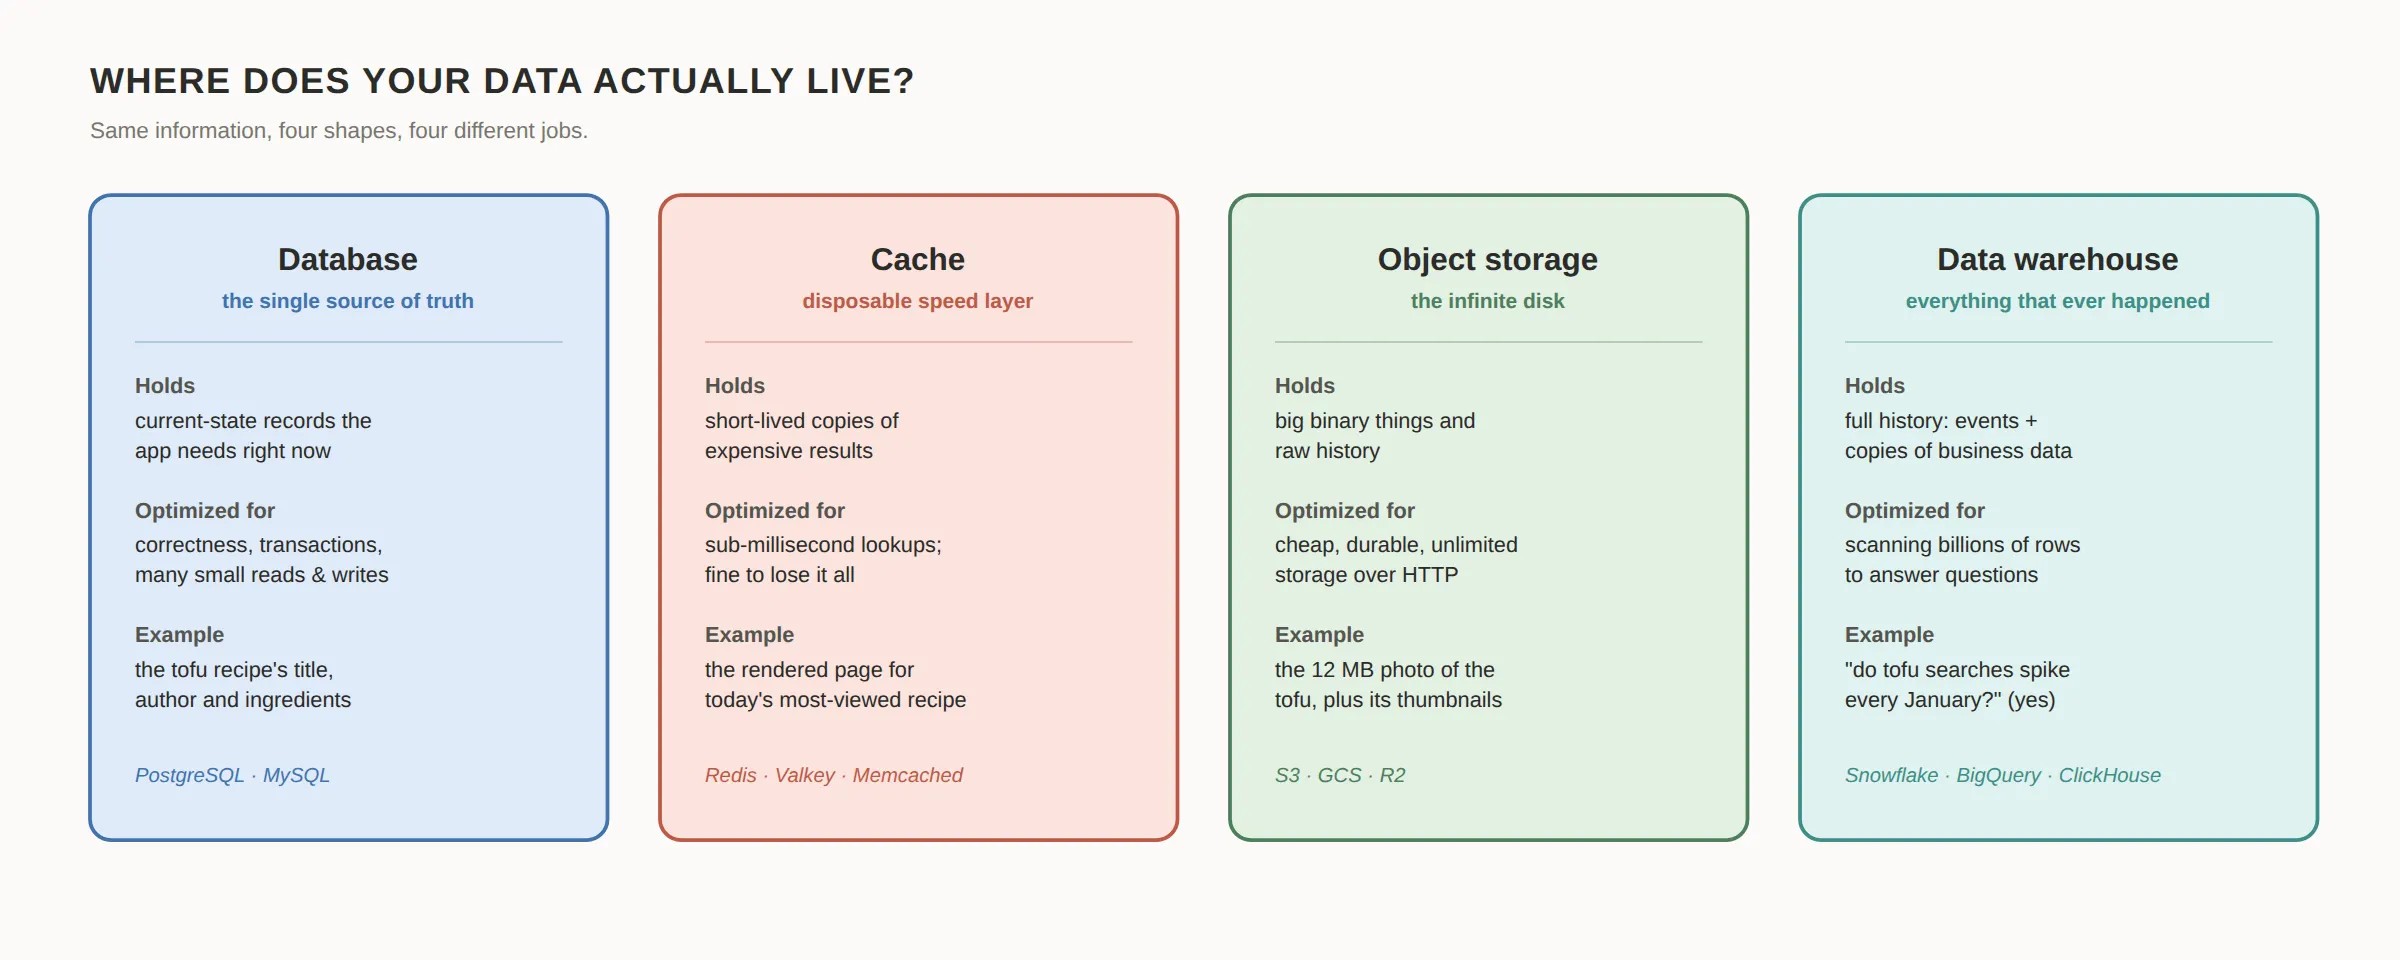
این موضوع بسیاری را سردرگم میکند، بنابراین این قاعده کلی را به خاطر بسپارید:
- دیتابیس: حقیقت فعلی موردنیاز اپلیکیشن، مانند پروفایل کاربر یا دستور پخت فعلی
- کش: نسخههای قابلحذف از دادهها برای افزایش سرعت
- Object Storage: فایلهای حجیم و باینری، مانند عکسها، بهعلاوه دادههای خام و تاریخی
- Data Warehouse: تمام اتفاقات ثبتشده، سازماندهیشده برای پاسخ به پرسشهای تحلیلی، نه ارائه صفحه به کاربران
اطلاعات ممکن است یکسان باشند، اما هرکدام از این چهار ساختار، وظیفه متفاوتی دارند.
۱۰. Object Storage: یک دیسک تقریبا بینهایت
Object Storage، مانند S3، Google Cloud Storage یا جایگزینهای سازگار با S3 مانند Cloudflare R2، محل نگهداری فایلهاست، از تصاویر و ویدئوها گرفته تا بکآپها، Logها و آرشیوهای Data Lake.
این سرویسها ظرفیت تقریبا نامحدود، دوام بسیار بالا و یک HTTP API ساده ارائه میکنند. کافی است یک Blob را با یک Key ذخیره کنید و بعدا با همان Key آن را بازیابی کنید.
دیگر نیازی نیست نگران پر شدن دیسکها یا مدیریت RAID باشید.
Object Storage شاید در نمودار کمزرقوبرقترین کامپوننت باشد، اما یکی از اجزای حیاتی معماری است. به تعداد فلشهایی که در نمودار به آن ختم میشوند توجه کنید، بسیاری از بخشهای سیستم به آن وابستهاند.
۱۱. CDN و Edge: نزدیکتر کردن اینترنت به کاربر
یک Content Delivery Network یا CDN، مانند CloudFront، کلادفلر و Fastly، نسخههایی از Assetهای ثابت شما، از جمله تصاویر، CSS، جاوااسکریپت و ویدئوها، را روی هزاران Edge Server در سراسر جهان نگه میدارد.
به این ترتیب، کاربری در ورشو Thumbnailهای Platefull را از سروری در ورشو دریافت میکند، نه از ویرجینیا.
قوانین فیزیک را نمیتوان دور زد: فاصله کمتر به معنای تاخیر کمتر است و بخش بزرگی از بهینهسازی عملکرد Frontend در واقع مبارزه با همین فاصله است.
کمی عمیقتر
یکی از نکات مهم مطرحشده در نظرات مقاله اصلی این بود که برای بسیاری از سایتها، بخش عمده نمودار اصلا ضروری نیست. اگر محتوا بهندرت تغییر میکند، میتوانید صفحات را از قبل به فایلهای ثابت تبدیل کنید و کل سایت را مستقیما از CDN ارائه دهید.
این ایده به جریان مدرن Static و Hybrid Rendering منجر شده است، رویکردی که ابزارهایی مانند Next.js و Astro از آن استفاده میکنند. در این معماری، صفحات از قبل تولید میشوند و فقط بخشهایی که واقعا پویا هستند به سرورها مراجعه میکنند.
قابلیتهای Edge نیز بسیار فراتر رفتهاند. امروزه CDNها میتوانند کد اجرا کنند، برای مثال با Cloudflare Workers و Lambda@Edge، کارهایی مانند ریدایرکت، تست A/B، بررسی احراز هویت و حتی اجرای APIهای کامل را در فاصله چند میلیثانیهای از کاربر انجام میدهند.
مرز میان CDN و اپلیکیشن هر سال کمی کمرنگتر میشود.
۱۲. امنیت (Security)
امنیت یک جعبه مستقل در نمودار نیست، بلکه ویژگی تمام ارتباطات میان اجزاست. بااینحال، چند کامپوننت بخش عمده مسئولیت را بر عهده دارند.
TLS در همهجا
تمام ارتباطات باید رمزنگاری شوند، همان چیزی که https:// نشان میدهد. امروزه دریافت و تمدید Certificateها با ابزارهایی مانند Let's Encrypt رایگان و خودکار شده است، بنابراین بهانهای برای استفاده نکردن از آن وجود ندارد.
در بسیاری از معماریها، TLS در Edge یا Load Balancer Terminate میشود. در محیطهایی با الزامات امنیتی بالاتر، ترافیک داخلی نیز رمزنگاری میشود.
WAF و محافظت در برابر DDoS
یک Web Application Firewall جلوی لودبالانسر قرار میگیرد و ترافیک مخرب را فیلتر میکند، از تلاشهای SQL Injection گرفته تا سیل درخواستهای Botها و درخواستهای شبکههای شناختهشده مخرب.
یکی از دلایل اصلی وجود CDNها، توانایی آنها در جذب حملات Distributed Denial-of-Service است. مقیاس زیرساخت این سرویسها به سپر دفاعی شما تبدیل میشود.
هویت و احراز هویت (Identity)
در سال ۲۰۲۶، ذخیرهسازی رمز عبور را از صفر و بهصورت دستساز پیادهسازی نکنید. از پروتکلهای استاندارد مانند OAuth 2.0 و OpenID Connect استفاده کنید و برای بیشتر تیمها، یک Identity Provider مدیریتشده مانند Auth0، Cognito یا امکان ورود با حسابهای اجتماعی انتخاب مناسبی است.
سشنها از طریق کوکیهای امن یا Tokenهای کوتاهعمر، مانند JWT، مدیریت میشوند.
Secrets و حداقل سطح دسترسی
رمزهای دیتابیس و API Keyها باید در یک Secrets Manager نگهداری شوند، نه در کد.
هر سرویس فقط باید مجوزهایی را داشته باشد که واقعا به آنها نیاز دارد، تا در صورت نفوذ به یک کامپوننت، مهاجم نتواند به تمام بخشهای سیستم دسترسی پیدا کند.
۱۳. Observability: از کجا بفهمیم سیستم خراب شده است؟
یکی از کمبودهای رایج مقالات مقدماتی این است که درباره نحوه مشاهده و پایش سیستم در حال اجرا توضیحی نمیدهند. تمام اجزای معماری بیفایدهاند اگر نتوانید وضعیت اجرای آنها را ببینید.
Observability معمولا بر سه ستون اصلی استوار است.
لاگها
رکوردهای زماندار از اتفاقاتی که رخ دادهاند. Logها از تمام کانتینرها به یک مخزن مرکزی و قابلجستوجو ارسال میشوند، چون ورود به تکتک سرورها از طریق SSH و خواندن فایلها، از یک دهه پیش به بعد دیگر روش مقیاسپذیری نبوده است.
متریکها
اعدادی که در طول زمان تغییر میکنند، مانند نرخ درخواست، نرخ خطا، Percentileهای Latency و عمق Queue.
این متریکها به داشبوردها و سیستمهای Alerting منتقل میشوند. پرومتئوس و گرافانا از ابزارهای متنباز استاندارد این حوزه هستند.
Traces
Trace مانند گذرنامه یک درخواست است که در هر کامپوننتی که از آن عبور میکند، مهر میخورد. با استفاده از آن میتوانید بفهمید چرا Checkout کند بوده است، مثلا چون Payment Service برای پاسخ دیتابیس، به مدت ۸۰۰ میلیثانیه منتظر مانده است.
OpenTelemetry به استانداردی مستقل از Vendor برای تولید هر سه نوع داده تبدیل شده است، دادههایی که میتوانند در ابزارهایی مانند Datadog، گرافانا یا Sentry برای Error Tracking ذخیره و بررسی شوند.
کمی عمیقتر
جمعآوری دادهها بخش آسان کار است. مهارت اصلی در این است که بهجای علتهای احتمالی، مانند درصد استفاده از CPU، روی نشانههایی Alert تعریف کنید که کاربران واقعا احساس میکنند، مانند نرخ خطا و Latency.
همچنین باید با استفاده از SLOها مشخص کنید که «وضعیت سالم» برای سیستم دقیقا به چه معناست و تلاش کنید تماسهای اضطراری ساعت سه صبح را به مسئلهای تبدیل کنید که با اصلاح طراحی، دیگر تکرار نشود.
هدف ساخت داشبوردهای بیشتر نیست، هدف کوتاهتر کردن قطعیهاست.
حرف آخر: لازم نیست از ابتدا همه این اجزا را داشته باشید
یک نکته مهم وجود دارد که نمودار به شما نمیگوید: تقریبا هیچکس کارش را با چنین معماری پیچیدهای شروع نمیکند و شما هم نباید این کار را انجام دهید.
نسخه اول Platefull بهتر است فقط شامل یک فریمورک، یک دیتابیس PostgreSQL، یک Object Storage برای تصاویر و یک CDN در جلوی سیستم باشد، چهار کامپوننت، یک فرآیند دپلوی و معماریای ساده و قابلمدیریت.
هر کامپوننتی که در این مقاله معرفی شد، پاسخی به یک مشکل مشخص است:
- کش زمانی اضافه میشود که دیتابیس تحت فشار قرار میگیرد.
- Queue زمانی اضافه میشود که پردازش درخواستها طولانی میشود.
- سرویسهای مستقل زمانی شکل میگیرند که تیمها در کار یکدیگر اختلال ایجاد میکنند.
- Data Warehouse زمانی ضروری میشود که تحلیلهای سنگین، عملکرد پروداکشن را تحت تاثیر قرار میدهند.
معماری یک فهرست خرید نیست، مجموعهای از زخمهای بهبودیافته است که هرکدام در پاسخ به یک گلوگاه به دست آمدهاند.
بااینحال، حالا که با این کامپوننتها آشنا شدهاید، هنگام مواجهه با آنها در یک سند طراحی، جلسه بررسی Incident یا مصاحبه شغلی میدانید هرکدام چه وظیفهای دارند، چه هزینهای ایجاد میکنند و نبودشان چه مشکلاتی به وجود میآورد.
این مدل ذهنی، همان چیزی است که واقعا باید از یک آموزش مقدماتی معماری وب یاد بگیرید.
اگر میخواهید عمیقتر پیش بروید، این منابع نقطه شروع خوبی هستند:
- Designing Data-Intensive Applications نوشته Martin Kleppmann: کتابی که تقریبا همه توصیه میکنند بخوانید، و حق هم دارند.
- Engineering Blogهای Cloudflare، Netflix و Stripe: برای دیدن کاربرد این مفاهیم در مقیاس جهانی
این مقاله از Web Architecture 101 نوشته Jonathan Fulton در سال ۲۰۱۷ الهام گرفته است، همچنین پرسشها و اصلاحاتی که در بخش نظرات آن مطرح شده بودند، در شکلگیری محتوایی که خواندید نقش داشتند.
اگر میخواهید در بلندمدت به مهندس نرمافزار توانمندتری تبدیل شوید، من درباره مبانی طراحی نرمافزار و معماری نیز مینویسم.
دیدگاهها
ثبت دیدگاه