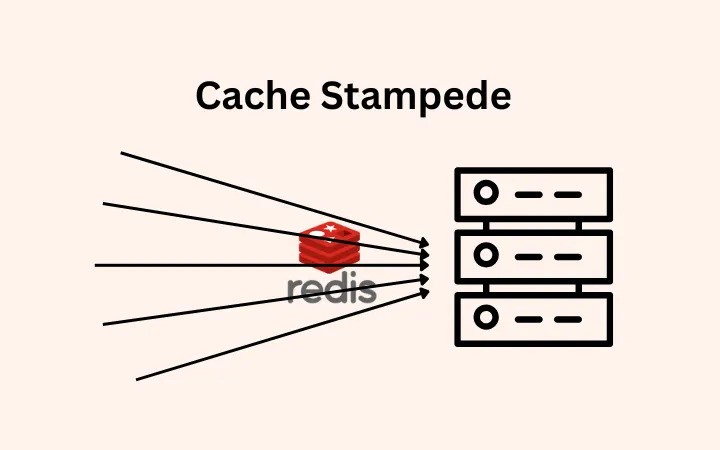
فرض کنید حجم دادههای یک صفحه محصول ۱۰ کیلوبایت است. این دادهها با زمان انقضای ۱۰ دقیقه در کش ذخیره شدهاند. در هر لحظه، یک میلیون کاربر فعال در این صفحه حضور دارند.
از آنجا که کش هر ۱۰ دقیقه منقضی میشود، تمام یک میلیون درخواست مستقیماً به دیتابیس ارسال میشوند. این اتفاق بار بیشازحدی به سرور دیتابیس وارد میکند و باعث کاهش سرعت سرور میشود.
به این وضعیت Cache Stampede (هجوم همزمان درخواستها به کش منقضیشده) گفته میشود.
تصویر زیر این وضعیت را نشان میدهد.
روشهای مختلفی برای جلوگیری از Cache Stampede وجود دارد. در ادامه چند روش را بررسی میکنیم.
۱. قفلگذاری روی کش (Cache Locking)
هنگامی که کش منقضی میشود، میتوانیم یک قفل ایجاد کنیم. در این حالت، فقط یک درخواست اجازه دارد دادههای کش را مجدداً تولید کند و سایر درخواستها باید منتظر بمانند تا بازسازی کش به پایان برسد.
$cacheKey = 'product_123';
$cacheValue = Cache::get($cacheKey);
if (!$cacheValue) {
// تلاش برای قفل کردن کلید کش
$lock = Cache::lock($cacheKey . '_lock', 10); // قفل به مدت ۱۰ ثانیه
if ($lock->get()) {
try {
// بازسازی کش فقط در صورت دریافت قفل
$cacheValue = generateProductData(); // منطق بازسازی کش
Cache::put($cacheKey, $cacheValue, 3600); // ذخیره در کش به مدت یک ساعت
} finally {
$lock->release();
}
} else {
// کمی صبر کنید و دوباره تلاش کنید
// یا در صورت دسترسپذیر شدن داده، آن را از کش بخوانید
$cacheValue = Cache::get($cacheKey);
}
}با این روش، از بازسازی همزمان یک داده توسط تعداد زیادی درخواست جلوگیری میشود و فشار واردشده به دیتابیس کاهش پیدا میکند.
۲. پیشبارگذاری کش (Preloading Cache / Warm Cache)
در این روش، کش را یک تا دو دقیقه پیش از زمان انقضای آن بازسازی میکنیم.
علاوه بر این، اگر از رویدادهای مشخصی اطلاع داشته باشیم، میتوانیم دادهها را از قبل در کش قرار دهیم. برای مثال، اگر بدانیم هر شب ساعت ۱۰ تعداد زیادی کاربر از یک صفحه بازدید میکنند، میتوانیم پیش از این زمان دادههای آن صفحه را در کش ذخیره کنیم.
class PreloadCacheJob extends Job
{
public function handle()
{
// دریافت دادهها از دیتابیس
$data = Data::all();
// پیشبارگذاری کش با دادههای جدید به مدت ۶۰ دقیقه
Cache::put(
'some_data_key',
$data,
now()->addMinutes(60)
);
}
}
// اجرای وظیفه پیشبارگذاری در دقیقه ۵۸ هر ساعت
$schedule->job(new PreloadCacheJob)->hourlyAt(58);در این مثال، وظیفه بازسازی کش در دقیقه ۵۸ هر ساعت اجرا میشود تا پیش از انقضای کش قبلی، دادههای جدید در دسترس قرار بگیرند.
البته این روش زمانی مؤثرتر است که زمان انقضای کش و زمان اجرای وظیفه بهدرستی هماهنگ شده باشند.
۳. بهروزرسانی کش در پسزمینه (Background Cache Refresh)
در این روش، بهجای اینکه کاربران منتظر بازسازی کش بمانند، یک وظیفه در پسزمینه اجرا میشود تا دادههای جدید را در کش قرار دهد. در این فاصله، میتوان دادههای قدیمی را بهصورت موقت در اختیار کاربران قرار داد.
public function getData()
{
$cacheKey = 'your_data_key';
// بررسی وجود داده در کش
if (Cache::has($cacheKey)) {
return Cache::get($cacheKey);
}
// در صورت نبود داده در کش، وظیفه بهروزرسانی را اجرا کن
RefreshCacheJob::dispatch($cacheKey);
// در صورت نیاز، تا پایان اجرای وظیفه داده قدیمی را برگردان
return response()->json([
'status' => 'Cache refreshing in background'
], 202);
}
// تعریف وظیفه بهروزرسانی کش
class RefreshCacheJob extends Job
{
protected $key;
public function __construct($key)
{
$this->key = $key;
}
public function handle()
{
// دریافت دادهها یا اطلاعات موردنیاز برای کش
$data = YourModel::all(); // منطق واقعی دریافت دادهها را جایگزین کنید
// ذخیره دادهها در کش
Cache::put(
$this->key,
$data,
now()->addMinutes(10)
);
}
}مزیت این روش آن است که بازسازی کش میتواند بدون معطل کردن درخواست کاربر انجام شود.
البته در پیادهسازی بالا، اگر کش وجود نداشته باشد، پاسخ 202 به کاربر برگردانده میشود؛ این پاسخ حاوی دادههای قدیمی نیست. برای پیادهسازی واقعی این الگو، باید داده قدیمی را جداگانه نگه داریم یا از مکانیزمی استفاده کنیم که تا زمان تولید دادههای جدید، نسخه قبلی در دسترس بماند.
همچنین باید از اجرای همزمان تعداد زیادی وظیفه RefreshCacheJob جلوگیری کنیم؛ در غیر این صورت، خود صف وظایف میتواند به منبع فشار اضافی تبدیل شود.
۴. افزودن نوسان تصادفی به زمان انقضای کش (Jitter)
با افزودن Jitter، زمان انقضای کش برای هر ورودی کمی متفاوت خواهد بود. به این ترتیب، تمام ورودیهای کش بهصورت همزمان منقضی نمیشوند و احتمال وقوع Cache Stampede کاهش پیدا میکند.
public function getProductDetails($productId)
{
    // دریافت شناسه نشست فعلی
    $sessionId = session()->getId();

    // تعیین زمان پایه کش: ۶۰ دقیقه
    $ttl = 60 * 60;

    // افزودن Jitter تصادفی بین ۱ تا ۵ دقیقه
    $jitter = rand(60, 300);

    // محاسبه زمان انقضای نهایی
    $adjustedTtl = $ttl + $jitter;

    // ساخت کلید کش بر اساس شناسه نشست و محصول
    $cacheKey = "session_{$sessionId}:product_{$productId}";

    // تلاش برای دریافت محصول از کش
    $product = Cache::remember(
        $cacheKey,
        $adjustedTtl,
        function () use ($productId) {
            // در صورت نبود داده در کش، دریافت از دیتابیس
            return Product::find($productId);
        }
    );

    return response()->json($product);
}
در این مثال، زمان انقضای کش بهجای ۶۰ دقیقه دقیق، بین ۶۱ تا ۶۵ دقیقه خواهد بود.
نکته مهم: در این کد، کلید کش بر اساس شناسه نشست و شناسه محصول ساخته شده است. بنابراین، دادههای هر کاربر در کش جداگانهای ذخیره میشوند. اگر یک میلیون کاربر به این صفحه دسترسی داشته باشند، ممکن است یک میلیون ورودی کش مجزا ایجاد شود.
برای مثال، اگر حجم داده هر ورودی ۱۰ کیلوبایت باشد، حجم کل کش به این مقدار میرسد:
10 KB * 1M = 10 GBاین موضوع یکی از معایب احتمالی چنین پیادهسازیای است.
در بسیاری از موارد، اگر اطلاعات محصول برای همه کاربران یکسان باشد، بهتر است کلید کش بر اساس شناسه محصول ساخته شود، نه شناسه نشست کاربر. در این صورت، کاربران میتوانند از یک ورودی مشترک در کش استفاده کنند.
شما کدام روش را ترجیح میدهید؟
با توجه به شرایط پروژه، هر یک از این روشها میتواند انتخاب مناسبی باشد؛ اما انتخاب نهایی به عواملی مانند میزان ترافیک، هزینه بازسازی دادهها، میزان تحمل دادههای قدیمی و ظرفیت حافظه کش بستگی دارد.
دیدگاهها
ثبت دیدگاه