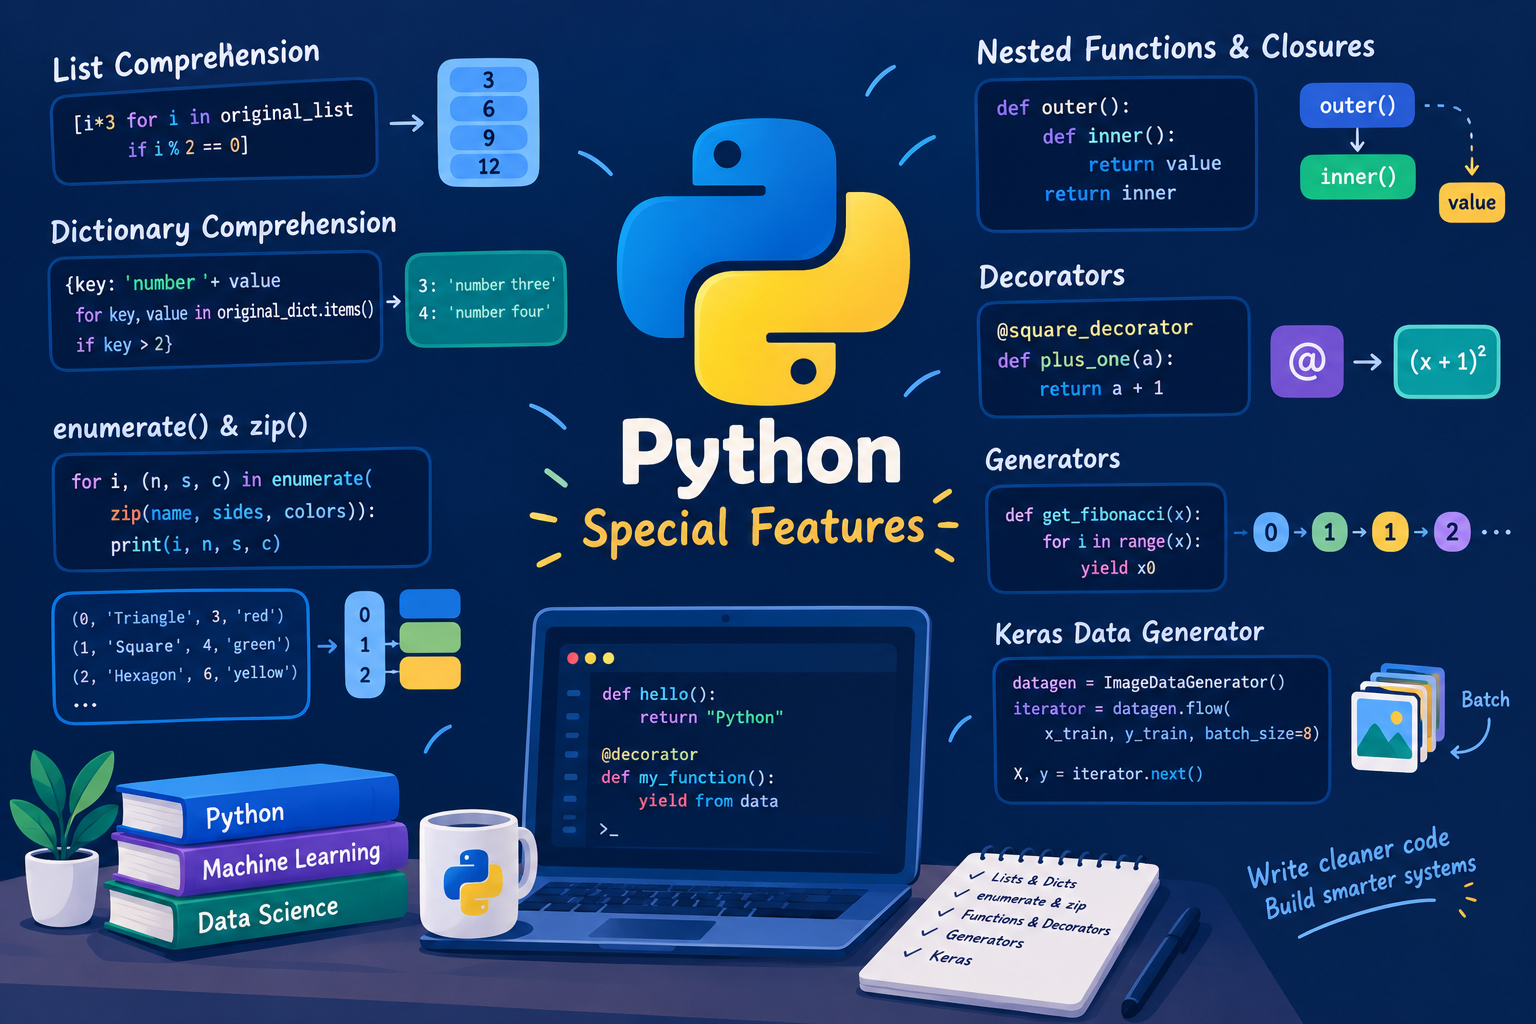
پایتون یک زبان برنامهنویسی قدرتمند و یکی از محبوبترین زبانها برای توسعه اپلیکیشنهای هوش مصنوعی (AI) و یادگیری ماشین (Machine Learning) است. سینتکس ساده و یادگیری آسان، در کنار ویژگیهای منحصربهفرد، پایتون را از بسیاری از زبانهای برنامهنویسی دیگر متمایز میکند. در این آموزش، با تعدادی از ویژگیهای خاص زبان برنامهنویسی پایتون آشنا میشویم.
پس از مطالعه این آموزش، با موارد زیر آشنا خواهید شد:
- List Comprehension و Dictionary Comprehension
- نحوه استفاده از توابع
zip()وenumerate() - مفهوم Function Context و Decorator
- کاربرد Generatorها در پایتون
وارد کردن کتابخانهها (Import Section)
کتابخانههای مورد استفاده در این آموزش، در کد زیر import شدهاند:
from tensorflow import kerasfrom tensorflow.keras.preprocessing.image import ImageDataGeneratorimport numpy as npimport matplotlib.pyplot as pltimport mathList Comprehension
List Comprehension روشی کوتاه و ساده برای ساختن Listهای جدید از روی Listهای موجود است.
برای مثال، فرض کنید میخواهیم یک List جدید بسازیم که هر عنصر آن حاصلضرب عنصر متناظر در List اصلی در عدد ۳ باشد. یکی از روشها استفاده از حلقه for است:
original_list = [1, 2, 3, 4]times3_list = []for i in original_list: times3_list.append(i * 3)print(times3_list)خروجی:
[3, 6, 9, 12]اما با استفاده از List Comprehension میتوانیم همین کار را تنها با یک خط کد انجام دهیم:
time3_list_awesome_method = [i * 3 for i in original_list]print(time3_list_awesome_method)خروجی:
[3, 6, 9, 12]همچنین میتوانید List جدیدی را بر اساس یک شرط مشخص ایجاد کنید. برای مثال، اگر بخواهیم فقط اعداد زوج به List جدید اضافه شوند، میتوانیم بنویسیم:
even_list_awesome_method = [i for i in original_list if i % 2 == 0]print(even_list_awesome_method)خروجی:
[2, 4]همچنین میتوان از else در List Comprehension استفاده کرد. برای مثال، میتوانیم اعداد زوج را بدون تغییر نگه داریم و اعداد فرد را با صفر جایگزین کنیم:
new_list_awesome_method = [i if i % 2 == 0 else 0 for i in original_list]print(new_list_awesome_method)خروجی:
[0, 2, 0, 4]از List Comprehension میتوان برای جایگزین کردن حلقههای تودرتو (Nested Loops) نیز استفاده کرد. برای مثال، کد زیر را در نظر بگیرید:
colors = ["red", "green", "blue"]animals = ["cat", "dog", "bird"]newlist = []for c in colors: for a in animals: newlist.append(c + " " + a)print(newlist)خروجی:
['red cat', 'red dog', 'red bird', 'green cat', 'green dog', 'green bird', 'blue cat', 'blue dog', 'blue bird']میتوانیم همین نتیجه را با استفاده از دو حلقه for در یک List Comprehension به دست آوریم:
colors = ["red", "green", "blue"]animals = ["cat", "dog", "bird"]newlist = [c + " " + a for c in colors for a in animals]print(newlist)سینتکس List Comprehension
ساختار کلی List Comprehension به شکل زیر است:
newlist = [expression for item in iterable if condition == True]یا در حالتی که بخواهیم بر اساس شرط، یکی از دو عبارت را انتخاب کنیم:
newList = [expression if condition == True else expression for item in iterable]Dictionary Comprehension
Dictionary Comprehension مشابه List Comprehension است، با این تفاوت که در اینجا با جفتهای (key, value) یا «کلید و مقدار» سروکار داریم.
برای مثال، فرض کنید میخواهیم رشتهی 'number ' را به ابتدای مقدار هر عنصر در یک Dictionary اضافه کنیم:
original_dict = {1: 'one', 2: 'two', 3: 'three', 4: 'four'}new_dict = { key: 'number ' + value for (key, value) in original_dict.items()}print(new_dict)خروجی:
{1: 'number one', 2: 'number two', 3: 'number three', 4: 'number four'}در اینجا نیز میتوان از شرطها استفاده کرد. به این ترتیب، جفتهای (key, value) بر اساس یک معیار مشخص به Dictionary جدید اضافه میشوند.
در مثال زیر، فقط کلیدهایی که مقدارشان بزرگتر از ۲ است، وارد Dictionary جدید میشوند:
# فقط کلیدهای بزرگتر از ۲ را اضافه کنnew_dict_high_keys = { key: 'number ' + value for (key, value) in original_dict.items() if key > 2}print(new_dict_high_keys)خروجی:
{3: 'number three', 4: 'number four'}در مثال بعدی، فقط مقادیر مربوط به کلیدهای بزرگتر از ۲ تغییر میکنند و سایر مقادیر بدون تغییر باقی میمانند:
# فقط مقادیر مربوط به کلیدهای بزرگتر از ۲ را تغییر بدهnew_dict_2 = { key: ('number ' + value if key > 2 else value) for (key, value) in original_dict.items()}print(new_dict_2)خروجی:
{1: 'one', 2: 'two', 3: 'number three', 4: 'number four'}توابع Enumerate و Zip در پایتون
در پایتون، Iterable به ساختار داده یا آبجکتی گفته میشود که میتوان عناصر آن را یکییکی پیمایش کرد. به کمک این قابلیت، میتوانیم از حلقه for برای پردازش عناصر یک Iterable استفاده کنیم.
پایتون دو تابع کاربردی به نامهای enumerate() و zip() دارد که کار با حلقههای for را سادهتر میکنند.
تابع Enumerate
در بسیاری از زبانهای برنامهنویسی، برای پیمایش عناصر یک مجموعه به متغیری برای نگهداری شمارنده حلقه نیاز داریم. پایتون این کار را سادهتر کرده است، تابع enumerate() به شما اجازه میدهد هنگام پیمایش یک Iterable، هم به شمارنده و هم به مقدار هر عنصر دسترسی داشته باشید.
برای مثال، کد زیر را در نظر بگیرید:
name = ['Triangle', 'Square', 'Hexagon', 'Pentagon']# تابع enumerate به شمارنده و مقدار هر عنصر دسترسی میدهدfor i, n in enumerate(name): print(i, 'name: ', n)خروجی:
0 name:  Triangle
1 name:  Square
2 name:  Hexagon
3 name: Pentagonبهطور پیشفرض، enumerate() شمارش را از صفر آغاز میکند، اما میتوان با تعیین یک مقدار دیگر، نقطه شروع شمارش را تغییر داد. این قابلیت در بعضی شرایط کاربردی است.
برای مثال:
data = [1, 4, 1, 5, 9, 2, 6, 5, 3, 5, 8, 9, 7, 9, 3]for n, digit in enumerate(data[5:], 6): print("The %d-th digit is %d" % (n, digit))خروجی:
The 6-th digit is 2
The 7-th digit is 6
The 8-th digit is 5
The 9-th digit is 3
The 10-th digit is 5
The 11-th digit is 8
The 12-th digit is 9
The 13-th digit is 7
The 14-th digit is 9
The 15-th digit is 3
در این مثال، پیمایش از عنصر ششم List آغاز میشود و شمارنده نیز از عدد ۶ شروع میشود.
تابع Zip
تابع zip() امکان ساخت یک Iterable از نوع Tuple را فراهم میکند. این تابع چند مجموعه را بهعنوان ورودی دریافت میکند و با کنار هم قرار دادن عناصر متناظر آنها، Tupleهایی میسازد.
برای مثال، اگر سه مجموعه با نامهای \(m_1, m_2, \ldots, m_n\) داشته باشیم، تابع zip() عنصر اول هر مجموعه را در یک Tuple قرار میدهد، سپس عناصر دوم را کنار هم میگذارد و به همین ترتیب ادامه میدهد. بنابراین، Tuple مربوط به موقعیت \(i\) شامل عناصر متناظر از تمام مجموعهها خواهد بود.
اگر طول مجموعههای ورودی متفاوت باشد، تعداد Tupleهای تولیدشده برابر با طول کوتاهترین مجموعه است.
در ادامه، نمونهای از استفاده همزمان از zip() و enumerate() را میبینید:
sides = [3, 4, 6, 5]colors = ['red', 'green', 'yellow', 'blue']shapes = zip(name, sides, colors)# هر Tuple از یک عنصر هر List تشکیل میشودprint(set(shapes))# استفاده همزمان از enumerate و zip برای پیمایش چند Listfor i, (n, s, c) in enumerate(zip(name, sides, colors)): print(i, 'Shape- ', n, '; Sides ', s)خروجی:
{('Triangle', 3, 'red'), ('Square', 4, 'green'), ('Hexagon', 6, 'yellow'), ('Pentagon', 5, 'blue')}

0 Shape-  Triangle ; Sides  3
1 Shape-  Square ; Sides  4
2 Shape-  Hexagon ; Sides  6
3 Shape-  Pentagon ; Sides  5
در این مثال، zip() نام شکل، تعداد ضلعها و رنگ هر شکل را در یک Tuple قرار میدهد. سپس enumerate() یک شمارنده نیز به هر Tuple اضافه میکند.
Function Context در پایتون
پایتون از توابع تودرتو (Nested Functions) پشتیبانی میکند. به این معنا که میتوان یک تابع داخلی را داخل تابع دیگری تعریف کرد. این قابلیت چند ویژگی مهم دارد:
- تابع بیرونی میتواند مرجعی به تابع داخلی را برگرداند.
- تابع داخلی میتواند به متغیرهای محلی خودش و متغیرهای موجود در تابع بیرونی دسترسی داشته باشد، حتی اگر اجرای تابع بیرونی تمام شده باشد.
مثال زیر این رفتار را نشان میدهد:
def circle(r): area_val = math.pi * r * r def area(): print(area_val) return area# تابع داخلی برگردانده میشود و مقدار r را حفظ میکندcircle_1 = circle(1)circle_2 = circle(2)# محاسبه مساحت با شعاع ۱circle_1()# محاسبه مساحت با شعاع ۲circle_2()خروجی:
3.141592653589793
12.566370614359172
در این مثال، تابع circle() مرجعی به تابع داخلی area() برمیگرداند. هر تابع داخلی مقدار area_val مربوط به فراخوانی خودش را حفظ میکند، بنابراین، حتی پس از پایان اجرای circle() نیز میتوان از این مقدار استفاده کرد.
این رفتار با مفهومی به نام Closure مرتبط است، یعنی تابعی که به متغیرهای محیطی که در آن تعریف شده، دسترسی خود را حفظ میکند.
Decoratorها در پایتون
Decoratorها یکی از قابلیتهای قدرتمند پایتون هستند. با استفاده از آنها میتوان رفتار یک تابع یا کلاس را توسعه داد یا سفارشی کرد، بدون اینکه لازم باشد کد اصلی آن را تغییر دهیم.
میتوانید Decorator را تابعی در نظر بگیرید که تابع دیگری را بهعنوان ورودی دریافت میکند و معمولا تابعی جدید برمیگرداند. برای اعمال Decorator به یک تابع، از نماد @ و نام Decorator در خط قبل از تعریف تابع استفاده میکنیم.
در مثال زیر، تابع square_decorator() یک تابع را بهعنوان آرگومان دریافت میکند و تابع دیگری برمیگرداند.
- تابع داخلی
square_it()یک آرگومان به نامargدریافت میکند. - تابع
square_it()تابع ورودی را رویargاجرا میکند و سپس نتیجه را به توان دو میرساند. - میتوانیم تابعی مانند
sinرا بهsquare_decorator()بدهیم تا خروجی آن برابر با \(\sin^2(x)\) باشد. - همچنین میتوانیم تابع دلخواه خود را تعریف کنیم و با استفاده از
@square_decorator، این Decorator را روی آن اعمال کنیم.
برای مثال، تابع plus_one(x) مقدار x + 1 را برمیگرداند. وقتی Decorator را روی آن اعمال کنیم، نتیجه بهجای x + 1 برابر با \((x + 1)^2\) خواهد بود.
def square_decorator(function): def square_it(arg): x = function(arg) return x * x return square_itsize_sq = square_decorator(len)print(size_sq([1, 2, 3]))sin_sq = square_decorator(math.sin)print(sin_sq(math.pi / 4))@square_decoratordef plus_one(a): return a + 1a = plus_one(3)print(a)خروجی:
9
0.4999999999999999
16
در مثال اول، تابع len() طول List را محاسبه میکند و Decorator نتیجه را به توان دو میرساند، بنابراین خروجی برابر با \(3^2 = 9\) است.
در مثال دوم، نتیجه تابع sin() به توان دو میرسد. در مثال سوم نیز plus_one(3) مقدار ۴ را برمیگرداند و Decorator آن را به توان دو میرساند، در نتیجه، خروجی برابر با ۱۶ خواهد بود.
Generatorها در پایتون
Generatorها در پایتون برای تولید دنبالهای از مقادیر استفاده میشوند. برخلاف تابعهای معمولی که معمولا با دستور return نتیجه را برمیگردانند، یک Generator میتواند با استفاده از دستور yield مقادیر مختلفی را بهتدریج تولید کند.
با هر بار درخواست مقدار بعدی، Generator اجرای خود را از همان نقطهای که متوقف شده بود ادامه میدهد و مقدار بعدی را برمیگرداند.
میتوان با استفاده از تابع next() مقدار بعدی یک Generator را دریافت کرد. هر بار که next() فراخوانی شود، اجرای Generator تا رسیدن به دستور yield بعدی ادامه پیدا میکند.
مثال زیر دنباله فیبوناچی را تا تعداد مشخصی از اعداد تولید میکند:
def get_fibonacci(x): x0 = 0 x1 = 1 for i in range(x): yield x0 temp = x0 + x1 x0 = x1 x1 = tempf = get_fibonacci(6)for i in range(6): print(next(f))خروجی:
0
1
1
2
3
5
در این مثال، هر بار که next(f) اجرا میشود، Generator مقدار بعدی دنباله فیبوناچی را تولید میکند. مزیت این روش آن است که لازم نیست تمام مقادیر از ابتدا در حافظه ذخیره شوند، مقادیر هنگام نیاز تولید میشوند.
نمونهای از Data Generator در Keras
یکی از کاربردهای Generatorها، تولید داده برای آموزش مدلهای یادگیری ماشین در Keras است.
این روش زمانی مفید است که نخواهیم تمام دادهها را یکجا در حافظه نگه داریم و ترجیح دهیم دادهها را درست زمانی تولید کنیم که حلقه آموزش به آنها نیاز دارد.
در Keras، مدلهای شبکه عصبی معمولا با استفاده از Batch آموزش داده میشوند، یعنی دادهها به دستههای کوچکتر تقسیم میشوند و هر بار یک دسته به مدل داده میشود. بنابراین، Generator میتواند هر بار یک Batch از دادهها را تولید کند.
تابع زیر از مقاله قبلی نویسنده با عنوان «استفاده از CNN برای پیشبینی سریهای زمانی مالی» گرفته شده است:
def datagen(data, seq_len, batch_size, targetcol, kind): "As a generator to produce samples for Keras model" batch = [] while True: # انتخاب یک DataFrame از مجموعه دادهها key = random.choice(list(data.keys())) df = data[key] input_cols = [c for c in df.columns if c != targetcol] index = df.index[df.index < TRAIN_TEST_CUTOFF] split = int(len(index) * TRAIN_VALID_RATIO) if kind == 'train': index = index[:split] # محدوده دادههای آموزش elif kind == 'valid': index = index[split:] # محدوده دادههای اعتبارسنجی # انتخاب یک موقعیت و استخراج یک دنباله از دادهها while True: t = random.choice(index) # انتخاب یک گام زمانی n = (df.index == t).argmax() # پیدا کردن موقعیت آن در DataFrame if n - seq_len + 1 < 0: continue # داده کافی برای تشکیل یک دنباله وجود ندارد frame = df.iloc[n-seq_len+1:n+1] batch.append([frame[input_cols].values, df.loc[t, targetcol]]) break # اگر تعداد نمونهها برای یک Batch کافی باشد، آن را ارسال کن if len(batch) == batch_size: X, y = zip(*batch) X, y = np.expand_dims(np.array(X), 3), np.array(y) yield X, y batch = []این تابع یک ردیف تصادفی از یک DataFrame در کتابخانه Pandas را بهعنوان نقطه شروع انتخاب میکند و تعدادی از ردیفهای متوالی را بهعنوان یک نمونه از بازه زمانی استخراج میکند. این فرایند چندین بار تکرار میشود تا نمونههای کافی برای تشکیل یک Batch جمعآوری شوند.
وقتی تعداد نمونهها به اندازه موردنیاز برسد، در خط یکیماندهبهآخر تابع، دستور yield، دادههای Batch را برمیگرداند.
احتمالا متوجه شدهاید که این تابع Generator از دستور return برای پایان دادن به تولید دادهها استفاده نمیکند. در این مثال، حلقه while True باعث میشود تابع به تولید Batch ادامه دهد. این رفتار برای فرایند آموزش Keras مفید است، چون اجازه میدهد آموزش مدل در تعداد Epochهای موردنیاز اجرا شود.
اگر از Generator استفاده نکنیم، باید تمام بازههای زمانی ممکن را از DataFrame استخراج کنیم و آنها را در حافظه نگه داریم. از آنجا که این بازهها با یکدیگر همپوشانی دارند، بخش زیادی از دادهها تکراری خواهد بود و حافظه بیشتری مصرف میشود.
استفاده از ImageDataGenerator در Keras
از آنجا که Generatorها کاربرد زیادی دارند، کتابخانه Keras ابزارهایی برای تولید داده در اختیار ما قرار میدهد. یکی از این ابزارها ImageDataGenerator() است.
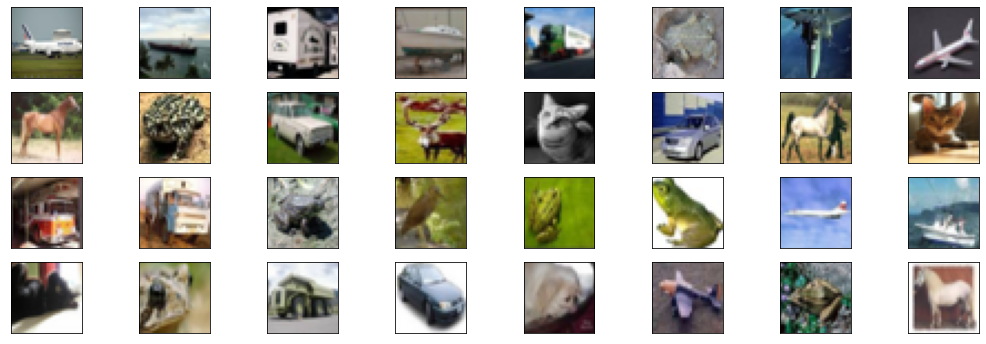
در مثال زیر، مجموعهداده CIFAR-10 را که شامل تصاویر ۳۲ در ۳۲ پیکسلی است، بارگذاری میکنیم. سپس با استفاده از متد flow()، دادهها را به Generator متصل میکنیم.
تابع next() دسته بعدی دادهها را برمیگرداند. در این مثال، چهار بار next() را فراخوانی میکنیم و در هر بار، ۸ تصویر دریافت میکنیم، زیرا اندازه Batch برابر با ۸ تعیین شده است.
کد کامل زیر، پس از هر فراخوانی next()، تصاویر دریافتشده را نیز نمایش میدهد:
(x_train, y_train), _ = keras.datasets.cifar10.load_data()datagen = ImageDataGenerator()data_iterator = datagen.flow(x_train, y_train, batch_size=8)fig, ax = plt.subplots( nrows=4, ncols=8, figsize=(18, 6), subplot_kw=dict(xticks=[], yticks=[]))for i in range(4): # دریافت ۸ تصویر از CIFAR-10 X, Y = data_iterator.next() for j, img in enumerate(X): ax[i, j].imshow(img.astype('int'))در این مثال، تصاویر بهصورت Batchهای ۸تایی از Generator دریافت میشوند و در یک نمودار با چهار ردیف نمایش داده میشوند. هر ردیف مربوط به یکی از چهار فراخوانی next() است.
جمعبندی
در این آموزش با چند ویژگی کاربردی زبان برنامهنویسی پایتون آشنا شدیم:
- List Comprehension و Dictionary Comprehension: روشهایی مختصر برای ساخت Listها و Dictionaryهای جدید، با امکان اعمال شرط روی عناصر.
- توابع
zip()وenumerate(): ابزارهایی برای پیمایش همزمان چند مجموعه و دسترسی به شمارنده عناصر. - Nested Functions و Function Context: تعریف توابع داخلی و حفظ دسترسی آنها به متغیرهای محیط بیرونی، حتی پس از پایان اجرای تابع بیرونی.
- Decoratorها: راهی برای توسعه یا تغییر رفتار توابع و کلاسها بدون تغییر مستقیم کد اصلی آنها.
- Generatorها: روشی برای تولید تدریجی مقادیر و کاهش نیاز به نگهداری تمام دادهها در حافظه.
- ImageDataGenerator در Keras: ابزاری برای آمادهسازی و تحویل Batchهای داده در فرایند آموزش مدلهای یادگیری ماشین.
درک این قابلیتها به شما کمک میکند کدهای پایتون را مختصرتر و خواناتر بنویسید و هنگام کار با مجموعهدادههای بزرگ و مدلهای یادگیری ماشین، از حافظه و منابع محاسباتی به شکل مؤثرتری استفاده کنید.
دیدگاهها
ثبت دیدگاه